
Примечание автора: доля сгенерированного ИИ кода выше 30% не означает, что команда стала быстрее выпускать результат. В статье разбираем, откуда взялся «теоретический предел в 7%», рассматриваем пять узких мест в процессе и предлагаем чек-лист для самопроверки команды.
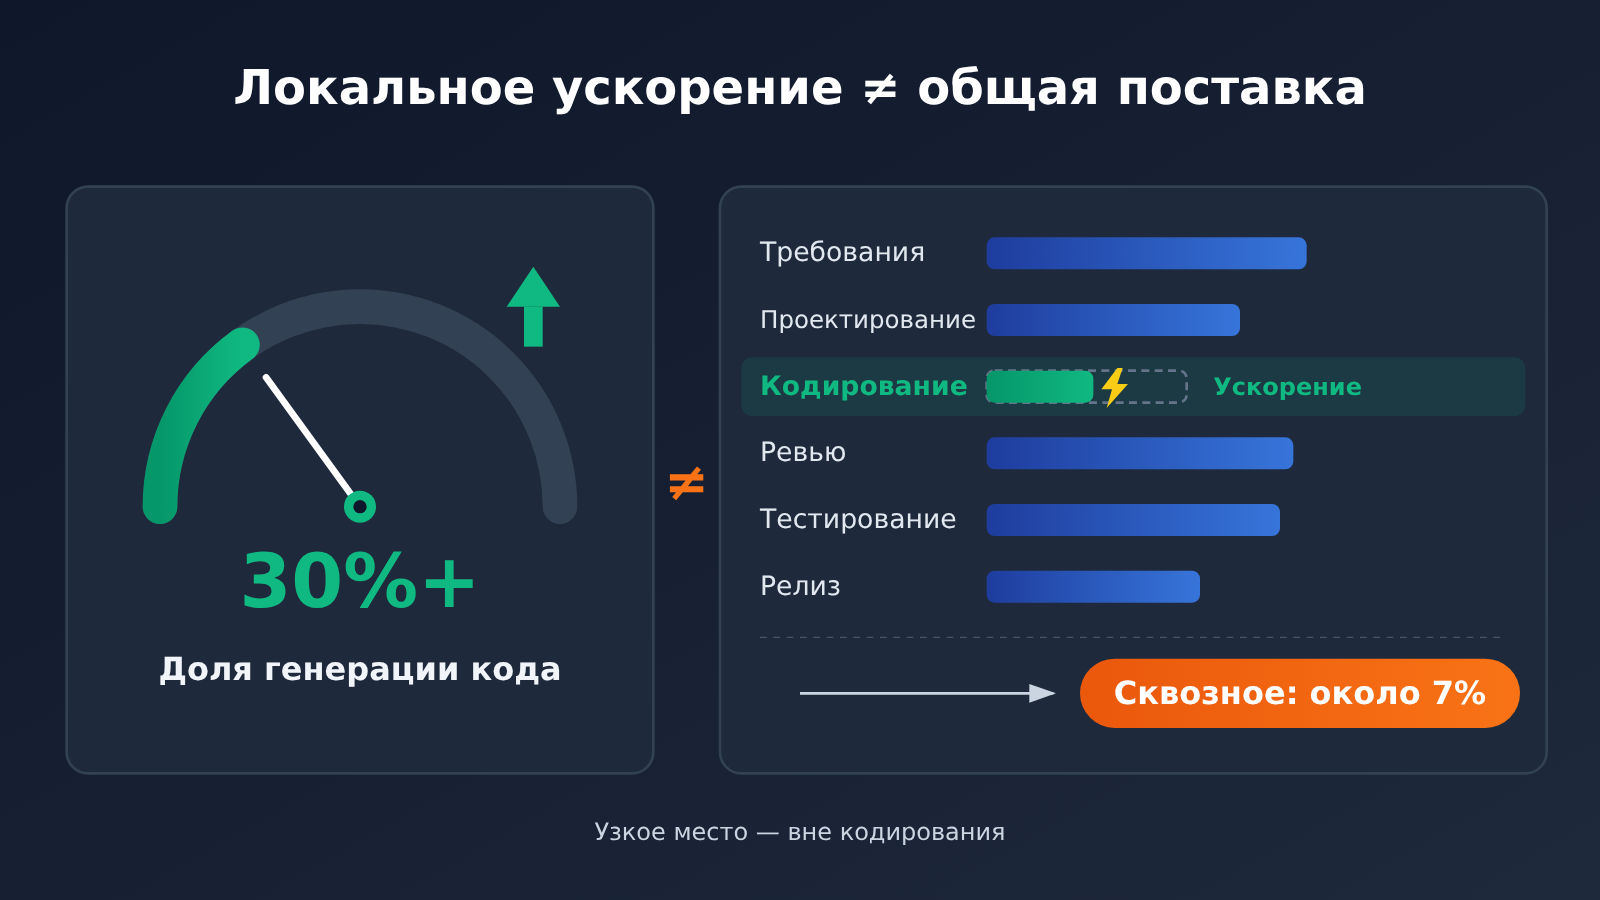
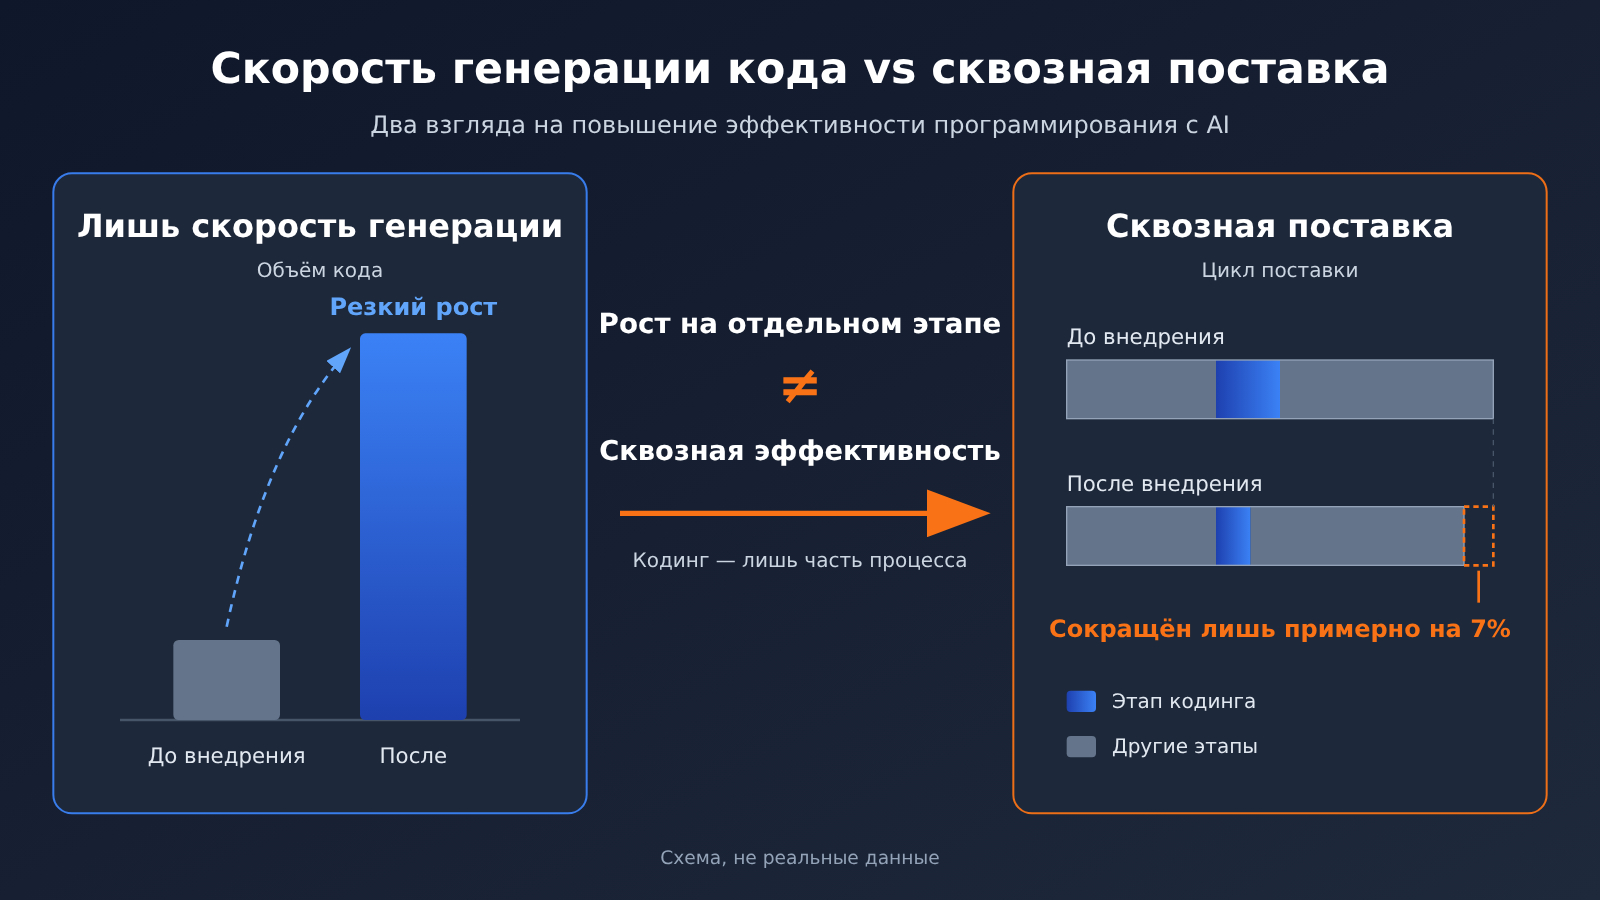
Сразу к главному: доля сгенерированного ИИ кода не равна скорости доставки. Когда она растёт с нескольких процентов до более чем 30%, увеличивается производительность только одного этапа — написания кода. А полный цикл доставки включает ещё согласование требований, проектирование, ревью, тестирование, интеграцию, выпуск и приёмку. Написание кода обычно занимает лишь часть этого цикла, поэтому, как бы ни росла доля сгенерированного кода, сократить сроки можно лишь в пределах доли времени, которая приходится на написание кода.
Это объясняет и недоумение многих технических руководителей: инструменты внедрили, отчёты о доле сгенерированного кода выглядят отлично, а сроки доставки почти не изменились. В одном отраслевом материале на основе разбивки затрат времени в конкретной команде рассчитали, что предел ускорения полного цикла составляет примерно 7%. Это не попытка преуменьшить пользу ИИ в программировании, а напоминание: доставку сдерживают пять узких мест за пределами написания кода. В статье разберём, как получили эти 7%, где применима эта оценка и как вашей команде проверить свой процесс.
Более 30% кода от ИИ и потолок в 7%: главное вкратце
Прежде чем перейти к расчётам, сведём ключевые данные в одну таблицу. Обратите внимание на источник и надёжность каждого числа: весь дальнейший анализ строится с учётом этих ограничений.
| Показатель | Значение | Как его понимать |
|---|---|---|
| Доля кода, созданного ИИ | Более 30% | Доля кода, сгенерированного ИИ; отражает только результат этапа написания кода |
| Потолок сквозного роста эффективности | Порядка 7% | Расчёт на основе распределения времени в конкретной команде, а не универсальный закон |
| Оценка из общения с представителями отрасли | Около 3–5% | Основана на обсуждениях, проверяемой выборки нет |
| Объём полезного кода | В 2–3 раза больше | Данные ретроспективы команды; критерии подсчёта и метод сравнения не раскрыты |
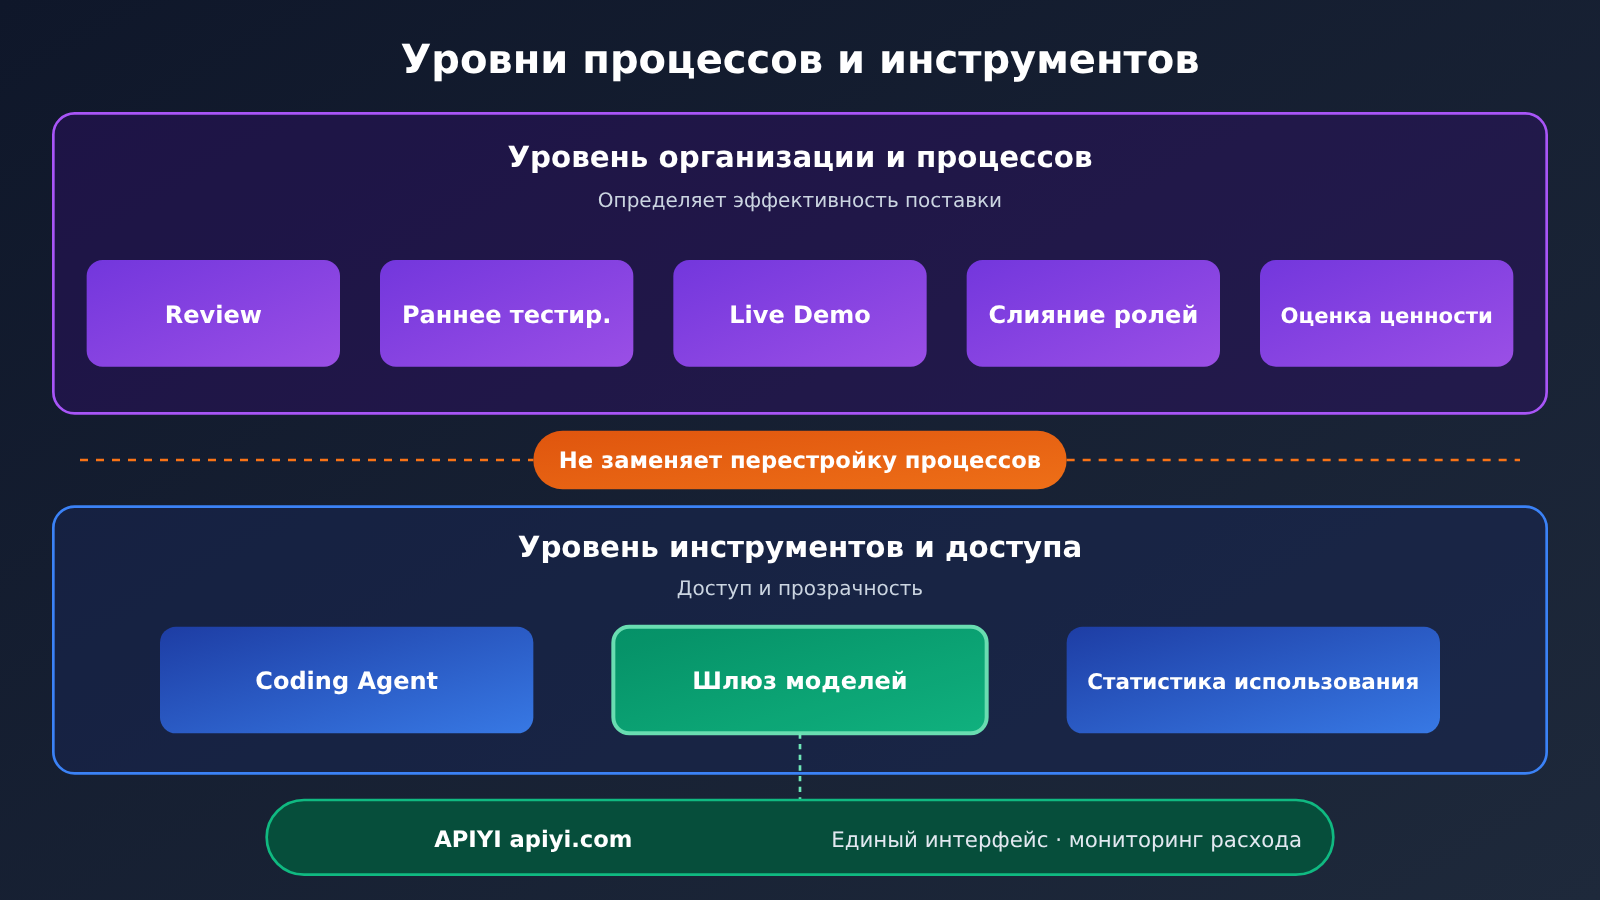
| Пять узких мест | Очередь на ревью, перенос тестирования и наблюдаемости на ранние этапы, Live Demo, сближение ролей, оценка ценности | Проблемы на уровне организации и процессов |
| Подключение Coding Agent | Можно подключить через агрегирующие интерфейсы, например APIYI apiyi.com | Упрощает подключение и мониторинг использования, но не устраняет узкие места процессов |
Эти цифры не противоречат друг другу. «В 2–3 раза больше полезного кода» относится к результатам написания кода, а «7%» и «3–5%» — к сквозной поставке. Первое — локальный показатель, вторые — общие, а между ними лежит вся цепочка поставки.
Откуда берётся предел в 7%: связь между скоростью генерации кода и долей времени на программирование
Разбираем формулу ускорения всего процесса
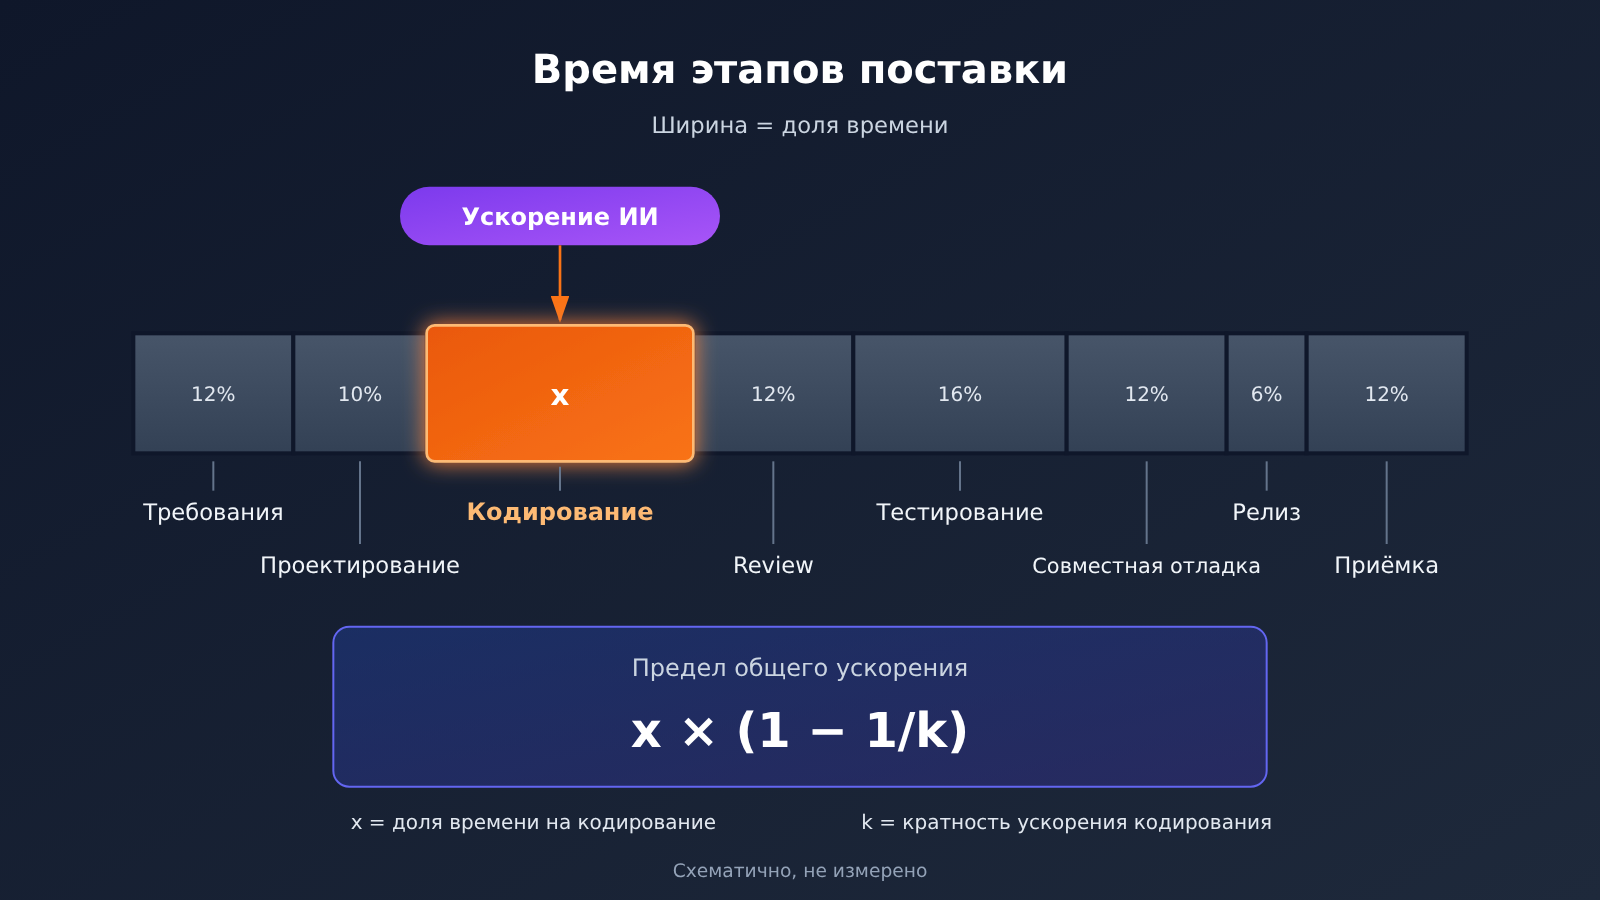
Верхнюю границу ускорения всего процесса доставки можно оценить по простой формуле: максимальное ускорение всего процесса ≈ x × (1 - 1/k). Здесь x — доля времени на программирование в общем времени доставки, а k — во сколько раз ускорилось программирование. По сути, это закон Амдала применительно к разработке: если ускорить только часть процесса, общий выигрыш будет ограничен её долей.
Рассмотрим пример. Допустим, программирование занимает 14% времени доставки, а ИИ ускоряет его вдвое (k = 2). Тогда получаем 14% × (1 - 1/2) = 7%. Даже если предположить, что время на программирование сократится до нуля (k стремится к бесконечности), весь процесс ускорится максимум на 14%. В таблице ниже приведены результаты расчётов для нескольких наборов параметров. Это лишь иллюстрации формулы, а не реальные замеры каких-либо команд.
Доля времени на программирование x |
Ускорение программирования k |
Максимальное сокращение времени всего процесса | Пояснение |
|---|---|---|---|
| 10% | 3 | Около 6,7% | Программирование в 3 раза быстрее, но общий выигрыш всё равно меньше 7% |
| 14% | 2 | 7% | Пример с результатом того же порядка, что и в исходной оценке |
| 20% | 1,5 | Около 6,7% | При небольшом ускорении программирования общий эффект быстро снижается |
| 20% | 2 | 10% | У команд, где программирование занимает больше времени, потенциал выше |
| 30% | 2 | 15% | Ситуация для команд, которые тратят много времени на программирование |
| 20% | Стремится к бесконечности | 20% | Теоретический предел при сокращении времени на программирование до нуля |
Доля кода, написанного AI, в 30% не означает ускорения на 30%
Есть ещё одно распространённое заблуждение: доля кода, написанного AI, и k — не одно и то же. Первый показатель говорит о том, «какую часть кода написал AI», а k — о том, «насколько сократилось время на написание кода». Сгенерированный AI код всё равно нужно читать, отлаживать и изменять. Сама генерация тоже требует времени: нужно написать промпт, дождаться результата и исправить ошибки.
Даже если предельно упростить ситуацию и предположить, что на 30% кода, сгенерированного AI, вообще не ушло времени, ускорение написания кода составит лишь 1 / (1 - 0.3) ≈ 1.43. А с учётом доли написания кода в общем времени выигрыш на всём пути от задачи до результата окажется ещё меньше. Поэтому оценка порядка 7% в материалах не выглядит странной. Скорее, она показывает, что ключ к ускорению — не в том, чтобы «генерировать больше кода», а в этапах за пределами написания кода.
Ещё раз подчеркнём: 7% — это расчёт на основе распределения времени в конкретной команде. Доля времени на написание кода, стабильность требований и система тестирования у вашей команды могут быть другими, поэтому результат может оказаться как выше, так и ниже. Ценность этой оценки — в подходе к рассуждению, а не в готовом выводе, который можно применить к любой команде.
5 причин, почему поставка не ускорилась: что мешает помимо скорости генерации кода
Когда код пишется быстрее, нагрузка смещается на следующие этапы разработки. Из пяти описанных ниже проблем одни возникли или обострились из-за использования ИИ, а другие существовали всегда — просто раньше их скрывала скорость написания кода.
Проблема 1: очередь на ревью у ключевых разработчиков
Чем больше кода генерирует ИИ, тем больше кода нужно проверять. Ревью часто ложится на плечи нескольких ключевых разработчиков: им нужно разобраться в бизнес-контексте, оценить граничные случаи и потенциальные риски кода, написанного ИИ. В результате значительная часть времени, сэкономленного на написании кода, уходит на ожидание в очереди на ревью.
Ситуацию осложняет и то, что код ИИ «выглядит правильным». Проверяющим приходится читать его внимательнее, поэтому затраты на ревью каждой единицы кода не обязательно снижаются. Если не изменить процесс — например, не ввести уровни проверки, не определить, какие изменения могут одобрять другие разработчики, и не передать проверку стандартов автоматическим инструментам, — ключевые разработчики станут главным узким местом во всей цепочке.
Узкое место 2: перенос тестирования и наблюдаемости на ранние этапы
Во многих командах тестирование, мониторинг и наблюдаемость подключаются только на поздних этапах разработки. Когда код начинают писать быстрее, проблемы быстрее накапливаются к этапу тестирования, а переделок становится больше и они сосредоточиваются в одном месте. Если тест-кейсы, сбор метрик и правила оповещения не продумывать до или во время написания кода, последующая интеграционная проверка и исправления сведут на нет выигрыш во времени.
Суть переноса тестирования и наблюдаемости на ранние этапы — в том, чтобы проверять код одновременно с его написанием. Для кода, созданного ИИ, это особенно важно: нужны тесты, которые можно запустить и быстро выяснить, правильно ли работает результат, не проверяя каждую строку вручную.
Узкое место 3: подтверждайте требования с помощью Live Demo, чтобы меньше переделывать
Самое дорогое в процессе разработки — зачастую не написание кода, а исправление того, что сделали не так. Если требования поняли неправильно, приходится заново проходить все этапы: написание кода, ревью и тестирование. Теперь, когда ИИ удешевил написание кода, его можно использовать с большей пользой: быстро сделать работающий Live Demo и дать заказчику проверить в реальном взаимодействии, соответствует ли результат его ожиданиям.
По сути, это замена согласования документации на проверку прототипа. Документ каждый может понять по-своему, а работающий Demo помогает вовремя обнаружить разногласия. Настоящая выгода от снижения стоимости разработки может заключаться не в том, чтобы быстрее написать итоговый код, а в том, чтобы дешевле проверять идеи и исправлять ошибки.
Узкое место 4: объединение ролей и изменение роли PDFE и ABE
В традиционном процессе между специалистами по продукту, дизайну, фронтенду, бэкенду и тестированию постоянно происходит передача задач. Каждая такая передача означает ожидание, потерю контекста и повторное согласование. Упомянутое в материалах объединение ролей PDFE, ABE и других по сути позволяет одному человеку или небольшой команде охватить больше этапов работы и сократить число передач.
Когда ИИ берёт на себя большую часть написания кода, у инженеров появляется возможность подключаться к работе с требованиями и тестированию — и объединение ролей становится реальным. Но важно учитывать: пока недостаточно данных об условиях и затратах, необходимых для внедрения таких организационных изменений в командах разного размера. Небольшим командам такой подход может подойти сам по себе, а крупным организациям придётся системно менять зоны ответственности, оценку работы и способы взаимодействия. Просто скопировать его не получится.
Узкое место 5: оценка ценности, словарь понятий и SDD
Если понятия и определения данных не согласованы, то чем быстрее ИИ пишет код, тем быстрее он допускает ошибки. Один и тот же бизнес-термин может иметь разные значения в разных модулях, а поля интерфейсов — определяться по-разному. Все эти проблемы разом проявляются на этапе интеграционного тестирования и приёмки. В материалах предлагается сначала оценить ценность задачи, затем согласовать понятия и данные с помощью словаря понятий и SDD (разработки на основе спецификаций), а уже после этого писать код.
Оценка ценности отвечает на вопрос «стоит ли вообще это делать», а словарь понятий и SDD — на вопрос «об одном ли и том же мы говорим». Может показаться, что эти два шага увеличивают затраты на старте, но они дают ИИ чёткий и непротиворечивый контекст. Благодаря этому сгенерированный код с большей вероятностью будет соответствовать требованиям с первой попытки.
5 узких мест и способы их устранения
| Узкое место | Типичные признаки | Рекомендуемые действия | Метрика |
|---|---|---|---|
| Очередь на ревью у ключевых специалистов | PR дольше ждут проверки, ключевые специалисты перегружены | Разделить ревью по уровням, автоматизировать проверку стандартов | Среднее время ожидания PR |
| Позднее подключение тестирования и наблюдаемости | Основной объём переделок приходится на этап тестирования | Заранее проектировать тестовые сценарии и точки сбора данных | Количество возвратов на доработку из-за дефектов на этапе тестирования |
| Согласование требований через Live Demo | При приёмке выясняется, что «нужно было не это» | Согласовывать требования с помощью работающего прототипа | Количество изменений требований и переделок |
| Разделение ролей | Много передач задач и ожидания, теряется контекст | Сократить количество передач, расширить зону ответственности одного специалиста | Количество передач между этапами |
| Оценка ценности и словарь понятий/SDD | При интеграционном тестировании обнаруживаются расхождения в трактовках | Согласовать понятия и данные до начала разработки | Количество проблем на этапе интеграционного тестирования |
Самопроверка команды: как оценить время доставки и пользу от роста скорости генерации кода
Вместо того чтобы спорить о 7% или 3–5%, лучше посчитать показатели своей команды. Вот метод, который можно сразу применить на практике. Для начала попробуйте его на небольшом проекте.
- Разбейте процесс на этапы: проследите путь задачи от появления до запуска — требования, проектирование, написание кода, ревью, тестирование, интеграционное тестирование, релиз и приёмка. Запишите фактическое время работы и время ожидания на каждом этапе.
- Рассчитайте долю написания кода: разделите время, потраченное на кодирование, на общее время доставки. Полученное значение — ваш
x. Многие команды обнаружат, что эта доля меньше, чем они думали. - Найдите ожидание и переделки: отдельно посчитайте время ожидания ревью, количество возвратов на доработку после тестирования и число изменений требований. Зачастую именно здесь скрывается основная потеря времени.
- Отделите объём работы от ценности: рассматривайте «объём написанного кода» и «ценность, которую можно доставить» отдельно. Скорость генерации кода и число строк в коммитах относятся к первому, а количество запущенных функций и цикл доставки — ко второму.
- Проведите небольшое сравнение: на примере маленького проекта сравните показатели до и после внедрения. Не ограничивайтесь отчётами о скорости генерации кода.
- Сначала устраните главное узкое место: найдите этап, который занимает больше всего времени, и займитесь им в первую очередь. Не стоит одновременно внедрять все инструменты и менять все процессы.
Ниже — условный шаблон разбивки времени. Он показывает, как заполнять таблицу, и не отражает реальные данные какой-либо команды. Подставьте свои цифры, чтобы увидеть, какую долю занимает написание кода.
| Этап доставки | Примерная доля (условно) | Основные затраты времени | Может ли AI-программирование напрямую ускорить этап |
|---|---|---|---|
| Обсуждение требований и ценности | 15% | Повторные обсуждения, согласование деталей | Косвенно (Live Demo) |
| Проектирование | 10% | Обсуждение и ревью решений | Частично |
| Написание кода | 15% | Разработка, отладка | Да, напрямую |
| Ревью | 15% | Ожидание в очереди, проверка | Частично (помощь при ревью) |
| Тестирование и интеграционное тестирование | 25% | Выполнение тестовых сценариев, переделки | Частично (генерация тестовых сценариев) |
| Релиз и приёмка | 20% | Согласования, обратная связь по результатам приёмки | В очень малой степени |
Этот шаблон помогает увидеть структуру процесса: если на написание кода приходится всего чуть больше десяти процентов времени, то даже дальнейшее удвоение скорости его генерации даст ограниченный эффект для всего цикла доставки. Основные возможности для ускорения лежат в ревью, тестировании и работе с требованиями.
Подключение Coding Agent и анализ расхода: что может и чего не может APIYI
При внедрении AI-инструментов для программирования не обойтись без настройки доступа и контроля расходов. APIYI apiyi.com поддерживает подключение таких инструментов, как Cursor и Cline, и предоставляет единый OpenAI-совместимый интерфейс: с одним API-ключом можно вызывать популярные модели OpenAI, Claude, Gemini и другие. Для подключения достаточно установить в настройках инструмента base_url равным https://api.apiyi.com/v1.
Для команд, отвечающих за эффективность разработки, особенно полезны данные об использовании. В статистике консоли можно отслеживать расход токенов Coding Agent и распределение вызовов между моделями, чтобы понять, для каких задач нужна более мощная модель, а где достаточно лёгкой. Эти данные можно сопоставить с рассмотренной выше разбивкой времени поставки и оценить соотношение затрат на AI-программирование и полученных результатов.
💡 Совет по подключению: если команда оценивает сразу несколько моделей для программирования, APIYI apiyi.com позволит подключить их через единый интерфейс и сравнить расход. Новым пользователям доступен бесплатный тестовый лимит — можно начать со сравнительного эксперимента на небольшом проекте. Точные цены и доступность моделей уточняйте в консоли и документации.
Но важно понимать: сам по себе шлюз не повышает эффективность всего процесса поставки. Он упрощает подключение, переключение между моделями и отслеживание расхода. А такие узкие места, как очередь на ревью, доработки после тестирования и расхождения с требованиями, можно устранить только на уровне организации процессов. Считать шлюз решением для повышения эффективности — та же ошибка, что использовать скорость генерации кода как показатель эффективности поставки.
Частые вопросы FAQ
Q1: Почему доля сгенерированного кода превышает 30%, а весь процесс поставки ускорился лишь примерно на 7%?
Потому что генерация кода ускоряет только этап программирования. Верхняя граница ускорения всего процесса составляет примерно `x × (1 — 1/k)`. Если доля программирования `x` сама по себе невелика, эффект будет ограничен. При этом 7% — расчёт для конкретной команды с учётом распределения её времени, а не универсальный показатель. Вашей команде нужно провести собственный расчёт.
Q2: Можно ли доверять цифрам 3%-5% и 2-3 раза?
К обеим стоит относиться с осторожностью. Оценка ускорения всего процесса на 3%-5% появилась в ходе обсуждений в индустрии, но проверяемых данных для неё нет. Увеличение объёма полезного кода в 2-3 раза взято из обзора работы команды, но критерии подсчёта и метод сравнения не раскрыты. Эти цифры можно использовать как ориентир, но не стоит напрямую опираться на них при принятии решений.
Q3: Какое из 5 узких мест стоит устранить в первую очередь?
Сначала разберитесь, на что уходит время при поставке, и займитесь самым затратным этапом. Многие команды обнаруживают, что больше всего времени уходит на ожидание ревью и доработки после тестирования. У других главная проблема — изменения требований. Не стоит внедрять все изменения одновременно: устраняйте по одному самому крупному узкому месту, так будет проще оценить результат.
Q4: Как отслеживать использование моделей и расходы команды на Coding Agent?
Можно подключить инструменты для программирования через единую точку доступа к API, а затем отслеживать расход токенов и распределение запросов по моделям в консоли. Например, подключив Cursor, Cline и другие инструменты через APIYI apiyi.com, можно централизованно просматривать данные об использовании. Но это лишь помогает принимать решения — узкие места в процессах по-прежнему нужно устранять на уровне организации.
Q5: Подходит ли объединение ролей всем командам?
Не обязательно. Идея объединения ролей, например в PDFE и ABE, состоит в том, чтобы сократить количество передач задач между участниками. Но данных об условиях и затратах на такие изменения в командах разного размера недостаточно. Лучше сначала запустить пилот в одной группе, посмотреть, как изменятся количество передач задач и цикл поставки, а затем решить, стоит ли распространять подход дальше.
Скорость написания кода и сквозная поставка: главное
- Скорость написания кода не равна скорости поставки: она отражает результат только на этапе кодирования, а не повышение эффективности всего процесса.
- 7% получены расчётным путём:
x × (1 - 1/k). Доля времени на кодирование задаёт верхнюю границу возможного выигрыша. - Важно различать цифры: 7% — расчёт для конкретной команды, 3%-5% — оценка по итогам обсуждений, а методика расчёта показателя в 2-3 раза не раскрыта.
- Узкие места находятся за пределами кодирования: больше всего времени уходит на ревью, тестирование, уточнение требований, передачу задач и согласование понятий.
- Сначала разберите затраты времени, затем меняйте процесс: сравните результаты на небольших проектах и за один раз устраняйте только самое серьёзное узкое место.
- Инструменты помогают с подключением и наблюдением: APIYI apiyi.com позволяет подключать Coding Agent через единую точку и отслеживать использование, но не решает проблемы процессов.
Итоги: что делать команде, когда доля сгенерированного кода превысила 30%
Доля сгенерированного кода выше 30% — реальный прогресс, но это лишь отправная точка. Итоговая скорость поставки зависит от всей цепочки работ, а написание кода — только её часть. Формула x × (1 - 1/k) наглядно показывает предел выигрыша от ускорения отдельного этапа. Цифра 7% важна не столько своей точностью, сколько тем, что напоминает: стоит смотреть не на то, «сколько кода написано», а на то, «сколько ценности доставлено».
Основные возможности повысить эффективность лежат в организации ревью, переносе тестирования и наблюдаемости на ранние этапы, согласовании требований с помощью работающих демо, сокращении числа ролей в процессе, а также оценке ценности и согласовании понятий. Всё это касается организации работы и процессов — никакой инструмент их не заменит. Из инструментов рекомендуем использовать APIYI apiyi.com для единого доступа к моделям для программирования и отслеживания их использования. Оценивать отдачу от вложений стоит, сопоставляя данные об использовании со временем поставки.
Чек-лист для команды
- [ ] Разобрали ли вы, сколько времени занимает весь путь задачи от постановки до запуска?
- [ ] Рассчитали ли вы долю этапа написания кода в общем времени поставки —
x? - [ ] Учитываете ли вы отдельно время ожидания ревью и нагрузку на ключевых специалистов?
- [ ] Проектируются ли тест-кейсы, точки сбора данных и оповещения до начала написания кода или параллельно с ним?
- [ ] Используете ли вы для согласования требований работающее демо, а не только документы?
- [ ] Сколько раз задача передаётся между участниками с разными ролями на пути от постановки до запуска?
- [ ] Согласованы ли до начала написания кода основные понятия и правила расчёта показателей (словарь понятий/SDD)?
- [ ] Различают ли показатели в отчётах «объём написанного кода» и «ценность, готовую к поставке»?
- [ ] Проводили ли вы сравнение до и после на небольшом проекте, а не просто смотрели отчёты о доле сгенерированного кода?
- [ ] Выбрали ли вы одно главное узкое место для улучшения в первую очередь, вместо того чтобы внедрять все инструменты сразу?
Источники
- Отраслевые материалы о доле сгенерированного кода и сквозной поставке: источник расчёта 7%, пяти узких мест и правил расчёта показателей, приведённых в статье
- Примечание: материалы были обрезаны, поэтому статья основана только на доступной части; невидимое содержимое не учитывалось
- Центр документации APIYI: инструкции по подключению инструментов для программирования и учёту использования
- Ссылка:
docs.apiyi.com - Примечание: актуальные цены и доступность моделей уточняйте в консоли и документации
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами через главную страницу APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com


