
Примечание автора: новость о том, что Apple снизила ежедневный бюджет инженеров на токены с 300 до 200 долларов, — повод разобрать четыре механизма управления расходами на вызовы ИИ: уровни бюджетов, согласование исключений, распределение задач между моделями и мониторинг использования.
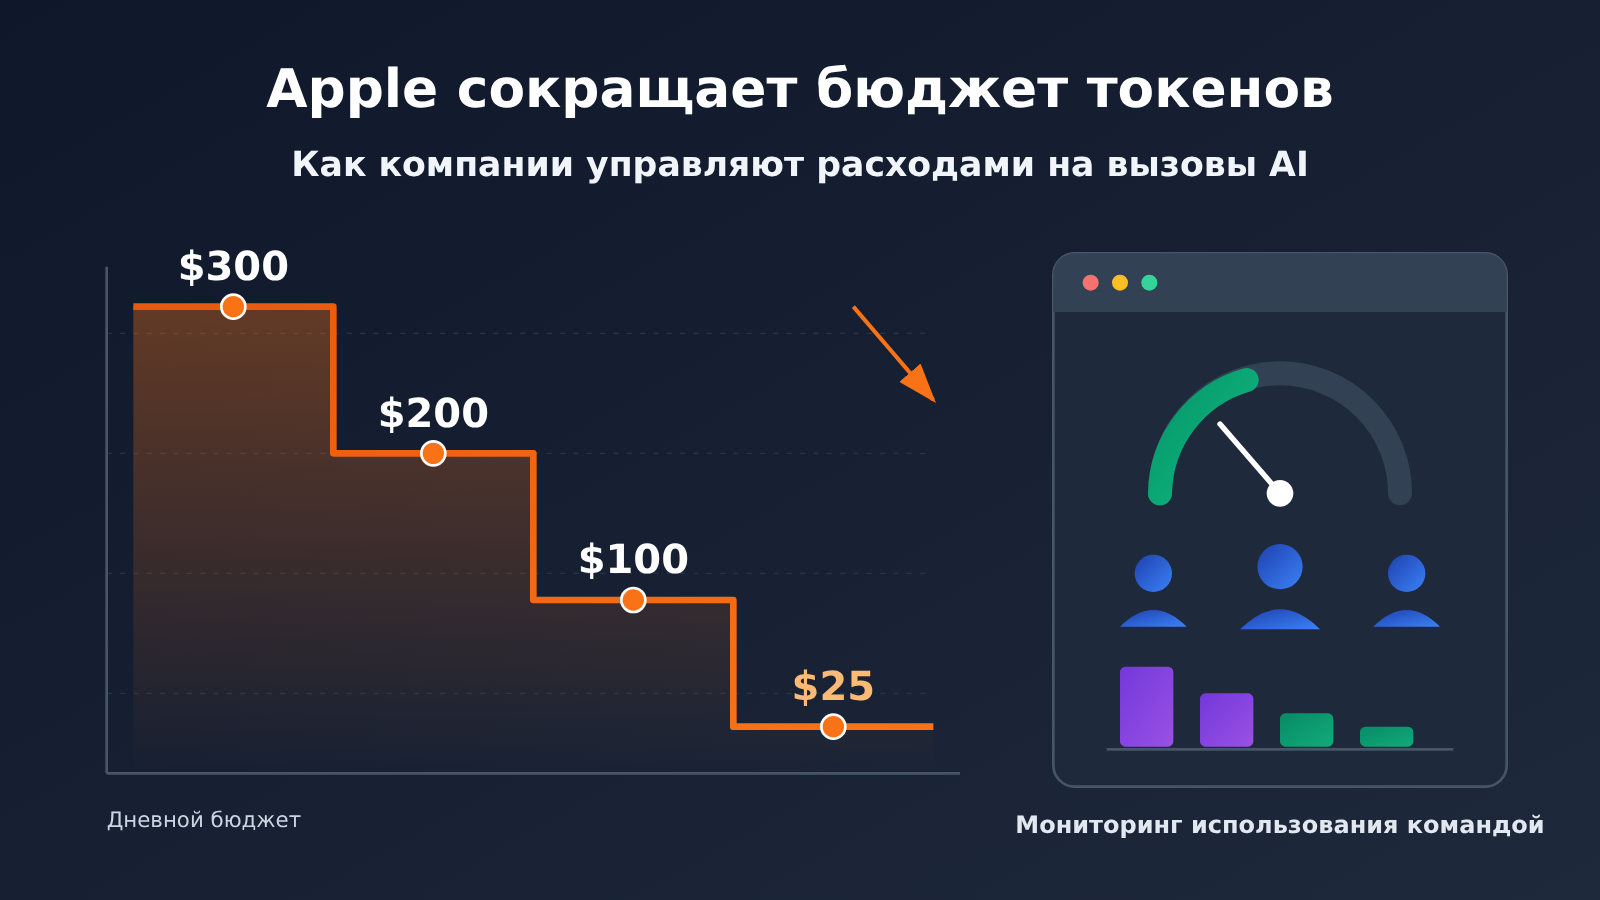
По данным Bloomberg, в прошлом месяце Apple снизила ежедневный бюджет на токены для части инженеров с 300 до 200 долларов. В дальнейшем компания планирует сократить его до 100 долларов в день, а некоторым нетехническим командам может достаться всего 25 долларов. Сотрудники, которым нужно больше, могут запросить исключение у руководства. Некоторым командам также предложат перейти на более дешёвые модели или локальный ИИ, работающий на устройстве.
Это не слухи. 5 ноября 2026 года The Decoder привёл эти цифры со ссылкой на Bloomberg и отметил, что Microsoft, Tesla, Uber и Meta также недавно установили лимиты на внутренние расходы на ИИ. Крупные компании переходят от принципа «используйте сколько хотите» к работе в рамках бюджета — и это говорит о том, что руководству уже пора вплотную заняться расходами на вызовы ИИ.
Что вы узнаете: прочитав статью, вы разберётесь, как именно Apple сокращает бюджеты на токены, и получите готовую схему управления расходами на вызовы ИИ в компании. Она включает уровни бюджетов, согласование исключений, распределение задач между моделями и мониторинг использования.
Apple сокращает бюджет на токены: главное
| Пункт | Подробности |
|---|---|
| Источник | Bloomberg; пересказ The Decoder от 2026-11-05 |
| Кого затронули изменения | Часть инженеров и некоторые нетехнические команды |
| Уже введённые изменения | В прошлом месяце дневной бюджет на токены сократили с 300 до 200 долларов |
| Дальнейшие планы | Возможно сокращение до 100 долларов в день, а для некоторых нетехнических команд — до 25 долларов |
| Превышение лимита | Сотрудники могут попросить руководство сделать исключение |
| Доступные модели | Anthropic Claude, OpenAI ChatGPT, Google Gemini и другие |
| Альтернативы | Некоторые команды переходят на более дешёвые модели или локальный ИИ на устройствах |
| Причины | Новый CEO John Ternus стремится оптимизировать расходы; в 2026 финансовом году расходы на исследования и разработки выросли на 32% главным образом из-за затрат на инфраструктуру и ИИ |
| Ситуация в отрасли | Microsoft, Tesla, Uber и Meta тоже недавно ограничили внутренние расходы на ИИ |
Три детали сокращения бюджета на токены в Apple
Первая деталь: бюджет рассчитывается на человека в день. Apple не просто выделяет отделу общую годовую сумму, а устанавливает лимит для каждого сотрудника на каждый день. Такой подход позволяет каждому видеть стоимость своих запросов к ИИ, а руководству — распределять ресурсы в зависимости от должности.
Вторая деталь: для технических и нетехнических команд устанавливают разные лимиты. Целевой лимит инженеров составляет около 100 долларов, а некоторые нетехнические команды могут получить лишь 25 долларов — в четыре раза меньше. Похоже, Apple считает, что расход токенов при написании кода и работе с ИИ-агентами несопоставим с расходом при написании писем и подготовке кратких сводок.
Третья деталь: лимит не является жёстким потолком. Сотрудники могут попросить об исключении, а некоторые команды направляют к более дешёвым или локальным моделям. Суть подхода не в том, чтобы «меньше пользоваться ИИ», а в том, чтобы оставить дорогие вычислительные ресурсы для задач, которые того стоят. Впрочем, в публикации не раскрывается, как Apple разделяет модели по уровням и как именно применяет лимиты. Этих подробностей придётся подождать.
Почему стоимость вызовов AI заставляет крупные компании сокращать бюджеты на токены
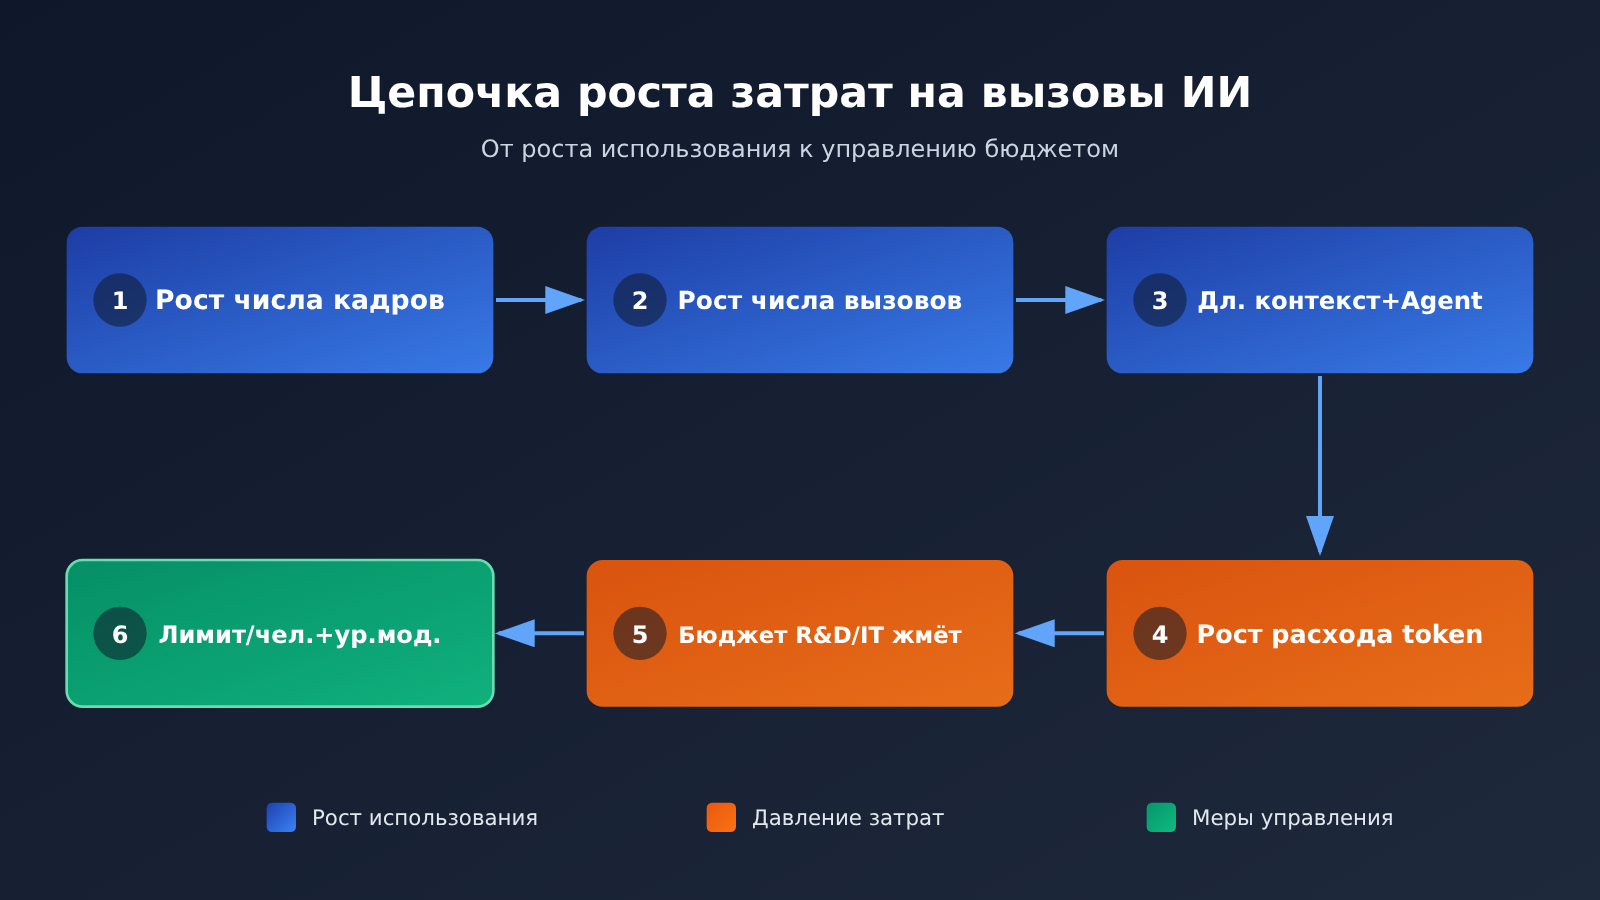
Главное отличие расходов на вызовы AI от расходов на обычную подписку на ПО — оплата по фактическому использованию и ненулевая стоимость каждого дополнительного обращения. Если сотрудник 100 раз в день открывает один и тот же SaaS-инструмент, стоимость не меняется. Но если он 100 раз в день отправляет большой языковой модели длинные документы, каждый запрос приносит реальные расходы на токены. Когда число пользователей достигает десятков тысяч, затраты быстро растут.
Расходы Apple на исследования и разработки в 2026 финансовом году выросли на 32%. В публикациях прямо указывается, что одной из причин стали более высокие затраты на инфраструктуру и AI. На фоне сокращения расходов, которое проводит новый CEO, внутренние расходы на AI стали статьёй, которую легко измерить и скорректировать. Microsoft, Tesla, Uber, Meta и другие компании примерно в то же время тоже ввели ограничения — а значит, это не случайное решение одной компании.
Судя по реакции внутри компании, некоторые сотрудники считали прежние лимиты слишком щедрыми: большинству специалистов было трудно израсходовать дневной бюджет в 300 долларов. Это указывает на распространённую проблему: многие компании на начальном этапе внедрения AI устанавливают лимиты без расчётов, а их последующее сокращение легко вызывает споры.
4 механизма управления расходами на вызовы AI в корпоративной команде
Если разобрать подход Apple, можно выделить 4 механизма, которые подойдут и другим компаниям. Они работают вместе: бюджет задаёт границы, согласование сохраняет гибкость, разделение по уровням снижает расходы, а мониторинг помогает соблюдать правила.
Механизм первый: бюджет токенов по ролям
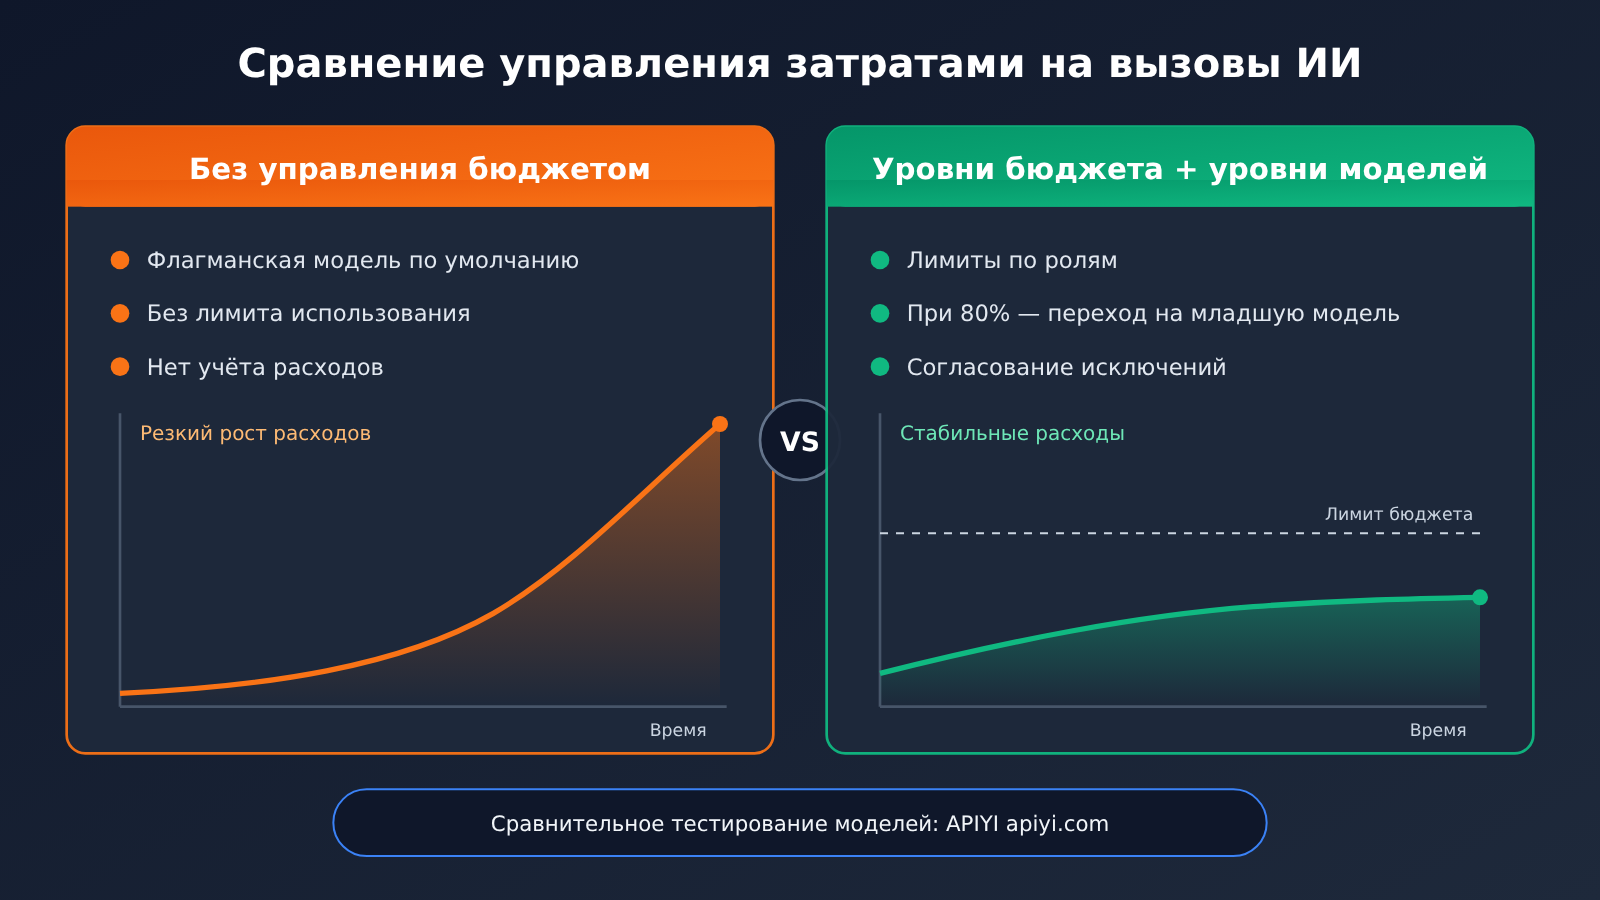
Главное в распределении бюджета на сотрудника — не усреднение, а разделение по уровням. Специалисты разных ролей используют AI по-разному: единый лимит либо окажется недостаточным для инженеров, либо будет подолгу оставаться невостребованным у тех, кто пользуется AI редко. В таблице ниже приведён пример распределения по уровням на основе подхода Apple. Конкретные суммы стоит рассчитать с учётом того, как ваша команда использовала AI раньше.
| Уровень роли | Типичные задачи | Подход к бюджету | Уровень моделей по умолчанию |
|---|---|---|---|
| Ключевые специалисты по разработке | Генерация кода, программирование с агентами, анализ длинных документов | Высокий лимит с расчётом на день, можно запросить исключение | Флагманские модели + модели среднего уровня |
| Другие технические специалисты | Ревью кода, написание скриптов, техническая документация | Средний лимит, близкий к уровню для инженеров в планах Apple | Преимущественно модели среднего уровня |
| Нетехнические специалисты | Письма, краткие отчёты, переводы, систематизация материалов | Низкий лимит, с ориентиром на уровень Apple от 25 долларов | Преимущественно лёгкие модели |
| Пилотные / новые проекты | Проверка новых идей | Временный целевой лимит с установленным сроком | Доступ по потребности |
При распределении по уровням сначала изучите фактическое использование за последние 1–3 месяца: медианные и высокие значения для каждой роли. Затем установите бюджет выше медианы, но ниже высоких значений. Так большинству сотрудников лимита хватит для повседневных задач, а немногие активные пользователи смогут запросить исключение. Это позволит свести расходы на управление к минимуму.
Механизм второй: согласование исключений вместо жёстких ограничений для всех
Apple позволяет сотрудникам, превысившим лимит, запрашивать исключение у руководства — этот подход стоит взять на заметку. Жёсткий лимит может остановить важную задачу на полпути, а полное отсутствие ограничений лишает бюджет смысла. При согласовании исключений можно опираться на несколько правил:
- Чётко определить условия: например, дневной лимит исчерпан или проект требует интенсивных вызовов моделей в течение нескольких дней;
- Ограничить срок действия: выделять дополнительный лимит на день или на конкретный проект и автоматически отзывать его по истечении срока, чтобы «временное» не превратилось в «постоянное»;
- Просить краткое обоснование: указать тип задачи и ожидаемый результат, чтобы позже оценить, оправдали ли себя затраты на вызовы моделей;
- Подводить итоги каждый месяц: если один и тот же сотрудник или команда часто запрашивает исключения, значит, базовый бюджет слишком мал. В таком случае лучше пересмотреть уровень лимита, а не согласовывать исключения снова и снова.
Механизм третий: разделение моделей по уровням и автоматическое переключение
В публикации говорится, что Apple переводит часть команд на более дешёвые модели или локальный AI на устройствах. В основе этого подхода — один из самых эффективных способов снизить затраты на вызовы моделей: подбирать модель по сложности задачи. Со многими повседневными задачами справятся лёгкие модели, и лишь для некоторых сложных задач действительно нужны флагманские.
| Уровень модели | Подходящие задачи | Особенности стоимости | Доступные платформы |
|---|---|---|---|
| Флагманские модели (например, старшие модели Claude, GPT и Gemini) | Сложные рассуждения, изменение кода в нескольких файлах, анализ важных решений | Самая высокая цена за вызов; использовать по необходимости | APIYI apiyi.com, официальные API разных провайдеров |
| Модели среднего уровня | Обычное программирование, технические тексты, извлечение структурированных данных | Баланс качества и стоимости | APIYI, официальные API разных провайдеров |
| Лёгкие модели | Создание кратких резюме, перевод, классификация, форматирование | Низкая цена за вызов, подходят для частого использования | APIYI, официальные API разных провайдеров |
| Модели на устройстве / локальные модели | Задачи с конфиденциальными данными, работа без сети, простое автодополнение | Нет оплаты за объём использования, но есть расходы на оборудование и обслуживание | Локальное развёртывание |
Типичное правило автоматического переключения выглядит так: когда расходы достигают определённой доли бюджета (например, 80%), некритичные задачи автоматически переводятся на модель следующего уровня. После исчерпания лимита остаются только лёгкие модели либо запускается согласование исключения. Так сотрудники не останутся внезапно без доступа, а работа будет идти без резких перебоев. Фактическая разница в ценах зависит от текущих тарифов платформ, поэтому перед внедрением стоит самостоятельно всё рассчитать.
💡 Совет по выбору: разделение моделей по уровням предполагает, что между моделями разных провайдеров можно легко переключаться. Через агрегатор вроде APIYI apiyi.com с одним API-ключом можно вызывать модели OpenAI, Claude, Gemini и других провайдеров. Интерфейс совместим с форматом OpenAI, поэтому при маршрутизации между уровнями достаточно изменить параметр model.
Механизм четвёртый: мониторинг расхода помогает соблюдать бюджет
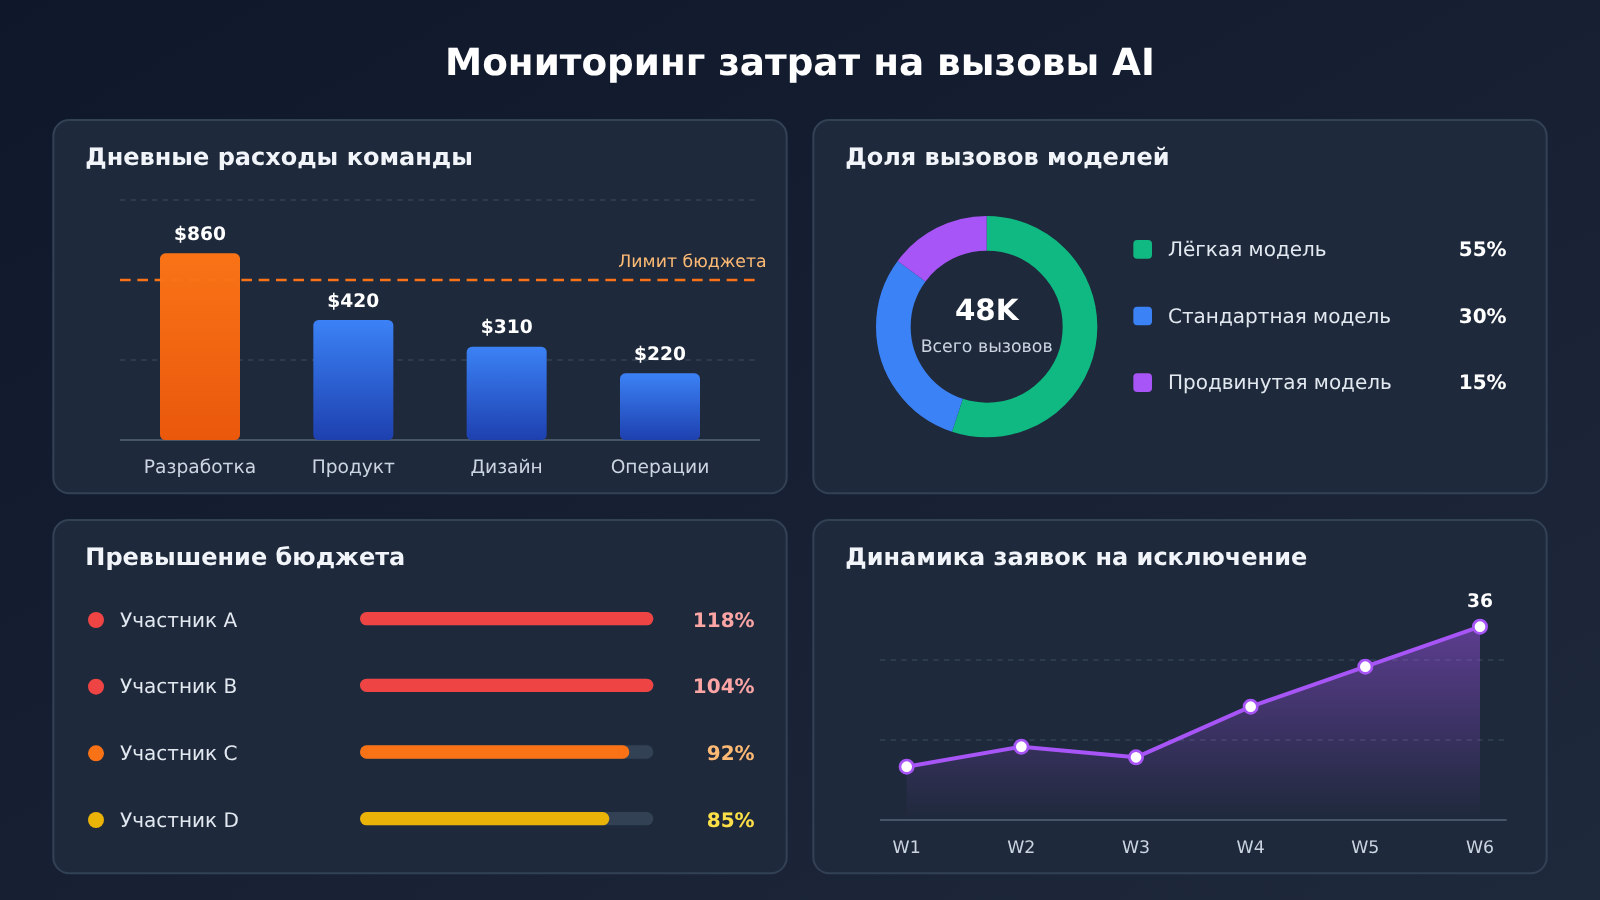
Без мониторинга бюджет токенов на сотрудника останется лишь формальным правилом. Мониторинг нужен не только для выявления перерасхода: ещё важнее, что он даёт данные для распределения бюджетов и моделей по уровням. Рекомендуем отслеживать как минимум следующие показатели:
| Показатель | Разрез | Для чего нужен |
|---|---|---|
| Ежедневный расход токенов и затраты | По сотрудникам и командам | Проверять, насколько разумен бюджет, и выявлять аномальные вызовы |
| Доля вызовов каждой модели | По командам и типам задач | Оценивать, работает ли стратегия распределения моделей по уровням |
| Частота достижения лимита бюджета | По сотрудникам и неделям | Выявлять должности, для которых нужно пересмотреть бюджетный уровень |
| Число запросов на исключение и доля одобренных | По командам и месяцам | Оценивать, не слишком ли мягко или строго работает механизм согласования |
| Средняя стоимость одной задачи | По типам задач | Находить дорогостоящие сценарии, оптимизация которых принесёт наибольшую пользу |
С технической стороны можно записывать поле usage каждого запроса на уровне внутреннего AI-шлюза компании, а затем сводить данные по меткам сотрудников или команд. Если вы используете стороннюю платформу, сначала проверьте, достаточно ли подробную статистику расхода она предоставляет для распределения затрат. Поддержка субаккаунтов, лимитов для отдельных участников и оповещений зависит от реальных возможностей платформы.
Контроль расходов на вызовы ИИ: маршрутизация с учётом бюджета
На упрощённом примере покажем, как реализовать в коде индивидуальный бюджет и автоматический переход на более дешёвую модель. Начнём с одного вызова: главное здесь — прочитать количество токенов, использованных для запроса.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: один ключ для моделей разных провайдеров
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Для повседневных задач в первую очередь используем лёгкую модель
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
Полная реализация: бюджет по ролям и автоматический переход на более дешёвую модель
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Уровни моделей: замените названиями моделей, доступных на платформе
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# Заглушки для цен (доллары / миллион токенов): укажите актуальные цены платформы
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# Дневной бюджет по ролям (в долларах), по примеру градации Apple
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> расходы за день
exceptions = set()           # (user, date) с одобренными исключениями


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # Бюджет исчерпан: доступна только лёгкая модель
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # Близко к лимиту: переходим на уровень ниже
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# Пример использования
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
В этом примере опущены постоянное хранение данных, обработка параллельных запросов и процесс согласования. В продакшене стоит хранить spent в базе данных или кэше, а согласование исключений подключить к внутренней системе заявок. Основная идея остаётся той же: учитывать стоимость каждого вызова и проверять бюджет перед выбором модели.
🚀 Быстрый старт: чтобы проверить эффект многоуровневой маршрутизации, получите бесплатный тестовый лимит для новых пользователей на APIYI apiyi.com. С одним ключом сравните качество и расход моделей разных уровней на реальных задачах, а затем выберите модель по умолчанию для каждой роли.
Как корректировка бюджета токенов Apple повлияет на разработчиков и компании
Влияние на разработчиков
- Контроль расходов становится базовым навыком: разработчикам в крупных компаниях придётся следить за тем, сколько токенов потребляет каждая задача, и экономнее использовать ресурсоёмкие операции, такие как работа с длинным контекстом и повторные попытки.
- Умение работать с разными моделями ценится выше: после сокращения бюджетов эффективнее будут работать разработчики, которые умеют подбирать модель под задачу и поручать простые задачи лёгким или локальным моделям.
- Растёт спрос на AI-шлюзы и слои маршрутизации: компаниям нужна единая точка входа для учёта расходов, установки лимитов и переключения на более дешёвые модели. Работы по созданию такой внутренней инфраструктуры станет больше.
Влияние на руководителей компаний
- От «поощрения использования» к «тонкой настройке»: расходы на вызовы AI становятся частью обычного бюджетирования. Их придётся распределять между подразделениями и анализировать, как это делают с облачными ресурсами.
- Бюджет должен быть обоснованным: сотрудники Apple посчитали прежние лимиты «чрезмерно щедрыми». Это показывает, что лимиты, установленные на глаз, впоследствии могут потребовать затрат на корректировку.
- Нельзя игнорировать риски внутренней коммуникации: по сообщениям, некоторые сотрудники опасаются, что сокращение расходов предвещает увольнения. Если не объяснить причины ужесточения бюджета, его легко могут воспринять как признак более серьёзных организационных изменений.
В таблице ниже собраны типичные организационные риски при контроле расходов на вызовы AI и способы их снизить:
| Риск | Проявление | Возможное решение |
|---|---|---|
| Тревога сотрудников | Лимиты воспринимаются как сигнал о будущих увольнениях | Заранее объяснить, что цель — оптимизация структуры расходов, и опубликовать критерии распределения лимитов |
| Снижение продуктивности | Важные задачи прерываются из-за нехватки лимита | Вместо жёсткого отключения настроить автоматическое переключение на более дешёвую модель и обеспечить быстрое согласование исключений |
| Скрытый перерасход | Сотрудники переходят на личные аккаунты или неутверждённые инструменты | Сделать внутренние инструменты удобными и доступными в достаточном объёме, обеспечив соблюдение требований компании |
| Нагрузка на согласование | Заявок на исключения слишком много, руководители не успевают их обрабатывать | Регулярно пересматривать базовые лимиты на основе данных и повышать их, чтобы сократить число ненужных заявок |
| Сложно оценить результат | Учитываются только расходы, а не результаты | Анализировать стоимость каждой задачи вместе с качеством результата |
Частые вопросы FAQ
Вопрос 1: Насколько Apple сократила бюджет на токены?
По данным Bloomberg, в прошлом месяце Apple сократила дневной бюджет на токены для некоторых инженеров с 300 до 200 долларов. В дальнейшем его могут снизить до 100 долларов в день, а для некоторых нетехнических команд — до 25 долларов. Сотрудники, которым нужен больший лимит, могут попросить руководство сделать исключение.
Вопрос 2: Как определить разумный бюджет на токены для каждого сотрудника?
Для начала стоит изучить фактическое потребление сотрудников разных ролей за последние 1–3 месяца и разбить их на группы. Базовый бюджет можно установить выше медианного, но ниже высокого уровня потребления. Для активных пользователей можно предусмотреть дополнительные лимиты по согласованию, а затем ежемесячно корректировать группы с учётом того, как часто сотрудники достигают лимита и запрашивают исключения.
Вопрос 3: Какие ещё компании, помимо Apple, ограничивают внутренние расходы на ИИ?
В публикации говорится, что Microsoft, Tesla, Uber и Meta тоже недавно установили лимиты на внутренние расходы на ИИ. Однако конкретные суммы и способы ограничения не раскрываются.
Вопрос 4: Не повлияет ли распределение моделей по уровням на качество работы сотрудников?
Главное — подбирать модель под задачу, а не переводить всех на более простые модели. Для кратких пересказов, перевода и форматирования обычно достаточно лёгкой модели, а сложные рассуждения и важные изменения кода лучше поручить флагманской. Перед внедрением стоит сравнить модели на реальных задачах: например, на APIYI apiyi.com можно с одним API-ключом опробовать модели нескольких уровней. Выбирайте уровень по умолчанию, только убедившись, что качество вас устраивает.
Вопрос 5: Как малой или средней команде без внутреннего ИИ-шлюза быстро начать управлять расходами на вызовы моделей?
Можно начать с трёх шагов: создать единую точку доступа для вызовов, записывать в коде данные usage каждого запроса и назначить модели по умолчанию для разных задач. На агрегирующей платформе, такой как APIYI apiyi.com, один API-ключ позволяет переключаться между моделями OpenAI, Claude, Gemini и другими, а оплата зависит от объёма использования. Это поможет начать маршрутизировать запросы между моделями. Поддержку лимитов и оповещений для отдельных участников лучше уточнить у самой платформы.
Главное об управлении затратами на вызовы AI
- Apple уже сократила бюджет: дневной бюджет инженеров на токены снизили с 300 до 200 долларов и планируют сокращать дальше.
- Разные лимиты лучше единого: технические и нетехнические специалисты расходуют токены по-разному; целевые лимиты Apple различаются в 4 раза.
- Согласование исключений сохраняет гибкость: лимит не является жёстким потолком — для важных задач можно запросить дополнительную квоту.
- Распределение задач между моделями экономит деньги: повседневные задачи можно поручить лёгким или локальным моделям, а флагманские оставить для сложных.
- Мониторинг помогает управлять бюджетом: отслеживайте токены и расходы по сотрудникам и командам, чтобы корректировать лимиты на основе данных.
- Без общения с сотрудниками не обойтись: сокращение бюджета может вызвать опасения по поводу увольнений, поэтому его цели стоит объяснить заранее.
- Начните с маршрутизации запросов: через APIYI apiyi.com можно с одним ключом сравнить модели разных уровней и проверить стратегию распределения задач.
Итоги
Снижение ежедневного бюджета сотрудников Apple на токены — явный сигнал того, что крупные компании переходят от масштабного внедрения AI к тщательному учёту затрат. Для корпоративных команд отсюда следуют три вывода:
- Разделяйте бюджет по уровням: устанавливайте лимиты на сотрудника в зависимости от роли и типа задач, опираясь на данные о прошлом использовании, а не на интуицию;
- Сохраняйте гибкость: согласование исключений и автоматический переход на менее затратную модель помогут избежать ситуации, когда жёсткий лимит мешает важной работе;
- Распределяйте задачи между моделями: подбирайте модель под задачу и постоянно улучшайте распределение с помощью мониторинга использования.
Если ваша команда планирует управление затратами на вызовы AI, начните с пилотного распределения моделей для одного-двух частых сценариев. Получив реальные данные о затратах и качестве, можно расширить подход на другие задачи. Быстро создать среду для тестирования разных моделей можно через APIYI apiyi.com: бесплатной квоты для новых пользователей хватит для первоначального сравнения.
📚 Источники
- Apple slashes internal AI budgets, with deeper cuts still planned: пересказ материала Bloomberg от The Decoder
- Ссылка:
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - Описание: данные об изменении ежедневного бюджета Apple на токены, реакция сотрудников и информация об ограничении расходов на ИИ в других компаниях
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами через главную страницу сайта APIYI, чтобы обсудить управление расходами на вызовы ИИ в компании и подключение нескольких моделей


