
작성자 주석: ChatGPT Dots는 장기 목표를 중심으로 사용자가 위임한 작업을 이끌어 가요. 지속적으로 실행될 수 있는 이유는 작업 상태, 컨텍스트, 도구, 스케줄링 메커니즘이 서로 맞물려 작동하기 때문이에요.
결론부터 말하면: OpenAI가 2026년 9월 29일에 출시한 ChatGPT Dots는 AI를 “질문을 기다리는 Q&A 도구”에서 “위임을 받아 지속적으로 작업을 추진하는 실행자”로 바꿨어요. 각 Dot은 자체 클라우드 컴퓨터와 브라우저를 갖고, 프로젝트 컨텍스트를 유지하며, 위임받은 정보 소스에 대해 주도적으로 리서치하고, 시간이나 이벤트에 따라 작업을 시작해요. 판단과 승인이 필요한 사안을 만나면 결정권을 다시 사용자에게 돌려줘요. 제목에 나온 “24시간”은 하나의 작업 모드를 가리켜요. Agent가 사용자가 떠난 뒤에도 목표, 이벤트, 시간, 작업 상태에 따라 다음 단계를 결정할 수 있다는 뜻이지, 무한 루프나 실시간 모니터링, 제로 비용 운영을 약속한 건 아니에요. 현재 Dots는 ChatGPT Pro 100/200/500 개인 사용자와 자격을 갖춘 Business Premium, Enterprise, Edu, Healthcare 워크스페이스에 개방되어 있어요.
아래에서는 먼저 Dots와 일반 ChatGPT, Cron 스크립트, 전통적인 워크플로의 차이를 비교한 뒤, 지속적으로 작업하는 내부 메커니즘을 뜯어볼 거예요. 작업 상태, 메모리, 주도적 리서치, 정기 작업, 백그라운드 Agent 사이의 관계를 포함해서요. 이어서 공식 시연, 미디어 실측, 사용자 본인 서술에서 나온 사용 시나리오를 정리하는데, 세 가지 증거를 따로 제시할게요. 마지막으로 OpenAI Agents SDK와 Microsoft Research의 SentinelBench를 함께 살펴보며, 지속 Agent에 필요한 기술 구성 요소와 비용·위험이 무엇인지, 그리고 어떤 작업을 맡길 만한지 설명할게요.
To Know: ChatGPT Dots 관련 용어
| 용어 | 설명 |
|---|---|
| 상주 Agent(Always-on Agent) | 사용자가 메시지를 보내지 않는 사이에도 위임된 작업을 계속 진행할 수 있는 AI 시스템 |
| Cron | 정해진 시간 규칙에 따라 프로그램을 실행하는 스케줄링 방식, 예를 들어 “매일 9시에 한 번 실행” |
| 이벤트 트리거 | 특정 변화가 발생했을 때만 처리 프로세스를 시작하는 것, 예를 들어 Slack 채널에 새로운 버그 보고가 올라왔을 때 |
| 작업 상태 | 어떤 작업이 어디까지 진행됐는지, 결과는 어떤지, 아직 무엇을 기다리고 있는지를 기록한 정보 |
| 장기 기억 | 작업을 넘나들며 저장되는 사용자 선호도, 프로젝트 결정 사항, 배경 자료 |
| 도구 호출 | 모델이 외부 프로그램을 호출해 정보를 조회하거나 작업을 수행하는 것 |
| 능동적 리서치(Proactive Research) | Dot이 새 메시지를 받지 못한 상태에서, 권한이 부여된 데이터 소스에 대해 읽기 전용 백그라운드 리서치를 수행하는 것 |
| 백그라운드 Agent | Dot이 내보내 특정 부분의 작업을 병렬로 처리하는 하위 Agent |
| Human-in-the-loop / 인간 개입 | 작업 중 사람의 판단, 승인, 수정이 필요한 단계 |
| 오탐률 | 시스템이 처리할 필요가 없는 알림을 내보낸 비율, 전체 알림 중에서 차지하는 비중 |
| Prompt Injection | 웹페이지, 이메일 등 외부 콘텐츠에 악성 지시가 숨어들어 Agent의 행동을 탈취하려는 시도 |
| Token | 모델이 입력과 출력을 측정하는 기본 단위로, 호출 비용을 직접 결정 |
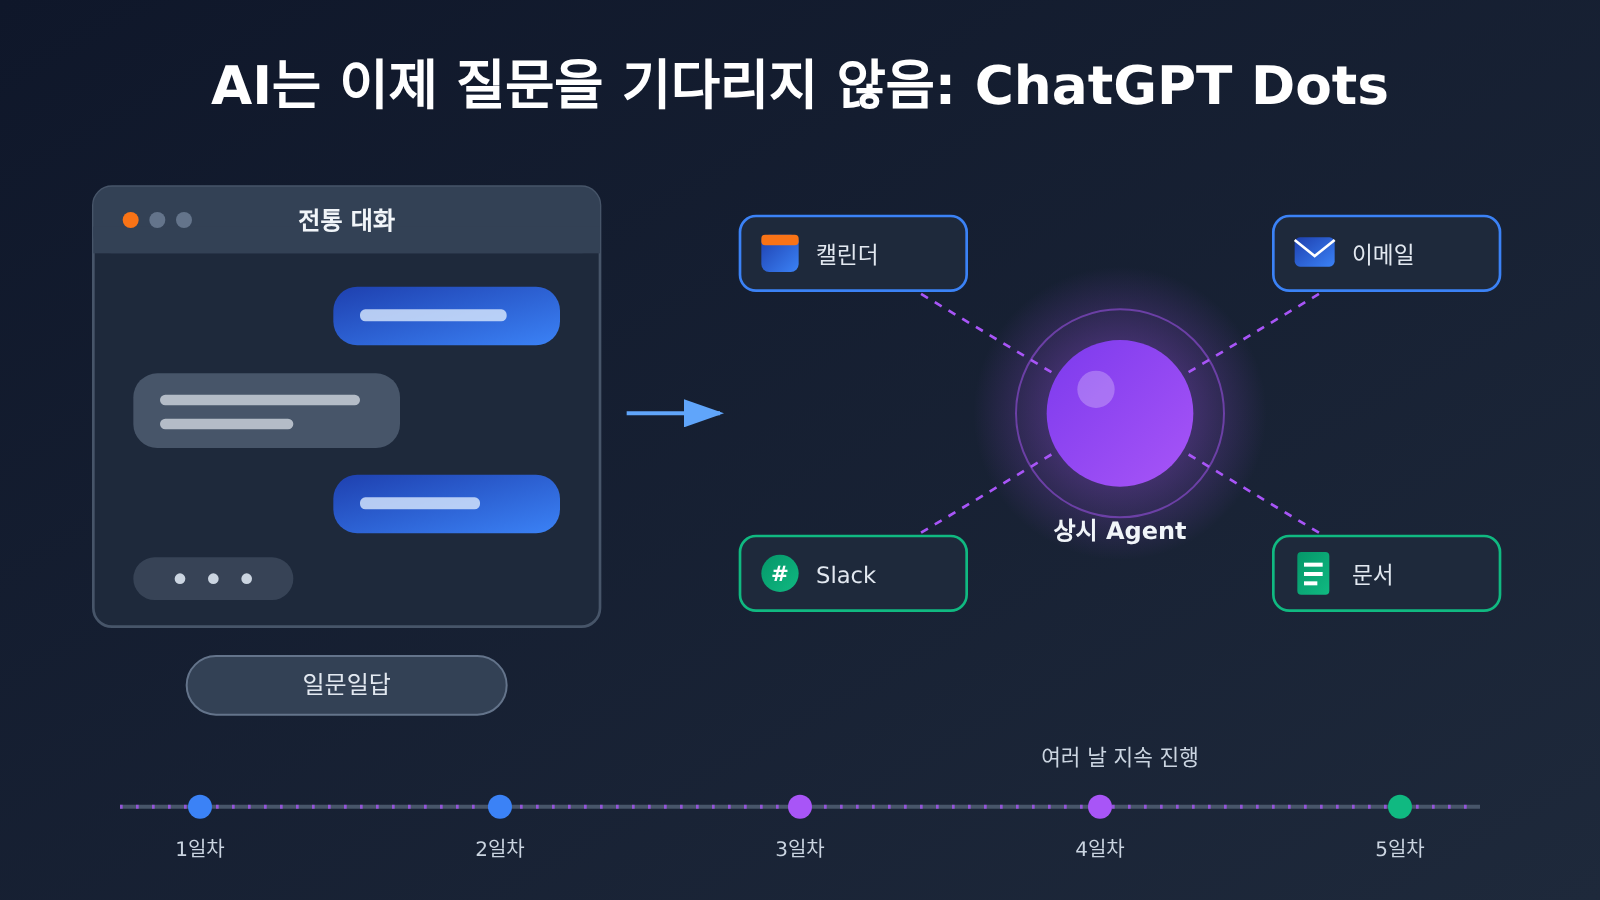
1 질문을 기다리는 것에서 능동적으로 업무를 맡는 것까지: ChatGPT Dots가 바꾼 것
1.1 ChatGPT Dots의 공식 정의
OpenAI가 공개한 글 “Introducing dots”와 도움말 문서에 따르면, Dots는 상시 상주형 개인 AI 에이전트(Personal Agent)예요. 공식적으로 설명된 핵심 기능은 다음과 같아요:
- Always-on 상시 실행: 사용자가 새 메시지를 보내지 않아도 위임된 작업을 계속 처리할 수 있어요.
- 자체 클라우드 컴퓨터: 각 Dot에는 독립적인 클라우드 컴퓨터와 브라우저가 있어서, 사용자의 컴퓨터가 꺼져 있어도 클라우드 작업은 계속 진행돼요.
- 지속적인 컨텍스트: ChatGPT 메모리, 이전 대화 기록, 연결된 앱의 정보를 활용할 수 있어요.
- 능동적인 리서치: 승인된 데이터 소스에 대해 백그라운드 리서치를 수행하고, 주목할 만한 정보를 찾아내요.
- 멀티 프로젝트 실행: 여러 프로젝트를 동시에 진행할 수 있고, 작업을 분할해 백그라운드 에이전트를 병렬로 실행할 수 있어요.
- 크로스 플랫폼 소통: ChatGPT 웹, 데스크톱, 모바일, Slack, Microsoft Teams를 통해 같은 Dot과 연락할 수 있어요.
- 인간-AI 협업: 사용자의 판단이나 승인이 필요한 사항은 능동적으로 사용자에게 돌려줘요.
공개 당시 공식 측은 Dots가 OpenAI 플러그인 생태계에 연결되어 있으며 연결 가능한 앱이 4,000개를 넘는다고 언급했어요. 이 숫자는 생태계 규모를 나타내는 것으로, 각 계정에서 실제로 사용할 수 있는 앱과 권한은 사용자가 직접 설정한 연결과 승인에 따라 달라져요.
1.2 ChatGPT Dots가 불러온 인간-AI 업무 분담 변화
일반 ChatGPT를 사용할 때 사용자는 작업의 조정자예요. 매 단계를 사람이 시작해야 하고, 진행 상황도 사람이 기억해야 하며, 여러 대화 사이를 오가며 전환해야 하죠. Dots는 이 조정 책임의 일부를 에이전트에게 넘겼어요. 사용자가 “이 고객 프로젝트를 출시까지 계속 팔로업해줘” 같은 장기 목표를 넘기면, Dot이 진행 상황을 기억하고 변화를 주시하며 다음 단계를 마련하고, 중요한 지점에서만 사람에게 결정을 요청해요.
그래서 사람의 역할은 “하나씩 지시하기”에서 “위임하고, 감독하고, 승인하기”로 바뀌었어요. 이 변화의 가치는 업무를 지속적으로 맡아 처리하는 데 있고, 절감되는 것은 사람이 여러 시스템을 오가며 진행 상황을 쫓고, 정보를 맞추고, 다음 단계를 재촉하는 조정 비용이에요. 단순히 프로세스에 자동화 단계를 몇 개 더 추가하는 것만으로는 얻는 이익이 제한적이에요.
2 왜 전통적인 자동화가 ChatGPT Dots 같은 에이전트를 완전히 대체할 수 없을까
2.1 Cron, 워크플로, 상주 에이전트의 기술 비교
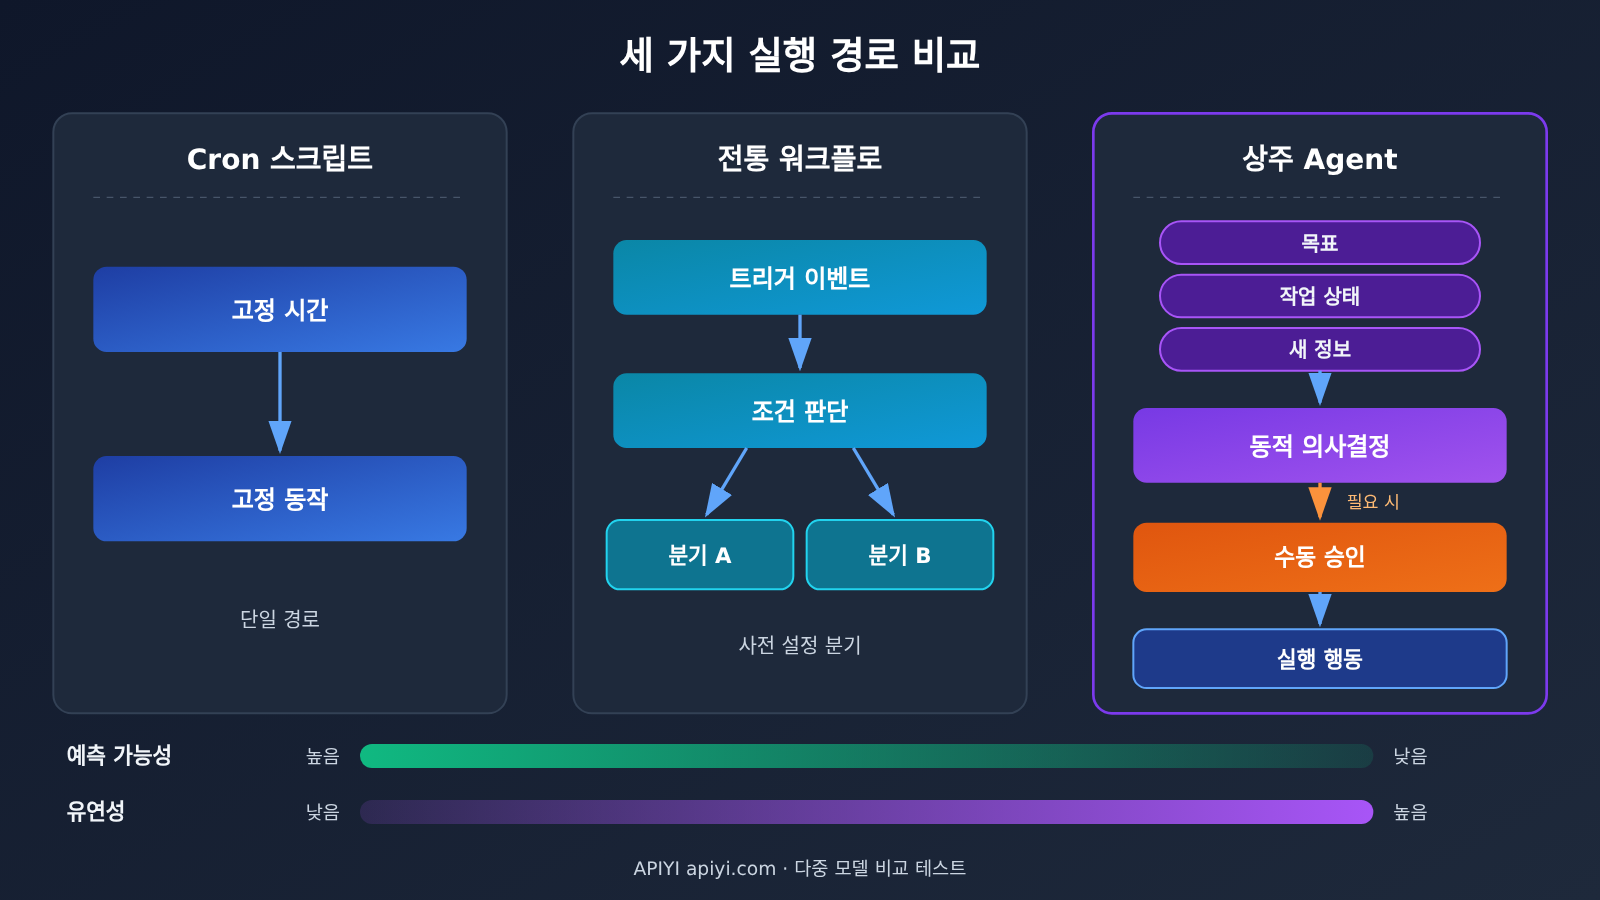
전통적인 자동화는 미리 작성된 프로세스를 실행하는 데 능숙하고, 상주 에이전트는 현재 작업 상태와 새로운 정보를 바탕으로 다음 단계를 결정할 수 있어요. 세 가지 방식의 핵심 차이는 다음과 같아요:
| 차원 | Cron 정기 스크립트 | 전통적 워크플로 | 상주 에이전트(예: Dots) |
|---|---|---|---|
| 트리거 방식 | 고정 시간 | 고정 시간 또는 이벤트 | 시간, 이벤트 및 작업 상태 |
| 실행 로직 | 사전 작성 | 사전 구성된 노드 | 컨텍스트에 따라 동적으로 결정 |
| 정보 이해 | 프로그램 코딩 필요 | 노드와 조건에 의존 | 모델을 호출해 내용을 이해 |
| 예외 처리 | 사전 설정 규칙 | 사전 설정 분기 | 상황을 분석하고 방안 제시 |
| 작업 간 기억 | 직접 개발 필요 | 워크플로 구성에 의존 | 장기 프로젝트 컨텍스트 유지 |
| 조정 방식 | 코드 수정 | 워크플로 수정 | 자연어로 조정 |
| 운영 비용 | 인프라 중심 | 소프트웨어 및 인프라 | 모델, 도구 및 인프라 |
| 예측 가능성 | 높음 | 비교적 높음 | 모델 출력의 영향을 받음 |
예를 들어 보겠습니다. Cron 스크립트는 10분마다 메일함을 확인해 특정 키워드가 포함된 이메일을 전달할 수 있어요. 에이전트는 구체적인 목표를 중심으로 이메일을 살펴보고, 중요한 메일이 오면 어떤 프로젝트와 관련이 있는지, 후속 조치가 필요한지, 어떤 답장 초안을 작성해야 하는지 판단해요.
2.2 규칙이 고정된 작업에는 여전히 전통적 자동화가 알맞아요
명확하고 반복적이며 규칙이 고정된 작업, 예를 들어 매일 밤 데이터베이스를 백업하거나 매주 월요일 고정 보고서를 내보내는 일에는 Cron과 워크플로가 더 통제하기 쉽고 검증·유지보수도 쉬우며 비용도 낮아요. 에이전트의 강점은 새로운 정보를 이해해야 하고 동적으로 조정해야 하는 작업에 집중돼요. 더 합리적인 아키텍처는 둘을 공존시키는 거예요. 결정론적인 부분은 스크립트에, 판단이 필요한 부분은 에이전트에 맡기는 거죠.
3 ChatGPT Dots가 지속적으로 작업하는 방식
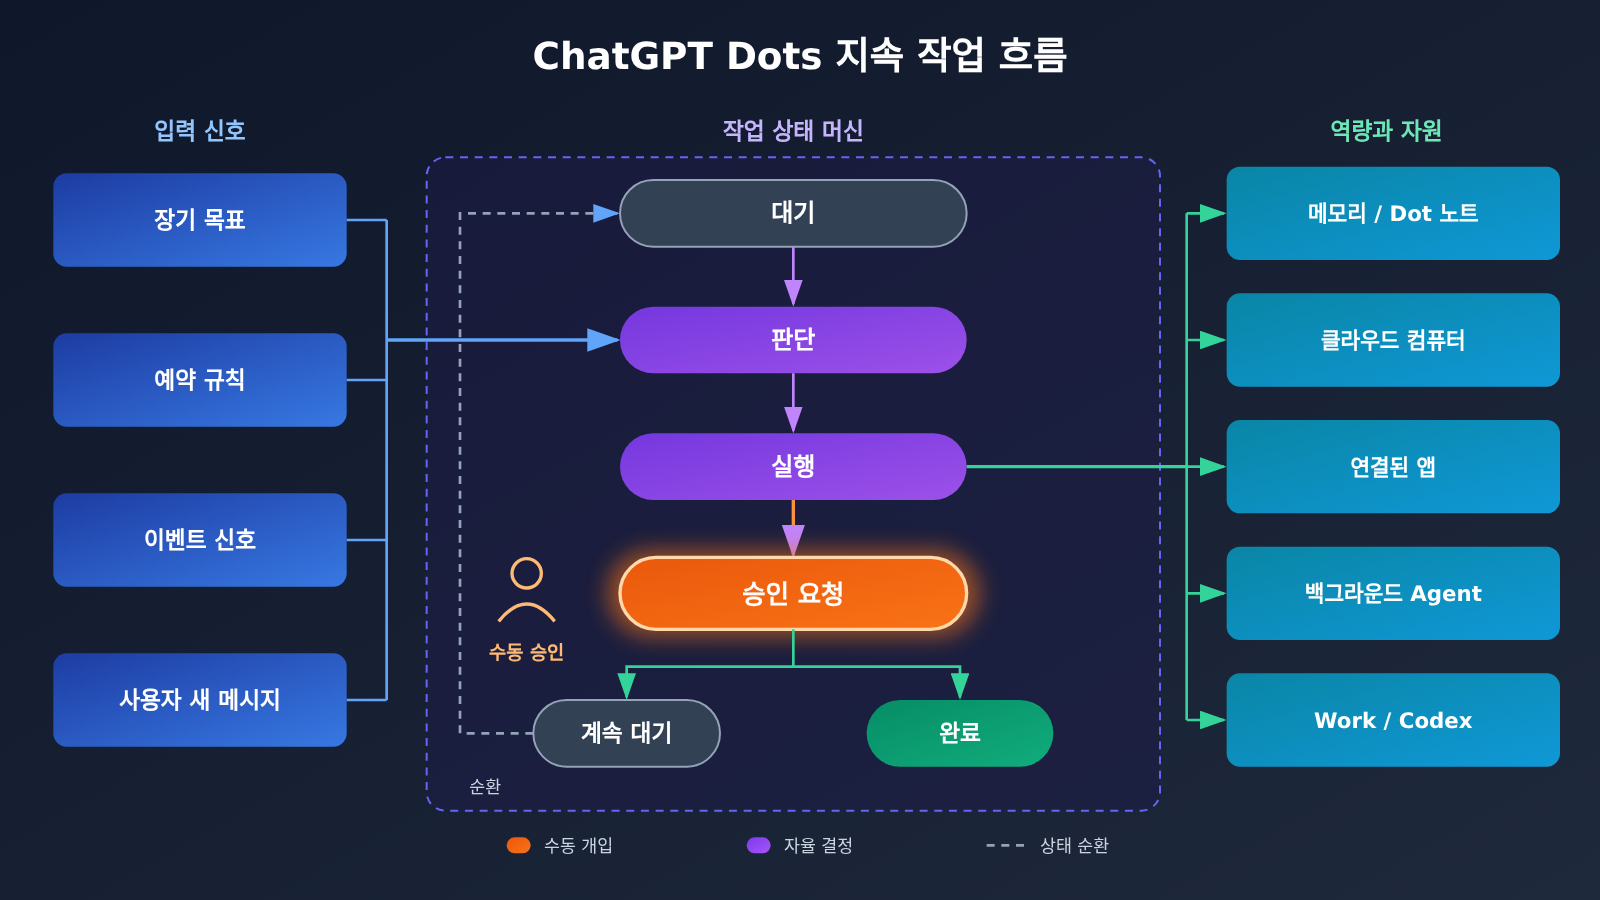
3.1 작업 상태가 Dots의 다음 단계를 결정해요
OpenAI의 Tasks and memory 문서에 따르면, Dot은 작업 상태에 따라 스스로 작업을 일시 중지하거나 재개할 수 있고, 사용자가 각 단계에 고정된 시간을 설정할 필요가 없어요. 언제 계속해야 할지 스스로 판단하고, 외부 조건 변화를 기다렸다가 적절한 시점에 다시 시작하며, 새로운 정보에 따라 후속 단계를 조정하고, 의사 결정이 필요할 때 사용자 입력을 적극적으로 요청할 수 있어요.
따라서 Dots의 ‘지속적 작업’은 목표, 이벤트, 시간, 작업 상태가 함께 이끄는 의사 결정 과정이며, 매분마다 의미 없이 반복 실행하지 않아요. 이런 설계 덕분에 Agent는 새로운 상황이 없을 때는 조용히 있고, 리소스는 실제로 행동이 필요한 순간에 쓰여요.
3.2 장기 기억과 프로젝트 컨텍스트
Dots의 컨텍스트는 네 계층의 데이터로 구성돼요:
- ChatGPT Memory: Dot은 ChatGPT의 관련 기억과 최근 대화 컨텍스트를 가져올 수 있어요.
- Dot 자체 노트: 사용자 선호, 업무 습관, 프로젝트 의사 결정, 장기 책임 사항을 축적해요.
- 현재 작업 컨텍스트: 현재 대화의 지시, 파일, 검색 결과, 도구 실행 결과예요.
- 연결된 앱의 데이터: 권한을 부여한 앱의 정보를 읽고, 적절한 조건에서 이 데이터를 연구해 자체 기억을 형성해요.
이 네 계층은 서로 독립적이에요. Dot의 기억은 정리된 관련 컨텍스트와 노트이지, 전체 채팅 기록 원문이 아니에요. 새 작업을 만들 때도 사용자와 Dot의 모든 과거 기록이 자동으로 포함되는 것은 아니며, Dot은 필요할 때 과거 대화를 검색해 배경을 보완해요.
3.3 자발적 리서치, 예약 작업, 이벤트 모니터링의 차이
이 세 가지 메커니즘은 모두 사용자가 메시지를 보내지 않아도 Dots가 계속 작업하게 하지만, 트리거 방식과 권한 범위는 서로 달라요.
- 자발적 리서치: 새 메시지가 없을 때 권한을 부여한 출처를 백그라운드에서 리서치하는 것이에요. 예를 들어 프로젝트 파일의 가격과 이메일 내용이 맞지 않거나, 중요한 마감 기한이 변경된 것을 발견할 수 있어요. 권한은 읽기 전용이에요: 다른 사람에게 메시지를 보낼 수 없고, 플러그인을 통해 내용을 수정할 수 없으며, 브라우저나 컴퓨터를 조작할 수도 없어요. 후속 작업은 반드시 정상적인 권한, 승인, 보안 검사를 거쳐야 해요.
- 예약 작업(Scheduled Tasks): 설정된 시간에 실행돼요. 예를 들어 매일 아침 캘린더를 확인하거나, 매주 월요일 프로젝트 진행 상황을 정리할 수 있어요. 만들 때는 무엇을 확인할지, 실행 시간, 시간대, 종료 날짜, 어떤 변경을 알려야 하는지, 결과를 어디로 보낼지 명확히 해야 해요.
- 이벤트 모니터링(Event Monitoring): 연결된 서비스가 해당 이벤트를 지원할 때 특정 유형의 이벤트를 주시해요. 예를 들어 Slack에 새 버그가 나타나는 경우예요. 사용자는 Dot에게 무엇을 모니터링할지 명확히 알려야 해요. Dot을 채널에 추가해도 채널 전체를 자동으로 모니터링하지 않아요.
예약 작업은 시간에 따라 실행되는 사전 설정 동작이고, 자발적 리서치는 컨텍스트 기반의 판단형 발견이라는 점에서 본질적으로 달라요. 또한 실행 중인 작업을 중지하는 것과 주기적 계획을 취소하는 것은 별개의 작업이므로 각각 확인해야 해요.
3.4 백그라운드 Agent와 위임 작업
Dots는 복잡한 작업을 나누고 백그라운드 Agent를 시작해 병렬 처리한 뒤 결과를 최종적으로 종합할 수 있어요. 더 나아가 ChatGPT Work 작업(독립적인 복잡 워크플로)과 Codex 작업(소프트웨어 개발 및 테스트)을 만들 수도 있어요. 사용자가 로컬 컴퓨터를 Dot에 연결하면 Dot이 작업을 로컬 환경으로 보내 실행할 수도 있어요. 로컬 접근은 기본적으로 꺼져 있으며 ChatGPT 데스크톱 앱을 통해 권한을 부여해야 하고, 언제든지 Revoke access로 취소할 수 있어요.
4 ChatGPT Dots가 대신 맡아줄 수 있는 장기 작업
4.1 사용자가 직접 공유한 사례
다음 사례는 2026년 10월 Reddit 커뮤니티에서 개인 사용자가 공유한 것으로, 사용자가 직접 밝힌 내용이며 독립적인 검증이나 정확도·통계 데이터는 제공되지 않았어요. 개인적인 경험만 보여줄 뿐이에요.
| 사례 | 입력 정보 | Dot의 행동 | 사용자가 설명한 결과 | 사람의 참여 단계 |
|---|---|---|---|---|
| 누락된 이메일 알림 | 이메일 계정 권한 부여, 프로젝트 컨텍스트 | 이메일을 확인하고 잊었거나 놓친 항목을 식별 | 놓친 항목 처리를 사용자에게 능동적으로 알림 | 사용자가 답장 여부와 방법을 결정 |
| 여러 시스템에 걸친 프로젝트 팔로업 | Cloudflare, CRM, Gmail(Composio MCP 연동) | 여러 시스템에 걸쳐 프로젝트를 진행하고, 맞춤형 MCP를 구축·테스트하며, 고객 정보 수집 포털과 Chrome 확장 프로그램을 제작하고, 팀 이메일과 캘린더를 모니터링 | 처리할 일을 능동적으로 알림 | 사용자가 산출물과 핵심 의사결정을 검토 |
| 비즈니스 보고서 | 고객 재무 데이터 | 고객 재무 대시보드 제작 | 사용자는 약 1시간에 완료했다고 말하며, 과거 유사 작업은 4—5일 걸렸음 | 사용자가 데이터와 표현을 확인 |
| 주기적 운영 | 일정 스케줄링 + Google Sheets 플러그인 | 매일·매주 작업을 수행하고 비즈니스 표를 업데이트 | 사용자는 일부 Cron이 유연하게 대응하기 어려운 작업을 처리할 수 있다고 봄 | 사용자가 규칙을 설정하고 결과를 샘플 검사 |
또 다른 Reddit 사용자는 약 하루 동안 메커니즘 테스트를 진행했어요. 수백 개의 PDF와 수천 페이지 분량의 자료를 Dot에 넘겨 검토하게 했는데, 작업이 여러 날에 걸쳐도 진행 상황이 유지됐어요. 도중에 질문을 끼워 넣으면 Dot은 검토를 잠시 멈추고 자료를 찾아 답변한 뒤 원래 작업으로 돌아갔어요. 이 사용자는 Dot의 클라우드 컴퓨터, 연결된 Linux 컴퓨터, 백그라운드 리서치 에이전트가 동시에 실행되는 것도 관찰했어요. 본인도 이 실행 경로들의 할당량이 어떻게 계산되는지는 아직 확인되지 않았다고 지적했어요.
4.2 미디어 실측: Axios의 Dots와 Meta Muse 비교
Axios 기자 Ina Fried는 2026년 10월 20일 Dots와 Meta Muse의 비교 테스트를 공개했어요. 과제는 WNBA 파이널 경기 관람 여행을 둘러싼 것이었어요.
- 다단계 계획: 둘 다 경기 날짜가 앞당겨졌고 티켓이 아직 판매되지 않았다는 점 등을 발견했으며, Dots는 일정과 사용자의 기존 캘린더가 충돌한다는 점까지 찾아냈어요.
- 문서 생성: Dots는 8페이지 분량의 모임 자료 패키지와 38페이지의 기념 프로그램북을 만들었고, Muse의 프로그램북은 35페이지였어요. 두 프로그램북 모두 의심스러운 통계 수치가 있었어요.
- 사진 기념 앨범: Dots는 47초 만에 12페이지 기념 앨범을 만들었는데, 이는 이번 테스트에서 나온 결과일 뿐이에요.
- 실제 구매: Dots는 사용자를 Target 앱으로 안내하고 저장된 계정으로 작업을 이어가게 했지만, 구매 과정 전체가 완전히 자동으로 끝나지는 않았어요.
글쓴이의 결론은 이렇습니다. 이런 에이전트는 리서치와 준비 작업을 맡기에 적합하지만, 결과는 여전히 사람이 편집하고 사실 확인을 해야 하며, 계정과 자금이 얽힌 작업의 최종 결정은 사람에게 남겨야 한다는 것이에요.
공식적으로 소개된 시나리오에는 회의 준비, 판매 데이터 모니터링, 고객 피드백 추적, 콘텐츠 제작, GitHub 프로젝트 관리, 여행 일정 조정 등도 포함돼요. 이런 사례는 제품 예시로, 역량의 방향성을 보여줄 뿐 매번 실행했을 때 보장되는 결과로 받아들여서는 안 돼요.
5 Agent가 24시간 일하게 하려면, 그 뒤에 무엇이 필요한가
5.1 Agents SDK의 기본 구성 요소
OpenAI의 Building Agents 가이드는 Agent 시스템을 몇 가지 기본 개념으로 정리하는데, 이는 지속적으로 작업하는 각 단계에 대응시킬 수 있어요:
- Agent: 모델, 지시사항, 도구의 조합으로, 이해와 실행을 담당해요.
- Handoff: 작업을 다른 Agent에게 넘기는 것으로, Dots가 백그라운드 Agent를 파견하는 것에 대응해요.
- Guardrail: 입력, 출력, 실행 행위를 제약하는 것으로, 승인 및 안전 검사에 대응해요.
- Session: 실행 간 대화 기록을 유지하는 것으로, 작업 상태와 컨텍스트 연속성에 대응해요.
- Tracing: 실행 과정을 기록하여 문제 파악과 감사에 용이하게 해요.
지속적으로 작업할 수 있는 Agent는 실제로 ‘도구 호출 + 상태 관리 + 이벤트 모니터링 + 장기 기억 + 실행 스케줄링 + 안전 메커니즘’이라는 여섯 가지 구성 요소의 조합이며, 어느 하나라도 빠지면 안정적으로 운영되기 어려워요.
5.2 SentinelBench 연구가 주는 시사점
Microsoft Research는 2026년 6월에 SentinelBench를 공개했어요. 이 벤치마크는 외부 상태 변화를 오랫동안 주시해야 하는 모니터링형 Agent를 전문적으로 평가하기 위해 만들어졌죠. 이메일, 캘린더, 금융, 비즈니스 소셜, 엔터테인먼트 등 10가지 모의 웹 환경을 아우르는 100개 과제를 설계했고, 과제 완료율과 반응 시간, 자원 소모를 함께 측정해요.
이 연구의 핵심 주장은 이래요. 장기 모니터링 과제에서는 환경에 계속 관심을 기울이는 게 중요하고, 정말로 행동할 가치가 있는 변화가 나타났을 때 비로소 움직여야 한다는 것이죠. 끊임없이 액션을 실행하는 건 오히려 효과적이지 않을 수 있어요. 이는 과제 상태에 따라 일시정지하고 재개하는 Dots의 설계思路와 맥을 같이해요. 한 가지 짚고 넘어갈 점은, SentinelBench는 독립적인 연구 벤치마크이기 때문에 이를 근거로 Dots의 구체적인 성공률을 추산할 수는 없다는 거예요.
5.3 자체 구축 지속형 에이전트 설계 방안
개발자가 자신의 시스템에서 이와 유사한 “상태 기반” 작업 모드를 구현하려면 OpenAI 호환 인터페이스로 프로토타입을 만들 수 있어요. 아래 코드는 설계안 예시로, 판단 단계의 작성 방식을 보여줄 뿐 실행 결과는 포함하지 않았어요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

# 모델이 새 이메일에 대해 사용자에게 알림이 필요한지 판단하도록 함
resp = client.chat.completions.create(
    model="gpt-4.1",
    messages=[
        {"role": "system", "content": "你是项目跟进助手,只输出 JSON:{\"action\": \"ignore|remind|ask_human\", \"reason\": \"...\"}"},
        {"role": "user", "content": "项目:官网改版,截止 11 月 30 日。新邮件:设计方说交付推迟到 12 月 5 日。"}
    ]
)
print(resp.choices[0].message.content)
전체 설계안 보기: 시간 + 이벤트 + 상태 기반 에이전트 루프
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 작업 상태: 지속적으로 동작하는 핵심이며, 다음 단계에 무엇을 할지 결정함
task = {
    "goal": "跟进官网改版项目直到上线",
    "status": "waiting",          # waiting / judging / awaiting_human / done
    "memory": ["截止日期 11 月 30 日", "发送邮件前必须人工确认"],
    "next_check": time.time(),     # 정기 점검(폴백)
}

def fetch_new_events():
    """이벤트 소스: 이메일/IM의 웹훅 또는 증분 인터페이스와 연동하며, 여기서는 자리 표시자로 둠"""
    return []

def judge(event: str) -> dict:
    """모델을 호출해 판단: 무시, 알림, 아니면 사람의 결정 요청"""
    resp = client.chat.completions.create(
        model="gpt-4.1",
        messages=[
            {"role": "system", "content": "根据目标与记忆判断新事件,只输出 JSON:"
             "{\"action\": \"ignore|remind|ask_human\", \"reason\": \"...\"}"},
            {"role": "user", "content": json.dumps(
                {"goal": task["goal"], "memory": task["memory"], "event": event},
                ensure_ascii=False)}
        ]
    )
    return json.loads(resp.choices[0].message.content)

def run_once():
    events = fetch_new_events()
    # 이벤트가 없고 정기 점검 시간도 되지 않았다면: 그대로 대기해 불필요한 폴링과 Token 낭비를 피함
    if not events and time.time() < task["next_check"]:
        return
    for ev in events:
        decision = judge(ev)
        if decision["action"] == "ask_human":
            task["status"] = "awaiting_human"   # 사람 승인 지점: Agent가 임의로 실행하지 않음
            print("需要你决定:", decision["reason"])
        elif decision["action"] == "remind":
            print("提醒:", decision["reason"])
        task["memory"].append(f"已处理事件:{ev[:50]}")
    task["next_check"] = time.time() + 3600     # 1시간마다 정기 점검(폴백)

# 실제 배포 시에는 while True로 공회전하는 대신 스케줄러나 이벤트 콜백이 run_once를 트리거함
이 설계안은 세 가지 원칙을 보여줘요. 이벤트 우선, 정기 점검을 폴백으로 두기, 상태가 동작을 결정하기, 그리고 고위험 동작은 사람의 승인 단계로 넘기기예요.
🚀 빠른 시작: 자체 Agent 프로토타입을 만들 때는 APIYI apiyi.com을 통해 하나의 API 키로 OpenAI, Claude, Gemini 같은 모델을 호출하고, “지금 행동해야 하는가” 같은 판단 작업에서 각 모델의 성능을 비교해 볼 수 있어요. 신규 사용자에게는 무료 테스트 크레딧이 제공돼요.
6 ChatGPT Dots 지속 작업의 경계: 신뢰성, 비용, 권한
6.1 오탐, 잘못된 판단, 비효율적 폴링
공식 개인정보 및 보안 문서에는 에이전트가 작업을 잘못 이해하거나, 자료를 오판하거나, 잘못된 데이터를 생성하거나, 웹사이트 로그인을 완료하지 못하거나, 실행 환경을 사용할 수 없는 상황이 발생할 수 있으며, 실행 결과는 사람이 확인해야 한다고 적혀 있어요. Axios 테스트에서 나온 의심스러운 통계 수치는 이런 위험이 실제 사용에서도 정말 존재한다는 것을 보여줘요.
장기간 운영하면 간과하기 쉬운 비용도 몇 가지 생겨요. 작업 실행과 이벤트 대기에 드는 리소스 소비는 서로 다르고, 모델이 컨텍스트를 복원할 때 자료를 반복해서 읽으면서 토큰 비용이 발생하며, 불필요한 폴링은 중복 실행을 일으켜요. SentinelBench가 응답 시간과 리소스 사용량을 함께 평가에 넣는 이유도 여기에 있어요. 장기 모니터링은 빨라야 하고 동시에 비용을 아껴야 하거든요.
6.2 권한과 사람 승인
Dots는 Custom Rules를 통해 사용자가 행동마다 실행 요구 사항을 설정할 수 있게 해요. 네 단계가 있어요. 질문 없이 바로 실행, 사전 승인 후 실행, 실행 전 질문, 사용자에게 넘기기예요. 예를 들어 지정된 폴더를 자동으로 정리하도록 허용하면서도 이메일을 보내기 전에는 물어보게 하고, 구매는 반드시 확인하게 하며, 소셜 미디어 게시는 전면 금지할 수 있어요.
계정에 영향을 주거나 정보를 외부에 공개할 수 있는 작업 전에는 Auto-review 메커니즘이 해당 행동이 지시, 규칙, 보안 요구 사항, 권한 경계에 부합하는지 확인해요. 비밀번호 변경이나 자금 이체 같은 작업은 사용자가 직접 처리해야 하고, 데이터 영구 삭제나 소프트웨어 설치는 매번 승인해야 할 수도 있어요. 프롬프트 인젝션에 대응해 OpenAI는 지시 출처 구분, 도구 제한, 승인, 지속 모니터링 등의 조치를 취했고, 동시에 이런 조치가 모든 위험을 없앨 수는 없다고 분명히 밝혔어요.
6.3 비용: 개인 Pro와 기업 Dots
- 개인 사용자: Pro 100($100/월), Pro 200($200/월), Pro 500($500/월) 모두 Dots 사용 자격이 있어요. 공식 개인 Pro의 Dots 설명에는 별도의 Dot 월 이용료가 명시되어 있지 않아요. 개인 Pro는 만 18세 이상이어야 하고, 아직 유럽 경제 지역, 영국, 스위스에서는 제공되지 않으며, 권한은 점진적으로 제공돼요.
- 위임 작업: Dot이 시작한 ChatGPT Work 또는 Codex 작업은 해당 제품의 할당량 또는 과금 규칙에 따라 별도로 계산되며, 소비량은 모델, 컨텍스트, 추론, 도구 호출, 검색에 따라 달라져요.
- 기업 워크스페이스: Enterprise, Edu, Healthcare는 2026년 11월 4일부터 18일까지 무료 관리자 미리보기 기간이고, 11월 18일부터 조건을 충족하는 워크스페이스에 기본으로 개방되며 과금이 시작돼요. 기업은 업무 유형별 고정 요율 또는 사용량 기반 과금을 선택할 수 있고, Work 또는 Codex로 위임한 작업은 별도로 과금되며, 구체적인 금액은 워크스페이스에 실제 적용되는 견적을 따라요. 구성원 한 명당 개인 Dot을 하나씩 만들 수 있어요.
6.4 지속형 에이전트를 평가하는 다섯 가지 지표
에이전트가 정말 ‘당신을 대신해 일하는지’ 판단하려면 정량화 가능한 지표가 필요해요.
| 지표 | 계산 방식 | 중점 |
|---|---|---|
| 작업 완료율 | 성공적으로 완료한 작업 / 전체 작업 | 실제로 결과를 전달할 수 있는지 |
| 평균 응답 시간 | 이벤트 발생부터 유효한 응답까지 걸린 시간 | 업무에 필요한 시의성을 충족하는지 |
| 오탐률 | 조치가 필요 없는데 트리거된 횟수 / 전체 트리거 횟수 | 알림이 사람을 방해하고 있는지 |
| 사람 개입률 | 사용자 개입이 필요한 작업 / 전체 작업 | 실제로 얼마나 많은 인력을 절약했는지 |
| 작업당 비용 | 모델, 도구, 서버 비용 / 성공적으로 완료한 작업 수 | 경제적으로 합당한지 |
💰 비용 최적화: 자체 모니터링형 에이전트를 만들 때 ‘조치가 필요한지 판단’하는 단계는 호출 빈도가 가장 높아요. 여기에는 단계별 모델 선택을 적용하는 게 좋아요. 가벼운 모델로 1차 필터링을 하고, 강한 모델로 심층 분석을 하는 식이에요. APIYI(apiyi.com)에서 종량제로 여러 모델을 호출하고, 위 표를 기준으로 작업당 비용을 산출할 수 있어요.
7 ChatGPT Dots 같은 Agent에 실제로 맡길 만한 작업은 무엇일까
어떤 작업을 상시 대기하는 Agent에 맡길지 판단할 때는 다음 다섯 가지 기준을 살펴볼 수 있어요:
| 판단 기준 | Agent에 맡기는 게 더 적합 | 기존 자동화나 사람이 더 적합 |
|---|---|---|
| 규칙의 명확성 | 규칙이 모호하고 의미 이해가 필요한 일 | 규칙이 명확하고 완전히 코드화할 수 있는 일 → 스크립트 |
| 정보 변화 빈도 | 정보 소스가 많고 변화 시점이 불규칙한 일 | 변화가 일정하고 예측 가능한 일 → 예약 스크립트 |
| 작업 지속 기간 | 여러 날, 여러 주에 걸친 장기 프로젝트 | 일회성 짧은 작업 → 일반 대화 |
| 의사결정 위험 | 저위험이거나 승인 단계를 둘 수 있는 일 | 자금, 비밀번호, 되돌릴 수 없는 작업이 얽힌 일 → 사람 |
| 사람의 조정 비용 | 여러 시스템을 오가며 진행 상황과 정보를 맞춰야 하는 일 | 단일 시스템 안에서의 간단한 작업 |
이 기준에 비춰 보면, 비교적 맡길 만한 작업으로는 장기 주제 연구와 자료 추적, 시스템 간 프로젝트 팔로업, 누락 항목 알림, 주기적 보고서 업데이트, 회의 준비와 회의 후 액션 정리가 있어요. 송금, 비밀번호 변경, 외부 게시 같은 고위험 작업은 사람이 직접 처리해야 하며, 적어도 “실행 전 확인” 단계를 두는 게 좋아요.
💡 선택 제안: 팀에서 Dots 외에 자체 Agent 워크플로를 구축하려면, 모델마다 도구 호출, 긴 컨텍스트, 판단 안정성에서 차이가 있다는 점을 고려해야 해요. 먼저 APIYI apiyi.com에서 동일한 코드로 모델을 바꿔가며 소규모 비교를 해 본 뒤, 프로덕션 환경에서 어떤 모델을 쓸지 결정하세요.
자주 묻는 질문 FAQ
Q1: ChatGPT Dots는 무엇인가요?
Dots는 OpenAI가 2026년 9월 29일에 출시한 상주형 개인 AI Agent예요. 독립적인 클라우드 컴퓨터와 브라우저를 갖추고 있으며, 프로젝트 컨텍스트를 유지하고, 권한이 부여된 정보 소스를 주도적으로 조사하고, 시간이나 이벤트에 따라 작업을 진행하며, 의사결정이 필요할 때 사용자에게 업무를 되돌려줘요.
Q2: Dots는 정말 24시간 연속으로 실행될 수 있나요?
“24시간”은 작업 방식을 설명하는 표현이에요. 사용자가 자리를 비운 뒤에도 Dot은 목표, 이벤트, 시간, 작업 상태에 따라 언제 계속하고 언제 기다릴지를 결정할 수 있어요. 다만 연결된 앱, 지원되는 이벤트 유형, 사용 쿼터의 제약을 받으며, 무한 루프로 돌아가지도 않고 모든 정보 소스를 실시간으로 모니터링할 수도 없어요.
Q3: Dots의 주도적 연구와 예약 작업은 무엇이 다른가요?
예약 작업은 정해진 시간에 지정된 동작을 실행해요. 주도적 연구는 새 메시지가 없을 때 컨텍스트를 바탕으로 권한이 부여된 출처를 읽기 전용으로 조사해, 주목할 만한 정보를 발견하는 것이에요. 주도적 연구 자체는 메시지를 보내거나 내용을 수정하거나 컴퓨터를 조작할 수 없으며, 후속 행동은 권한과 승인 절차를 거쳐야 해요.
Q4: Dots를 쓰려면 추가 비용을 내야 하나요?
개인 Pro 100/200/500 사용자는 사용 자격을 갖춰요. 공식 자료에는 Dot의 별도 월 요금이 명시되어 있지 않아요. Dot이 위임한 Work, Codex 작업은 해당 쿼터나 규칙에 따라 별도로 산정돼요. 기업 워크스페이스는 2026년 11월 18일부터 과금되며, 작업 유형별 고정 요율 또는 사용량 기반 과금을 선택할 수 있고, 금액은 실제 견적을 기준으로 해요.
Q5: 개발자가 Dots와 유사한 지속형 Agent를 직접 구축하려면 어떻게 해야 하나요?
OpenAI Agents SDK의 Agent, Handoff, Guardrail, Session, Tracing 같은 개념을 참고해 상태 관리, 이벤트 트리거, 타이머 안전망, 사람의 승인 절차를 조합할 수 있어요. 모델 호출 부분은 APIYI apiyi.com의 OpenAI 호환 인터페이스에 연결하고, `base_url`을 `https://api.apiyi.com/v1`로 설정해 하나의 Key로 여러 모델을 테스트해 볼 수 있어요.
Q6: Dots에는 어떤 알려진 제한이 있나요?
Agent가 작업을 잘못 판단하거나 잘못된 데이터를 생성할 수 있고, 로그인 단계에서 막힐 수 있으며, 이미 완료된 작업을 반드시 취소할 수 있는 것도 아니에요. 프롬프트 인젝션 위험도 완전히 없애기는 어려워요. 사용자는 현재 Dot의 독립 기억을 항목별로 확인하거나 삭제할 수 없고, 플러그인 연결을 끊어도 이미 가져온 정보가 자동으로 삭제되지 않아요. 자체 비즈니스에서 Agent 방안을 검증할 때는 APIYI apiyi.com의 무료 쿼터로 소규모 샘플 테스트를 먼저 진행하고, 오탐률과 수동 개입 비율을 집계해 보세요.
ChatGPT Dots 핵심 요약 Key Takeaways
- 역할 전환: Dots는 AI를 수동적인 질의응답 도구에서, 위임을 받아 계속해서 작업을 밀어붙이는 실행자로 바꿔줘요.
- 지속 작업의 본질: 목표, 이벤트, 시간, 작업 상태가 다음 단계를 결정하며, 무한 루프에 의존하지 않아요.
- 세 가지 메커니즘: 능동 리서치는 읽기 전용, 정기 작업은 정해진 시간에, 이벤트 모니터링은 필요할 때 작동하며, 이 셋은 따로 따로 이해해야 해요.
- 근거의 계층: 공식 발표된 기능, Axios 실측, 사용자 자술이라는 세 가지 근거는 신뢰도가 각기 달라요.
- 경계 명확: 고위험 작업은 사람이 직접 인계받아야 하고, 결과는 여전히 팩트 체크가 필요해요.
- 비용은 두 계층: Pro 구독 자격과 위임 작업 소모는 별도로 계산되고, 기업은 견적에 따라 과금돼요.
- 직접 구축 경로: Agents SDK를 참고해 상태와 승인을 설계하고, APIYI apiyi.com의 통합 인터페이스로 여러 모델을 검증해요.
요약
ChatGPT Dots의 핵심 가치는 하나의 Agent가 장기간 작업을 맡도록 만드는 데 있어요. 독립된 클라우드 컴퓨터가 실행 환경을 제공하고, 장기 기억이 컨텍스트를 제공하며, 능동 리서치와 정기 작업, 이벤트 모니터링이 트리거 역할을 해요. Custom Rules와 Auto-review는 권한 경계를 정해줘요. 이 도구는 시스템을 넘나들고 시간을 넘나들며 새로운 정보를 이해해야 하는 작업에 적합해요. 반면 규칙이 고정된 작업은 전통적인 자동화에 맡기는 편이 여전히 더 경제적이고, 고위험 결정은 여전히 사람이 내려야 해요.
이런 Agent를 평가할 때는 작업 완료율, 응답 시간, 오탐률, 사람 개입률, 작업당 비용이라는 다섯 가지 지표로 정말 시간을 절약해 주는지 따져볼 수 있어요. 여러분의 제품에서 비슷한 지속 작업 능력을 구현하고 싶다면, 먼저 APIYI apiyi.com을 통해 효과를 빠르게 검증해 보는 걸 추천해요. 하나의 API 키로 여러 주요 모델에 접속하고, 사용한 만큼만 지불하는 구조라 프로토타입 비교에 딱 맞아요.
📚 참고 자료
- OpenAI: Introducing dots: Dots 출시 공지로, 제품 포지셔닝과 생태계 규모를 담고 있어요
- 링크:
openai.com/index/introducing-dots -
설명: 공식 기능 설명을 확인할 때 가장 먼저 봐야 할 자료
-
ChatGPT Learn: Meet dots / Tasks and memory: 제품 개요, 작업, 메모리, 능동형 리서치 및 주기 작업
- 링크:
learn.chatgpt.com/docs/dots -
설명: 지속적 작동 메커니즘을 이해하기 위한 핵심 문서
-
OpenAI Help Center: Getting started with your dot: 개통, 컴퓨터 연결, 규칙 관리
- 링크:
help.openai.com/en/articles/20001530-getting-started-with-your-dot -
설명: 실제 조작 단계와 제한 사항
-
OpenAI Help Center: Dots privacy, security, and safety FAQs: 권한, 승인, Prompt Injection 및 데이터 정책
- 링크:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs -
설명: 보안 경계를 평가할 때 반드시 읽어야 하는 자료
-
Dots Enterprise 관리자 가이드 및 Pro 구독 안내: 기업 과금 방식과 Pro 가격
- 링크:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
설명: 비용 정보는 이 문서를 기준으로 삼아요
-
OpenAI Building Agents 가이드: Agents SDK 기본 개념
- 링크:
developers.openai.com/tracks/building-agents -
설명: 직접 Agent를 구축할 때 참고할 기술 자료
-
Microsoft Research: SentinelBench: 장기 모니터링 Agent 벤치마크 연구
- 링크:
microsoft.com/en-us/research/publication/sentinelbench-a-benchmark-for-long-running-monitoring-agents -
설명: 지속적 모니터링의 효율성과 자원 트레이드오프를 이해하는 데 도움
-
Axios: I tested Dots and Muse: 제3자 미디어 실측
- 링크:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - 설명: 실제 작업 성능과 조작상의 장애물
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 웹사이트 첫 페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요


