
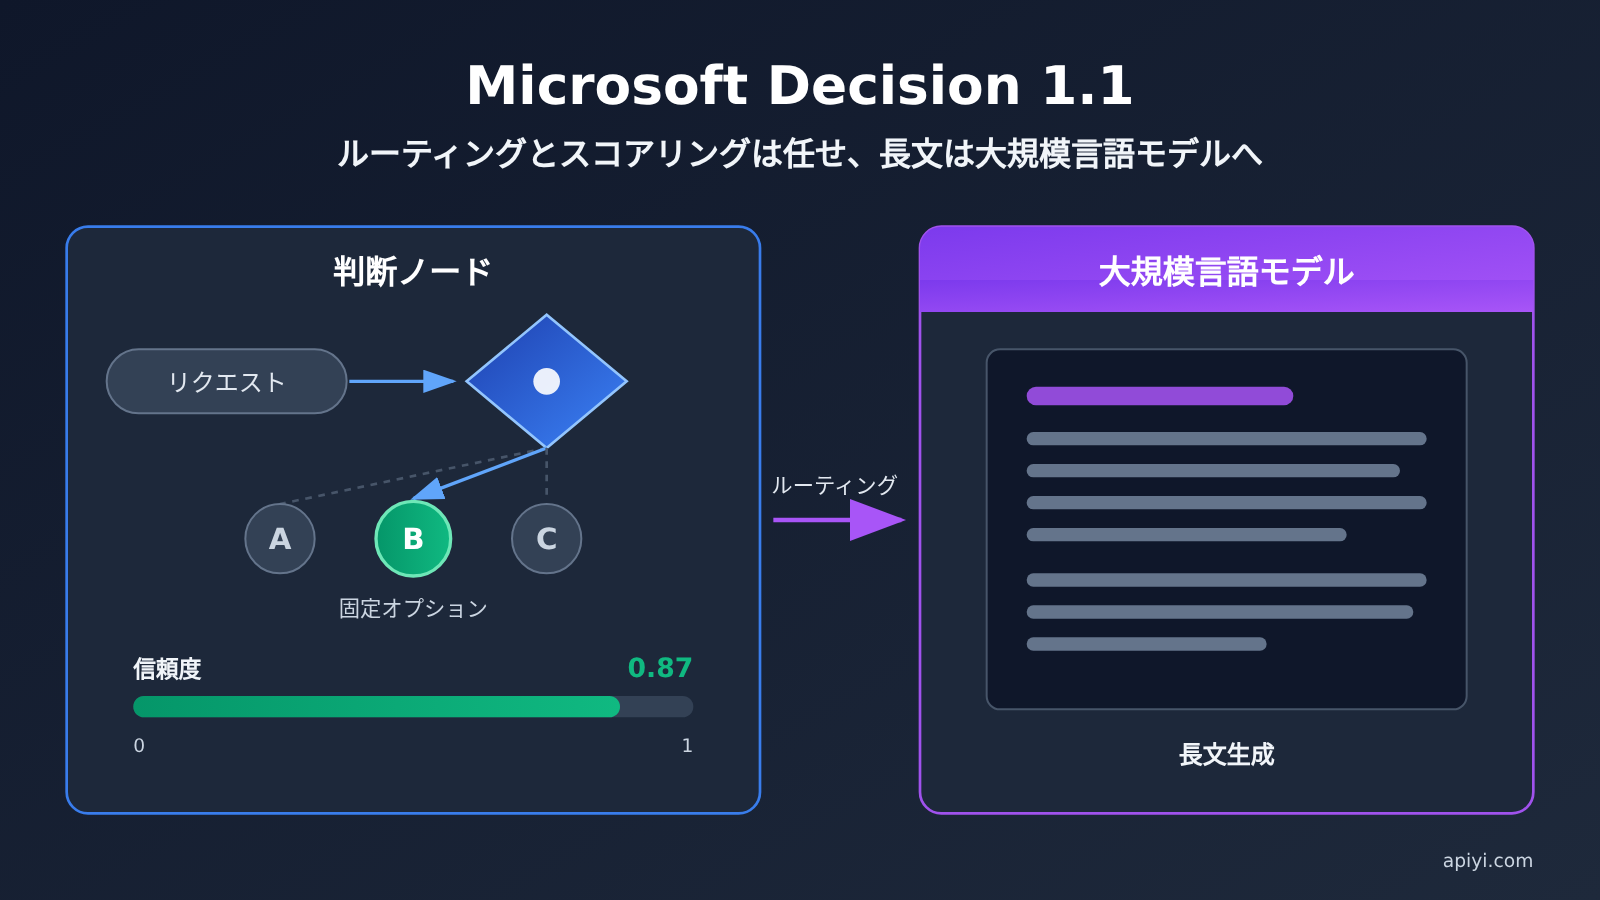
著者注:Microsoft-Decision-1.1 は 2026-11-17 に正式提供されました。与えられた選択肢の中から選ぶ、スコアを付ける、はい/いいえを判定するだけで、長文は書きません。本記事では、パイプラインのどのステップを置き換えるのに適しているか、料金はどのドキュメントを見るべきか、そして投稿内の数字をそのままコスト表に書けない理由を説明します。
Microsoft Ignite の期間中、TestingCatalog は 2026-11-17 に投稿を公開しました。投稿の本文には「MAI Decision 1」と書かれている一方、添付画像は Artificial Analysis の Decision 1.1 のランキング画像でした。すでに大規模言語モデルをリクエストルーティング、チケット分類、優先度順位付け、結果検証に使っている人も多く、この投稿を見た後に三つの疑問が浮かびます。どのモデルを接続すべきか、置き換えるのはどのステップか、投稿の「10 倍速い、200 倍安い」は使えるのか、という点です。
結論は、固定の選択肢がある判断は Microsoft-Decision-1.1 に任せ、長文生成は引き続き大規模言語モデルに任せる です。Microsoft の GA 発表文は 2026-11-17 に正式提供を発表し、呼び出し方法も Microsoft Foundry のドキュメントに記載されています。本記事は GA 発表文と公式ドキュメントを基準とし、投稿はあくまで手がかりとして扱います。
本記事は投稿の転載ではありません。投稿内の倍数は何と比較したのかが明記されておらず、添付画像と Microsoft 内部のユースケースにそれぞれ「2.2 倍」がありますが、比較対象も異なります。本記事ではこれらを分けて説明します。私たちは 2026-11-18 に APIYI apiyi.com のモデル表と料金 API を確認し、その結果を料金セクションに記載しています。
本記事の価値:読み終えると、パイプラインのどのステップを Microsoft-Decision-1.1 に任せられるか判断でき、料金見積もりでどのドキュメントを見るべきかが分かり、まだ存在しないモデル ID を誤った API でテストすることもなくなります。
Microsoft Decision 1.1 の主要情報をざっと確認
まず公式情報と投稿の記述を分けておきます。以下の表には、マイクロソフトの GA 記事、Ignite Book of News、Foundry のドキュメントで確認できる内容だけを記載しています。
| 項目 | 内容 |
|---|---|
| 正式提供開始日 | 2026-11-17、マイクロソフトの GA 記事で発表 |
| モデル名 | Microsoft-Decision-1.1 |
| ベースモデル | Gemma 4 26B A4B(GA 記事と Ignite Book of News の記述が一致) |
| 用途 | ルーティング、分類、優先度付け、検証、フロー制御 |
| 動作方式 | 開発者が与えた選択肢の中から選び、キャリブレーション可能な信頼度を返し、不確実な場合は判断を下さないこともできる |
| 初版との比較 | 速度が2倍以上に向上、価格は低価格のまま、画像入力に対応 |
| 公式提供チャネル | Microsoft Foundry、OpenRouter、Vercel AI Gateway |
| APIYI apiyi.com の状況 | 2026-11-18 時点で確認したところ、モデル一覧と料金 API のいずれにも未収録 |
「与えられた選択肢の中から選ぶ」ことが、このモデルを理解する鍵です。文章は書かず、理由の説明もせず、あらかじめ設計された問いにだけ答えます。こうした作業は以前は大規模言語モデルが兼ねて担当していましたが、今は専用の小さなモデルに任せられます。
Microsoft-Decision-1.1 と Microsoft-Decision-1 は同じモデルではない
投稿の本文には Decision 1 と書かれ、画像は Decision 1.1 になっているため、両者を同じモデルと誤解しやすいです。実際にはベースモデルが異なり、リリース時期も異なります。導入前に、デプロイするのがどちらなのかを必ず確認してください。
| 比較項目 | Microsoft-Decision-1 | Microsoft-Decision-1.1 |
|---|---|---|
| リリース時期 | 2026-10 | 2026-11-17 正式提供開始 |
| ベースモデル | Qwen3.5-9B | Gemma 4 26B A4B |
| 入力価格(Foundry) | 0.042ドル / 100万トークン | 段階別課金、下記の価格表を参照 |
| 出力価格 | 無料 | 無料 |
| 画像入力 | 資料に言及なし | GA 記事に新規対応と明記 |
| 提供チャネル | Foundry、OpenRouter | Foundry、OpenRouter、Vercel AI Gateway |
| その他の情報 | OpenRouter のページにコンテキスト約33Kと記載 | マイクロソフトは初版より2倍以上高速と説明 |
10月に Microsoft-Decision-1 で評価スクリプトを書いた場合は、1.1 に切り替える際に再デプロイが必要で、デプロイ名も変更する必要があります。両版のベースモデルが異なるため、調整済みの信頼度しきい値も再検証してください。
Microsoft Decision 1.1 の呼び出し方法:チャット補完インターフェースではない
ここが最も間違いやすいポイントです。Microsoft の Foundry ドキュメントによると、Microsoft-Decision-1.1 の API タイプは Decision であり、よくある chat completions ではありません。リクエストは Foundry リソース上の /providers/microsoft/v1/systemone パスに送信し、リクエストボディの model フィールドにはモデル名ではなく、自分のデプロイ名を入力します。デプロイ時にはバージョン 1 を選択し、デプロイタイプは GlobalStandard にできます。一部のリージョンでは DataZoneStandard も選択可能です。
このモデルがサポートする質問タイプは 3 種類だけで、返されるのは回答と確率です。自由テキストも理由も返しません:
| 問題タイプ | 用途 | 返却内容 | 典型的なシナリオ |
|---|---|---|---|
noul |
はい/いいえを判定 | 0〜1 の確率 | この出力がコンプライアンスに適合しているか、この書類を人手でレビューすべきか |
choice |
固定選択肢から 1 つを選ぶ | 選択されたオプション | リクエストをどの下流モデルに送るか、チケットをどのカテゴリに分類するか |
score |
低から高へのスケールで採点 | スケール上の点数 | 緊急度の等級付け、回答品質のスコアリング |
そのため、もともと大規模言語モデル向けに「以下の 3 つのカテゴリから 1 つを選び、理由を説明してください」というプロンプトを書いていた場合、移行時には choice 問題タイプに変更して選択肢を列挙し、理由の部分はそのまま削除します。下流で本当にユーザーに見せる説明文が必要な場合は、大規模言語モデルに生成させます。
Microsoft Decision 1.1 の価格:マイクロソフトの GA 文書のリージョン別価格を基準に
以下はマイクロソフトの GA 文書に記載された料金で、日付は 2026-11-17 です。これは Microsoft Foundry の価格であり、APIYI の価格ではありません。
| デプロイ地域 | 入力価格(100万 token あたり) | 出力価格 |
|---|---|---|
| Global Standard | 0.042 ドル | 無料 |
| US Data Zone | 0.046 ドル | 無料 |
| EU Data Zone | 0.05 ドル | 無料 |
| APAC Data Zone | 0.05 ドル | 無料 |
Ignite Book of News には「第1版と同様の競争力のある価格」と書かれています。しかし、Global Standard だけが第1版の 0.042 ドルと一致し、3つのデータゾーンの価格はいずれも高くなっています。そのため、コスト表を作成する際は GA 文書のリージョン別価格を基準にすべきです。また、出力が無料なのは、このモデルが回答と確率だけを返し、出力自体が非常に短いためです。コストは主に、毎回どれだけのコンテキストを投入するかによって決まります。
次に、現在 APIYI 経由で呼び出せるかどうかについて。APIYI(apiyi.com)は OpenAI 互換の統一インターフェースを提供しており、アドレスは https://api.apiyi.com/v1 です。これはチャット補完系のインターフェースです。Decision モデルは回答と確率だけを返す別のインターフェースを使用しているため、たとえ将来掲載されたとしても、モデル ID を通常の対話リクエストに入れてテストすることはできません。私たちは 2026-11-18 に APIYI のモデル一覧と価格インターフェースを確認しました。当時は合計 283 個のモデルがあり、その中に Microsoft-Decision-1、Microsoft-Decision-1.1 はなく、decision 関連の ID も一切ありませんでした。モデル一覧に MAI の文字を含むものは、画像モデルの MAI-Image-2.6 と MAI-Image-2.6-Flash だけであり、この Decision モデルとは別の製品です。現在は未掲載ですが、できるだけ早くこのモデルを掲載する予定です。モデルと価格はプラットフォームのモデルリストを基準にしてください。
投稿内の数字の読み方:3組の倍率、3つの比較対象
TestingCatalog の投稿には「10倍高速、200倍安価」と書かれています。さらに2つの「2.2倍」があり、それぞれランキング画像と Microsoft の内部ユースケースに由来します。これらの比較対象はそれぞれ異なるため、1つの文にまとめることはできません。
| 数字 | 出典 | 比較対象 | コスト表に記載できるか |
|---|---|---|---|
| 10倍高速、200倍安価 | TestingCatalog 投稿の本文 | 名前が明示されていない汎用モデル。GA文には対応する比較対象が見つからない | できない |
| スコア68、Decision 1 より6ポイント高い、2.2倍高速 | 投稿の添付画像、すなわち Artificial Analysis のランキング画像 | Microsoft-Decision-1 | ランキングの参考としてのみ |
| 2.2倍高速、コストは相手の約1/4.4 | Microsoft のGA文、Copilot の内部ユースケース | ある大規模言語モデル | Microsoft の自己申告としてのみ |
ランキング部分は、Microsoft が引用した Artificial Analysis Decision Index v2.1 に由来します。この引用によると、Microsoft-Decision-1.1 はスコア68で、第1版より6ポイント高く、Jev 1.14、Google Gemini Decision 1、OpenAI GPT-6 Luna(Decisions)よりも高い結果になっています。GA文には同時に「第1版より2倍以上高速で、コストは同じ」と書かれています。これらは公式が引用したランキング結果であり、当社のテストデータではありません。ランキングの順位は、あなたが支払う費用とイコールではありません。
Copilot の例はまた別の話です。Microsoft は Copilot 内でこれを使い、あるリクエストを Copilot に渡すべきか Cowork に渡すべきかを判断しています。精度はある大規模言語モデルと同等、速度は2.2倍、コストはその大規模言語モデルの約1/4.4です。この2.2倍の比較対象は「ある大規模言語モデル」であり、添付画像の2.2倍が比較しているのは Decision 1 です。2つの数字はたまたま同じなだけです。
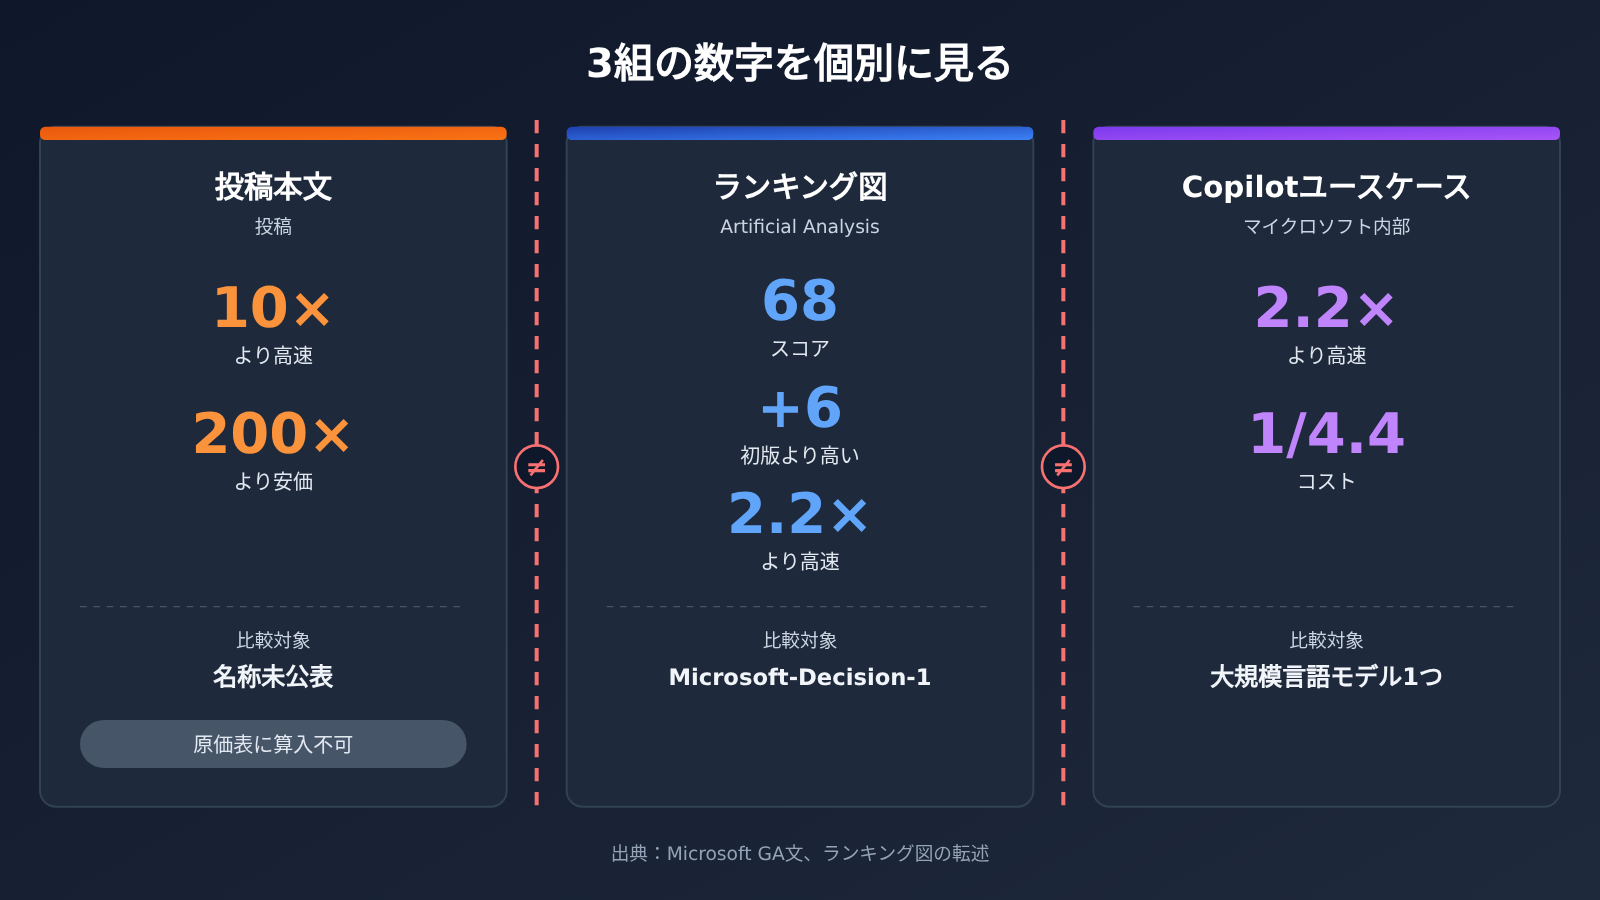
上の図では3組の数字を分けて配置しています。データソースは Microsoft のGA文とランキング画像の引用で、整理は APIYI apiyi.com 技術チームが行いました。自社テストの結果は一切含まれていません。
Microsoft Decision 1.1 の影響分析
開発者への影響:ルーティングとスコアリングはこのモデルに、長文は大規模言語モデルに
すでに大規模言語モデルでルーティング、分類、優先順位付け、検証を行っているなら、今回置き換えられるのは「判断する」ステップだけです。内容を生成するステップは変わりません。Microsoft-Decision-1.1 は固定された選択肢の中から答えと確信度を返すだけであり、この特性が「どこに置くべきか」を決めます。導入時は、次の順序で役割を分解できます。
- 許可する選択肢を列挙する:元のプロンプトにある「判断してください」を、明確な選択肢のリストに変えます。たとえば下流モデル名、チケットのカテゴリ、リスクレベルなどです。選択肢を書き出せないなら、そのステップはまだこのモデルに任せる段階ではありません。
- 問題タイプを選ぶ:はい/いいえの二値問題には
noul、単一選択にはchoice、段階評価にはscoreを使います。文章を出力させようとしてはいけません。 - 確信度のしきい値を設定する:校正可能な確信度を返し、判断しないこともできます。しきい値以上の結果はそのまま実行し、しきい値未満はフォールバックフローへ送ります。
- 不確かなときは人または大規模言語モデルに戻す:確信度の低いリクエストは人によるレビューに回すか、大規模言語モデルに再判断させます。このステップはフローに明記し、省略できません。
- 説明文は大規模言語モデルに任せる:ユーザー向けの返信、長文、コード、解説はすべて大規模言語モデルが生成します。Decision モデルは、この内容を誰が書くか、どの経路を通るかを決めるだけです。
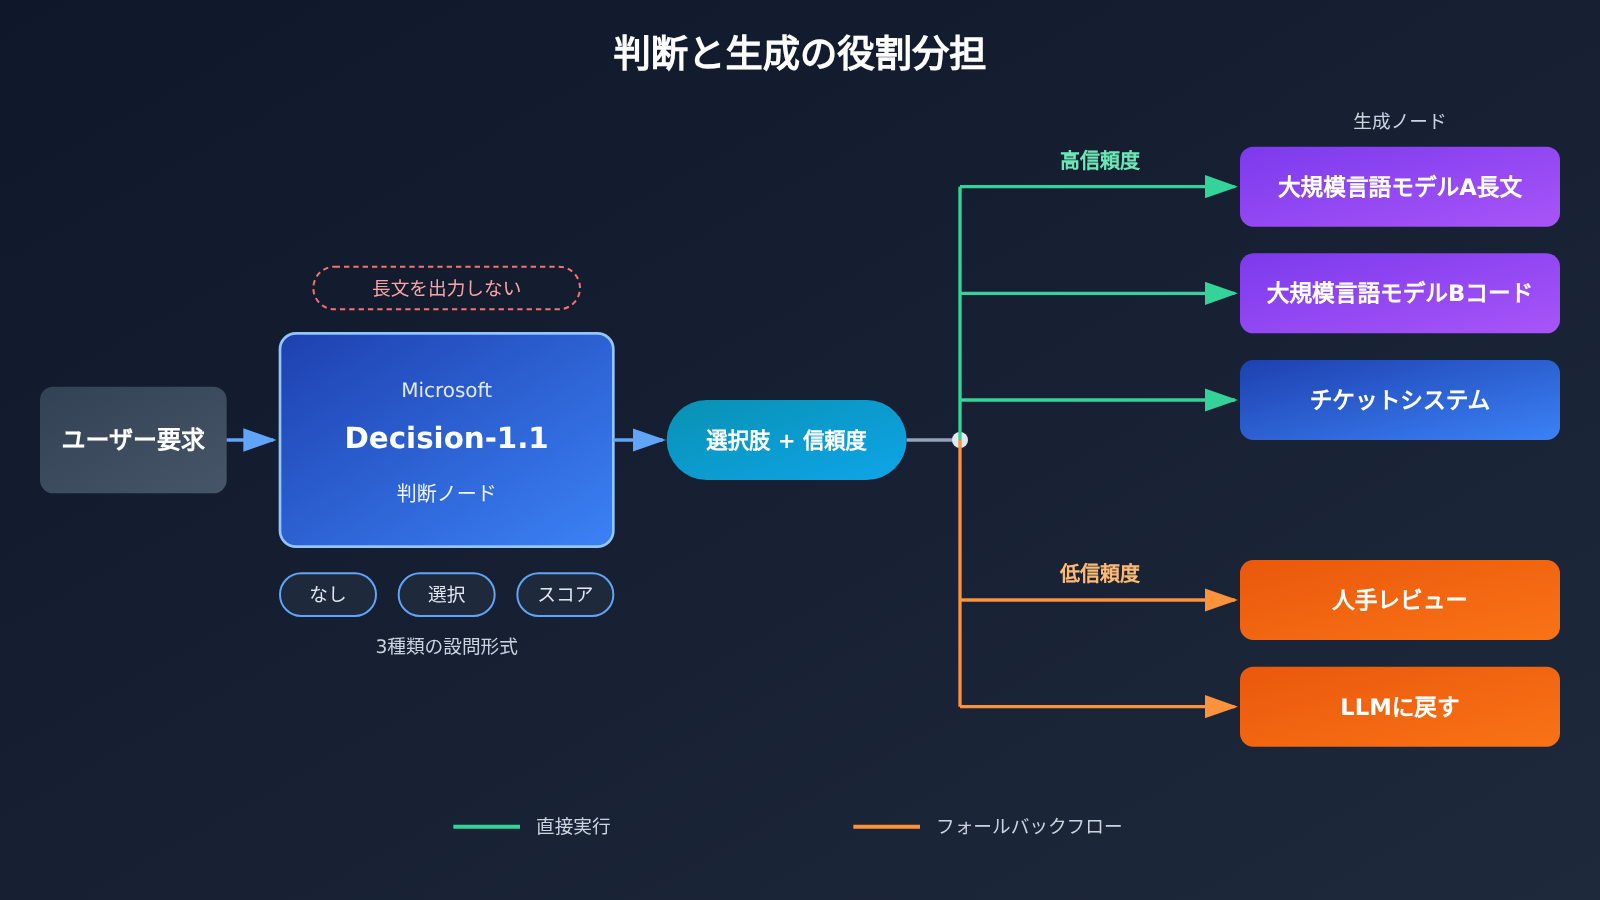
この順序で分解すると、判断ノードと生成ノードの責務が分離され、問題の切り分けも容易になります。ルーティングが間違っていれば判断ノードを調べ、内容の出来が悪ければ大規模言語モデルを調べます。大規模言語モデル側は変更不要で、これまで APIYI(apiyi.com)経由で呼び出していた対話モデルを、そのまま長文生成に使い続けられます。
既存パイプラインへの影響:どのステップが置き換えに適しているか
すべての「判断」タスクが移行に適しているわけではありません。以下、よくあるシナリオごとに簡単に整理します。
- 移行に適している:リクエストを異なるモデルに振り分ける処理、カスタマーサポートのチケット分類、コンテンツに人手による審査が必要かどうか、緊急度の分類、出力フォーマットがコンプライアンスに適合しているかの検証。これらはいずれも選択肢が固定されており、結果をプログラムが直接利用できます。
- 慎重に移行すべき:選択肢が多く頻繁に変わる分類、大量のコンテキストを組み合わせる必要がある判断。第1版ではOpenRouterでコンテキストが約33Kと記載されています。1.1の具体的なコンテキスト長はFoundryのドキュメントに従ってください。超長い入力はまず切り詰めるか要約する必要があります。
- 移行に適していない:理由の出力が必要な審査意見、書き換えや補完が必要なコンテンツ、オープンエンドの質問応答。これらは依然として大規模言語モデルの仕事です。
もう一点注意すべきことがあります。このモデルは回答と確率だけを返すため、従来は大規模言語モデルが「ついでに理由を出す」ことに依存していたログや監査記録では、その部分が欠けることになります。コンプライアンス上、理由を保持する必要がある場合は、低信頼度または拒否されたサンプルに限って再度大規模言語モデルを呼び出して説明を生成すれば、毎回長文のコストを支払う必要はありません。
業界への影響:専用の小型モデルが大規模言語モデルの判断タスクを分担
今回の発表から一つの方向性が見えます。判断系のリクエストを汎用の大規模言語モデルから切り離し、専用の小型モデルに処理させるという方向です。投稿で言及されていた競合製品の名称、そしてランキングに登場する Google Gemini Decision 1、OpenAI GPT-6 Luna(Decisions)は、これがすでに独立したカテゴリーとして成立していることを示しています。
開発者にとって、これは2つの変化をもたらします。
- コスト構造:判断系のリクエストは入力ベースの課金で出力は無料となり、コストは主にプロンプトの長さで決まります。コンテキストを簡素化する効果は以前より明確になります。
- 評価方法:判断ノードは精度と信頼度のキャリブレーションを個別に評価する必要があり、最終的な回答が良いかどうかだけでは判断できません。ランキングのスコアは一次スクリーニングに使えますが、最終的には自社の業務サンプルで検証する必要があります。
まず大規模言語モデル側の効果を比較したいチームは、APIYI apiyi.com の統合インターフェースを使って複数の対話モデル間で切り替えテストを行うことができます。判断ノードが Foundry 上で動作するようになったら、両端を組み合わせてください。
Microsoft Decision 1.1 の核心ポイント(Key Takeaways)
- バージョンを混同しない:1.1 のベースは Gemma 4 26B A4B、10 月の Decision 1 のベースは Qwen3.5-9B です。
- 選択肢がある判断だけを行う:ルーティング、分類、優先度、検証はこれに任せ、長文は引き続き大規模言語モデルが生成します。
- 3 種類の設問形式:
noul、choice、scoreがあり、答えと確率のみを返し、理由は返しません。 - 呼び出しパスが異なる:リクエストは
/providers/microsoft/v1/systemoneに送信し、modelフィールドにはデプロイ名を指定します。 - 価格は GA 文書を参照:Foundry の入力価格はゾーン別で 0.042~0.05 ドル/100 万トークン、出力は無料です。
- 投稿の倍数はコスト表に含めない:10 倍、200 倍には比較対象が明示されておらず、2 つの 2.2 倍も個別に解釈する必要があります。
- APIYI の状況:2026-11-18 時点で APIYI apiyi.com のモデル表にこの ID はありません。チャットインターフェースでのテストは避けてください。
まとめ
Microsoft-Decision-1.1 の位置づけは明確です。これはパイプラインの中の判断ノードであり、執筆ツールではありません。
- 用途:開発者が指定した選択肢の中でルーティング、分類、スコアリング、検証を行い、信頼度を提示します。不確かな場合は判断を見送ることもできます。
- 境界:自由記述の文章も理由も書きません。長文、コード、説明は引き続き大規模言語モデルに任せ、信頼度の低い結果は人または大規模言語モデルがフォローアップします。
- コストの根拠:Microsoft の GA 文書にある 2026-11-17 の Foundry ゾーン別価格を基準にします。投稿内の倍数やランキング順位は見積もりとして扱えません。
まずは選択肢が固定され、ログが完全に揃った判断ステップを 1 つ選び、Foundry 上で自社のサンプルを使って精度としきい値をテストしてから、範囲を広げるかどうかを決めることをおすすめします。コンテンツ生成側では、引き続き APIYI apiyi.com 経由で各社の対話モデルを呼び出せます。Decision モデルの提供状況は、プラットフォームのモデル一覧を基準にしてください。
📚 参考資料
-
Microsoft Microsoft-Decision-1.1 正式提供開始のお知らせ:GA 公告文。用途、リージョン別価格、ベンチマークの引用、Copilot 社内でのユースケースを含む
- リンク:
aka.ms/decision-model-ga - 説明: 本文中の価格と公式の性能に関する記述は、これを基準とします
- リンク:
-
Microsoft Ignite 2026 Book of News:ベースモデルと価格に関する記述
- リンク:
news.microsoft.com/events/ignite/2026/book-of-news/ - 説明: ベースは Gemma 4 26B A4B。詳細な価格は引き続き GA 公告文を基準とします
- リンク:
-
Microsoft Foundry ドキュメント:Microsoft Decision モデルの使用:デプロイと呼び出しの方法
- リンク:
learn.microsoft.com/en-us/azure/foundry/foundry-models/how-to/use-foundry-models-microsoft-decision - 説明: Decision API のタイプ、リクエストパス、および 3 種類の設問形式についての公式説明
- リンク:
-
Microsoft-Decision-1 公開記事(2026-10):前バージョンの情報
- リンク:
commandline.microsoft.com/microsoft-decision-1-model-foundry - 説明: Decision 1 と 1.1 を区別するために使用します
- リンク:
-
OpenRouter モデルページ:2 バージョンのサードパーティ接続ページ
- リンク:
openrouter.ai/microsoft/microsoft-decision-1.1 - 説明: 第 1 版のページにはコンテキストが約 33K と記載されています
- リンク:
-
TestingCatalog の投稿:今回の議論の出発点
- リンク:
x.com/testingcatalog/status/2122759893174178173 - 説明: これは引用であり、その中の倍数は見積もりの根拠とはしません
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからお問い合わせください。より詳しい資料は docs.apiyi.com ドキュメントセンターをご覧ください


