
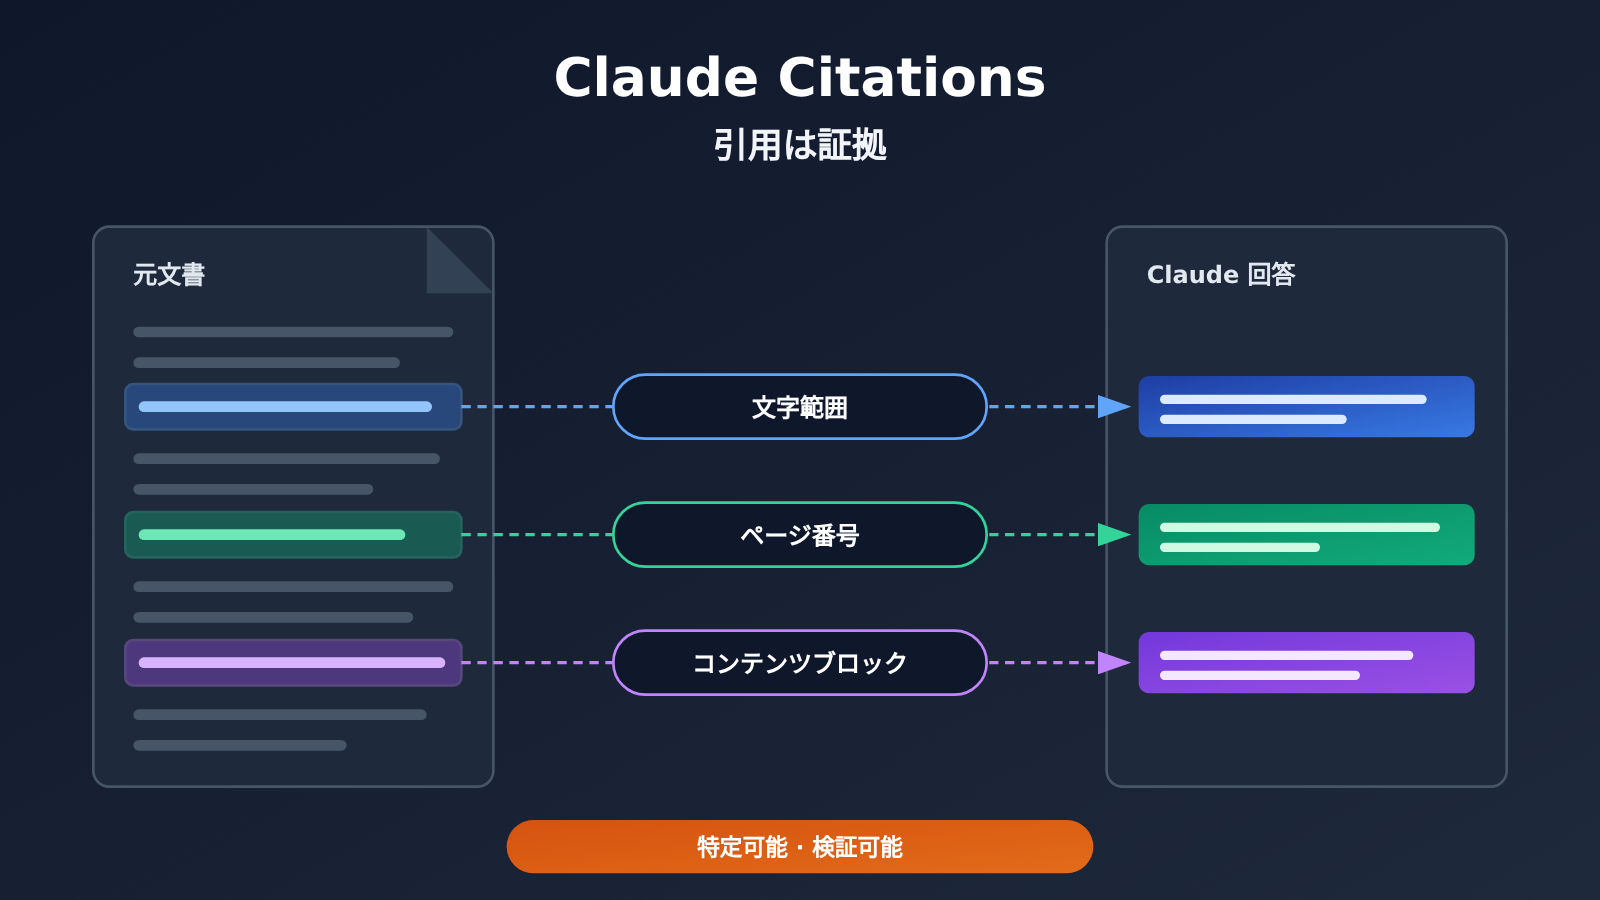
端的な回答:Claude Citations を使うと、モデルの回答を、ユーザーが提供したドキュメント内の具体的な箇所と位置に向けることができます。 プレーンテキストは文字範囲、PDF はページ、カスタムコンテンツはブロック単位で位置を特定します。引用を実際に検証可能にする鍵はアプリケーション側にあります。各結論について、フィールド値、対応する引用オブジェクト、限定条件をまとめて保存することです。構造化データへ変換する過程で、引用を失ってはいけません。
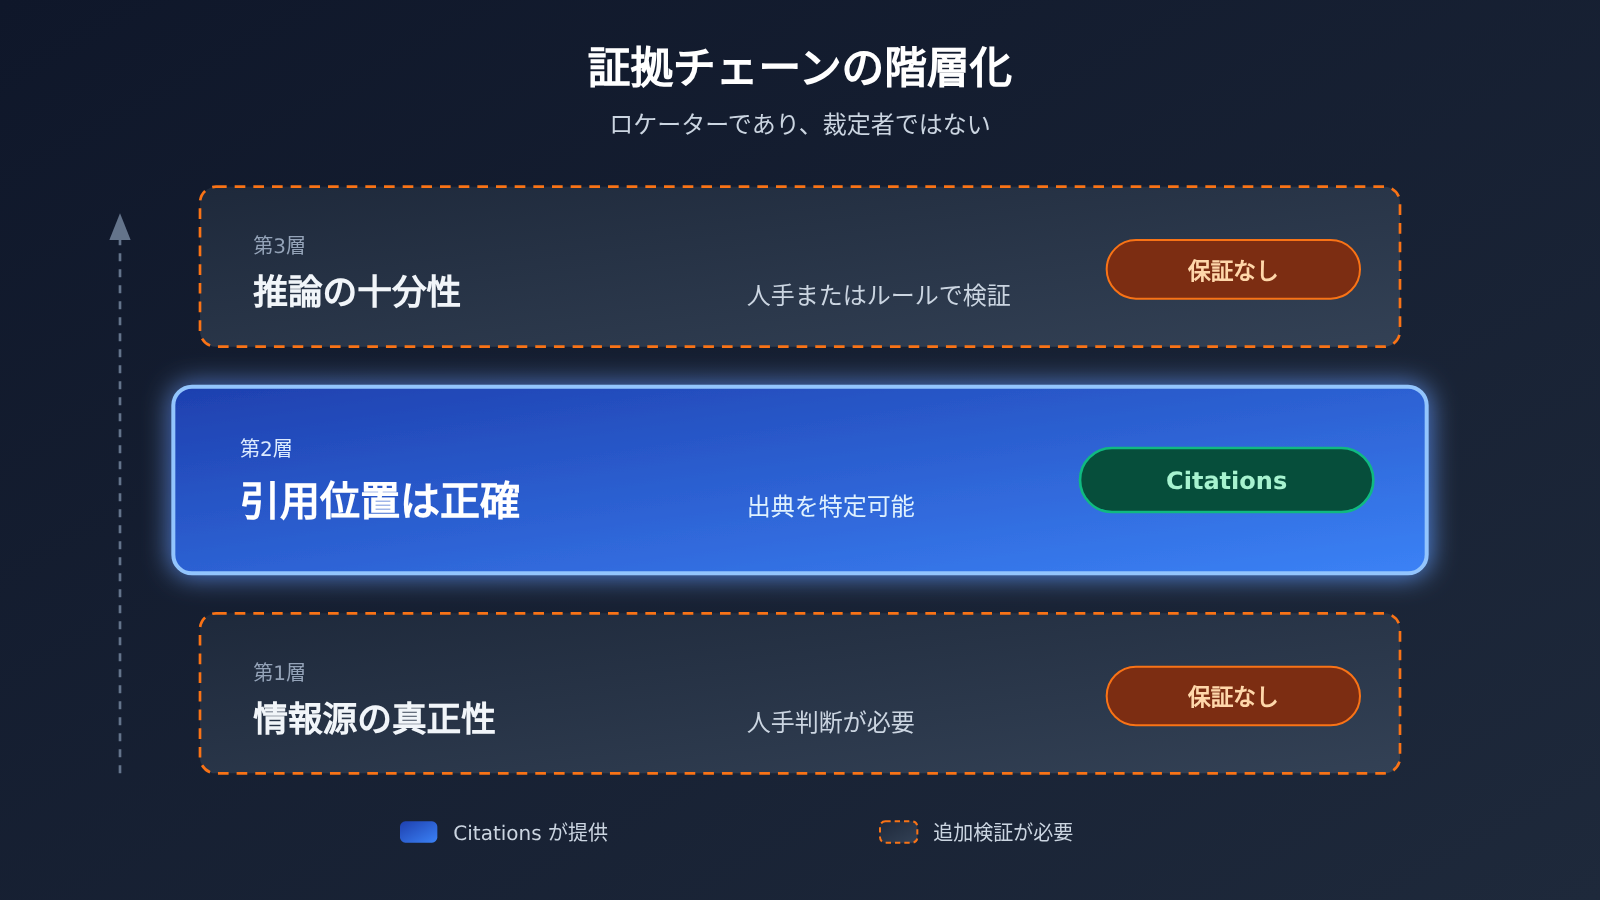
注意すべき点として、引用位置が正しいことは「その文がドキュメント内で見つかる」ことだけを意味し、情報源そのものが真実であることや、推論が十分であることを意味しません。Citations は人による検証を支えるツールであり、検証の代替にはなりません。
この記事を読むと分かること
- Claude Citations がどの入力に対して有効か、また 3 つの位置特定方式がそれぞれ何か。
- 引用を有効にした状態で、厳密な構造化出力
output_config.formatを同時に使えない理由と、公式が推奨する代替手法。 - スキャンした PDF と画像に対する引用機能の制限、およびアプリケーション側で取れる補完方法。
- 「フィールド値+引用+限定条件」というデータ構造をどう設計すれば、価格、コンテキスト長、地域などの情報が検証に耐えられるか。
目次: 本文の導入部分では、まず概念表で関連用語を説明し、続いてこの機能がさまざまな利用者に与える影響を説明します。「客観的事実」の部分では、公式ドキュメントに基づいて位置特定方式、互換性の競合、入力制限を整理します。「分析・判断」の部分では、引用を検証可能な証拠として残す方法と、外部に向けて断言してはいけない主張について論じます。
Claude Citations でまず押さえておきたい概念
| 概念 | 簡単な説明 |
|---|---|
| Citations(引用) | Claude API の機能のひとつで、回答の中にユーザーが提供した文書からの引用断片とその位置を返します |
| 文字範囲による位置指定 | プレーンテキスト文書の引用方式で、引用された原文を文字の開始・終了位置で示します |
| ページ番号による位置指定 | PDF 文書の引用方式で、ページ単位で出典を示します |
| コンテンツブロックによる位置指定 | カスタムコンテンツの引用方式で、開発者が独自に分割したブロック単位で示します |
| 厳密な構造化出力 | output_config.format によってモデルの出力を指定形式に制約するもので、引用機能とは同時に有効化できません |
| 抽出可能テキスト | PDF 内で直接読み取れるテキスト層のことです。スキャンした文書には通常この層がありません |
| OCR | 光学文字認識のことで、画像内の文字をテキストに変換します。アプリケーション側の処理であり、Claude の引用機能ではありません |
| 制約条件 | ある数値が成立する前提のことです。たとえば課金単位、モデルバージョン、適用地域などが該当します |
Claude Citations の影響をひと目で
| 対象 | 影響 |
|---|---|
| 開発者 | 質問応答、検索拡張、資料抽出といったアプリに位置指定可能な出典を付けられます。ただし構造化出力と引用のどちらかを選ぶ必要があり、解析ロジックも自分で設計する必要があります |
| コンテンツ担当者・研究者 | 確認の際に原文の断片やページへ直接ジャンプでき、ページを一枚ずつ探す手間を減らせます。ただし出典が信頼できるか、結論が成り立つかは自分で判断する必要があります |
| 製品・運用担当者 | 「価格、仕様、ポリシー」のように出典を必ず示す必要がある情報表示に適しています。スキャン資料は先にテキスト化と検証を済ませておく必要があります |
| 一般ユーザー | 出典付きの回答を見れば自分で確認しやすくなりますが、「引用がある」を「必ず正しい」と受け取るべきではありません |
Claude Citations の客観的事実
以下の事実は Claude 公式ドキュメント(出典:platform.claude.com/docs/en/build-with-claude/citations、確認日 2026-11-17)に基づいて整理したものです。このページは継続的にメンテナンスされているドキュメントであり、本記事ではこの機能の最初の公開日を確認できなかったため、初出時期については記載しません。
Claude Citations の3つの位置指定方法
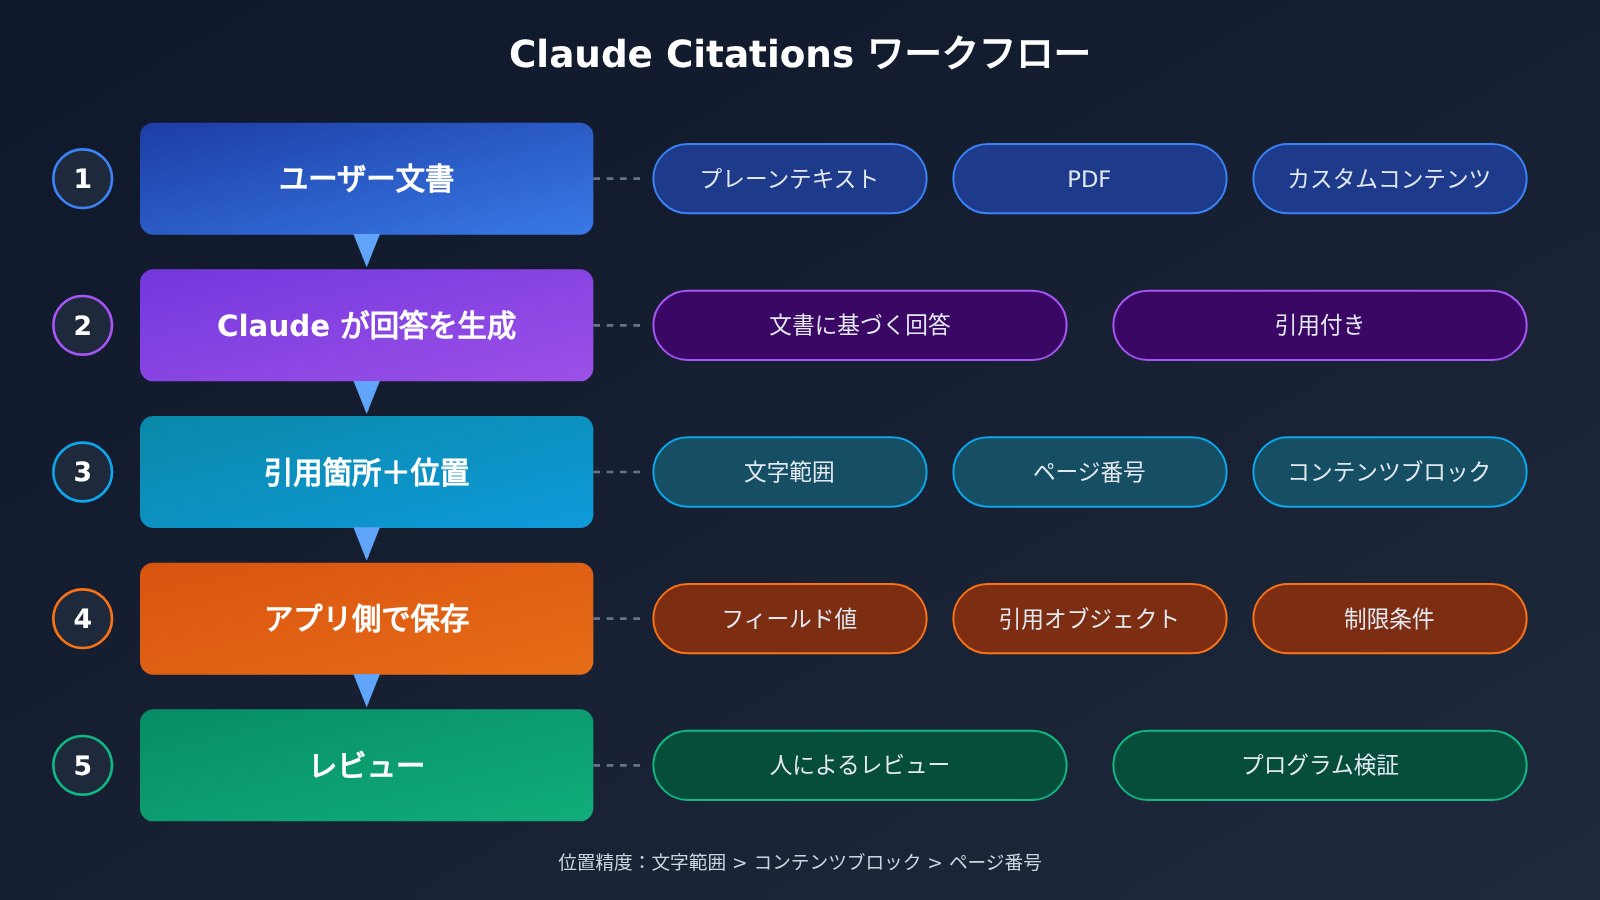
Citations が対象とするのはユーザー自身が提供したドキュメントです。モデルは回答を返す際に、引用した原文の断片と、それがドキュメント内のどこにあるかを合わせて返します。位置指定の粒度はドキュメントの種類によって異なります。
| ドキュメント種別 | 位置指定方法 | 確認時の使い方 |
|---|---|---|
| プレーンテキスト | 文字範囲 | 開始・終了位置で原文を切り出し、一字一句照合できる |
| ページ番号 | 該当ページへ移動して目視確認する。ページ内の具体的な位置は自分で探す必要がある | |
| カスタムコンテンツ | コンテンツブロック | 開発者が分割したブロック単位で照合する。粒度は分割の仕方次第 |
ご覧のとおり、3つの方法の精度は同じではありません。文字範囲は最も細かく、プログラムによる検証に向いています。ページ番号による指定は、ページ内を人手で探す必要があります。コンテンツブロックの精度は、開発者がどう分割するかに完全に左右されます。ブロックを大きく切りすぎると、引用自体は「正しい」ものの、確認にかかるコストが明らかに膨らんでしまいます。
Claude Citations と厳格な構造化出力は互換性がない
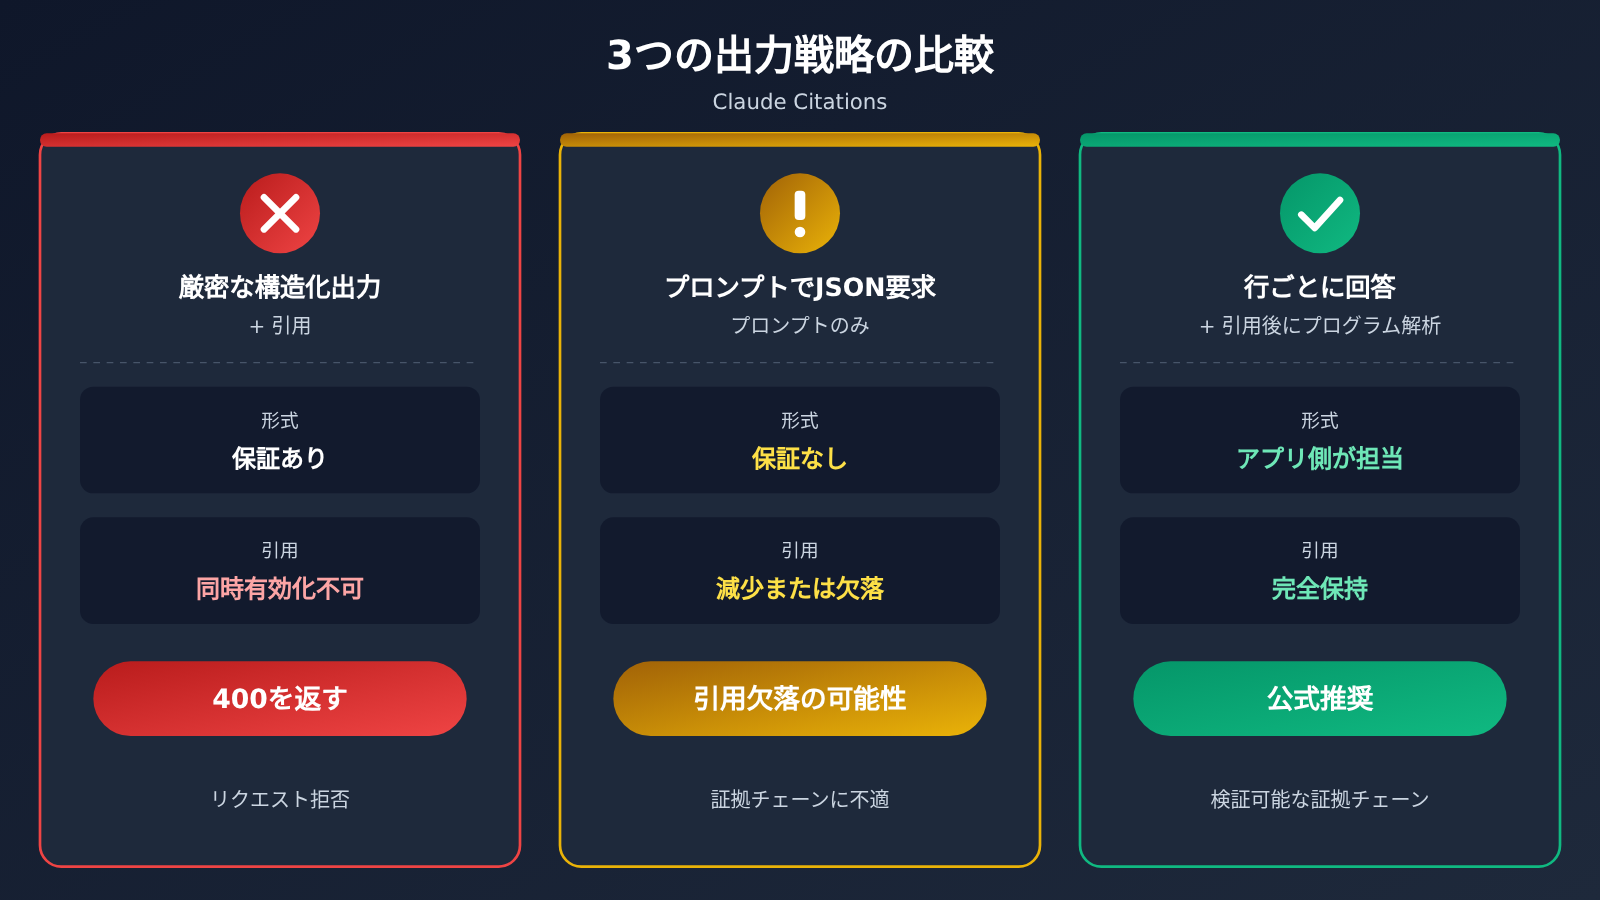
これは実装時に最もつまずきやすい落とし穴です。公式ドキュメントには、引用を有効にすると厳格な構造化出力 output_config.format を同時に使用できず、両方を同時に有効にするとリクエストが 400 エラーを返すと明記されています。
公式が提示している代替案は、モデルにフィールドごと、行ごとに回答させて引用を付け、その後プログラムで必要な構造に解析するというものです。もう一つ、実現できそうに見える方法として、プロンプトでモデルに JSON を出力するよう求めるだけというやり方もあります。この方法では確かに JSON が得られることもありますが、引用が少なくなったり、まったくなくなったりする可能性があります。この2つの方法は区別して考える必要があります。
- 厳格な構造化出力:フォーマットは保証されますが、引用と同時に有効にすることはできません。
- プロンプトだけで JSON を要求:フォーマットは保証されず、引用も欠ける可能性があるため、証拠チェーンには適していません。
- フィールドごと・行ごとの回答+引用、その後プログラムで解析:公式推奨の方法で、フォーマットはアプリケーション側が担い、引用は保持されます。
Claude Citations の入力制限
| 入力状況 | 直接引用できるか | 説明 |
|---|---|---|
| テキストレイヤー付きPDF | 可能 | ページ単位で位置を特定できる |
| 抽出可能なテキストがないスキャンPDF | 直接引用は不可 | テキストレイヤーを欠くため、テキストの位置を特定できない |
| 画像 | 非対応 | 引用機能は画像の内容をカバーしない |
| OCRで変換したテキスト | アプリ側の処理次第 | OCRはアプリ側の推奨手法であり、画像引用機能ではない |
ここで「直接引用できない」という点は、正確に理解しておきたいところです。これは、スキャンPDFが抽出可能なテキストを欠いている場合に直接引用できないという意味であり、スキャン資料すべてが永久に扱えないというわけではありません。開発者はまずアプリ側でテキストを取得し、そのテキストをドキュメントとしてモデルに渡すことができます。
効果向上に関する記述について
ベンダーは引用機能について、約20%の向上という表現を示したことがあります。この数値はあくまでベンダー自身の声明に由来するもので、本記事では独自の検証を行っていません。また本記事では性能テストも一切実施していないため、定量的な効果についての結論は提示しません。
Claude Citations の分析判断
以下は上記の事実に基づく解釈と提案であり、著者の判断であって公式な結論ではありません。
Claude Citations を「フィールド値+引用+限定条件」として実装する
引用の本当の価値は、すべての結論を追跡・検証できるようにすることにあります。最終的にデータベースへ保存されるのが「128K」や「3ドル」といった数値ひとつだけなら、引用はデータ変換の過程で失われてしまい、後からその数値がどこから来たのか、どのような条件で成立するのかを誰も確認できなくなります。
より堅実な方法は、事実型の各フィールドに対して三つの部分を保存することです。フィールド値、引用オブジェクト、限定条件です。以下はアプリケーション側のデータ構造の例です。フィールド名は開発者が自由に決めるものであり、Claude API の返却フォーマットではありません:
{
  "field": "input_price",
  "value": "3",
  "qualifiers": {
    "unit": "USD per million input tokens",
    "model_version": "<文書に記載されたバージョン>",
    "region": "<適用地域。文書に記載がなければ null>"
  },
  "citation": {
    "doc_id": "pricing-2026-11",
    "location_type": "page",
    "location": "<モデルが返したページ番号または文字範囲>",
    "quoted_text": "<モデルが返した原文の抜粋>"
  },
  "verified": false
}
サンプル内の価格の数値は構造を示すためのものであり、実際の価格を表すものではありません。設計上の要点は次のとおりです:
- 価格は必ず課金単位を保持する:同じ数字でも、1千トークンあたりと百万トークンあたりでは、意味が千倍も異なります。
- 能力は必ずバージョンを保持する:コンテキスト長や機能のサポート状況はモデルのバージョンによって変わるため、バージョンから切り離された数値はすぐに陳腐化します。
- 地域に関する情報は適用範囲を明記する:文書に記載がない場合は空欄にし、自分で推測して補完しないこと。
- 原文の抜粋を保持する:再確認時に直接照合でき、モデルを再度呼び出す必要がありません。
厳密な構造化出力の代わりに、行ごとの回答を使う
引用と output_config.format は同時に有効にできないため、エンジニアリングとしては「フォーマットは自分で管理する」という方針を受け入れる必要があります。実現可能な流れは次のとおりです。
- プロンプトで抽出したいフィールドを一つずつ列挙し、モデルには1行につき1つのフィールドだけを回答させ、その行に引用を付けるよう指示します。
- アプリケーション側では行単位で解析し、各行の回答テキストとそれに付随する引用オブジェクトを1対1で対応させます。
- 固定されたルールでテキストを目的の構造に変換し、同時に引用をそのまま
citationフィールドに書き込みます。 - 引用がない行にはマークを付け、人手によるレビューに回すか、そのまま破棄します。確認済みの事実としてデータベースに登録することはしません。
この方法は、JSONを直接取得する場合に比べて解析ステップが1つ増えますが、その代わりに各フィールドに出典が付きます。価格やコンプライアンス条項のように、間違いのコストが高い情報にとっては、この工程にコストをかける価値があります。
スキャン資料:まず文字を取得し、その後で二次検証を行う
スキャンしたPDFを扱う場合、アプリケーション側ではまずOCRで文字を取得し、それをモデルに渡して引用させることができます。ただし、OCR自体にも誤差が入り込むため、少なくとも次の項目を検証する必要があります。
- 数字と単位:小数点、桁区切り、通貨記号は認識ミスが最も多く、しかもそれらは価格情報の核心です。
- 表の構造:行と列がずれると、数値が誤った項目に対応してしまい、引用位置がどれだけ正確でも意味がありません。
- ページ番号の対応:OCRテキスト内の位置が元のスキャンページに遡って対応できる必要があります。そうでなければ、レビュー担当者が出典を見つけられません。
つまり、このパイプラインにおいて、引用が指し示すのはOCRテキストであり、元のスキャン画像ではありません。信頼性の上限はOCRの品質によって決まります。
Claude Citations が証明できること・できないこと
引用があれば回答の検証可能性は高まりますが、対外的に説明する際は慎重さが求められます。以下に挙げる表現は根拠が乏しく、使うべきではありません。
- 「自動でネット検索して裏付けを取る」:Citations が対象とするのはユーザーが提供したドキュメントであり、ネット検索は関与しません。
- 「幻覚ゼロ」:引用位置が正確であることは、モデルの要約や推論に偏りがないことを意味しません。
- 「情報源は必ず信頼できる」:元のドキュメント自体に誤りがあれば、引用はその誤りを正確に指し示すだけです。
- 「すべてのスキャンPDFは処理できない」:制約は、抽出可能なテキストがない場合に直接引用できないという点にあり、アプリケーション側には補完手段が残されています。
より正確な位置づけはこうです。Claude Citations は「この文がどこから来たのか」という立証コストを下げるものであり、「この文が正しいかどうか」は依然として人間またはルールによる判断が必要です。
今後注目すべき方向性
以下の内容は予測または今後の観察事項であり、すでに確認された事実ではありません。
- 引用と厳密な構造化出力が将来のバージョンで両立できるかどうか。両立すれば、前出の行単位解析の手法は大幅に簡素化できます。
- 引用機能が画像やスキャンページの視覚的位置指定に拡張されるかどうか。現時点ではドキュメントが画像引用を明確にサポートしていません。
- ベンダーが謳う効果の向上が、さまざまな種類のドキュメントで成り立つかどうかは、第三者または自社業務のデータによる検証が必要です。
これらの問いに明確な答えが出るまでは、Claude Citations を証拠チェーンにおける「ロケーター」として扱い、「審判」と見なさないのが安全な戦略です。
尽信書、則不如無書。——『孟子・尽心下』


