
著者注:この記事では、openJiuwen Hyper-Agent の常駐型エージェントアーキテクチャを解説し、ワークフローを構築する方が、この方式が自分たちのチームに適しているかを判断するための情報をお届けします。
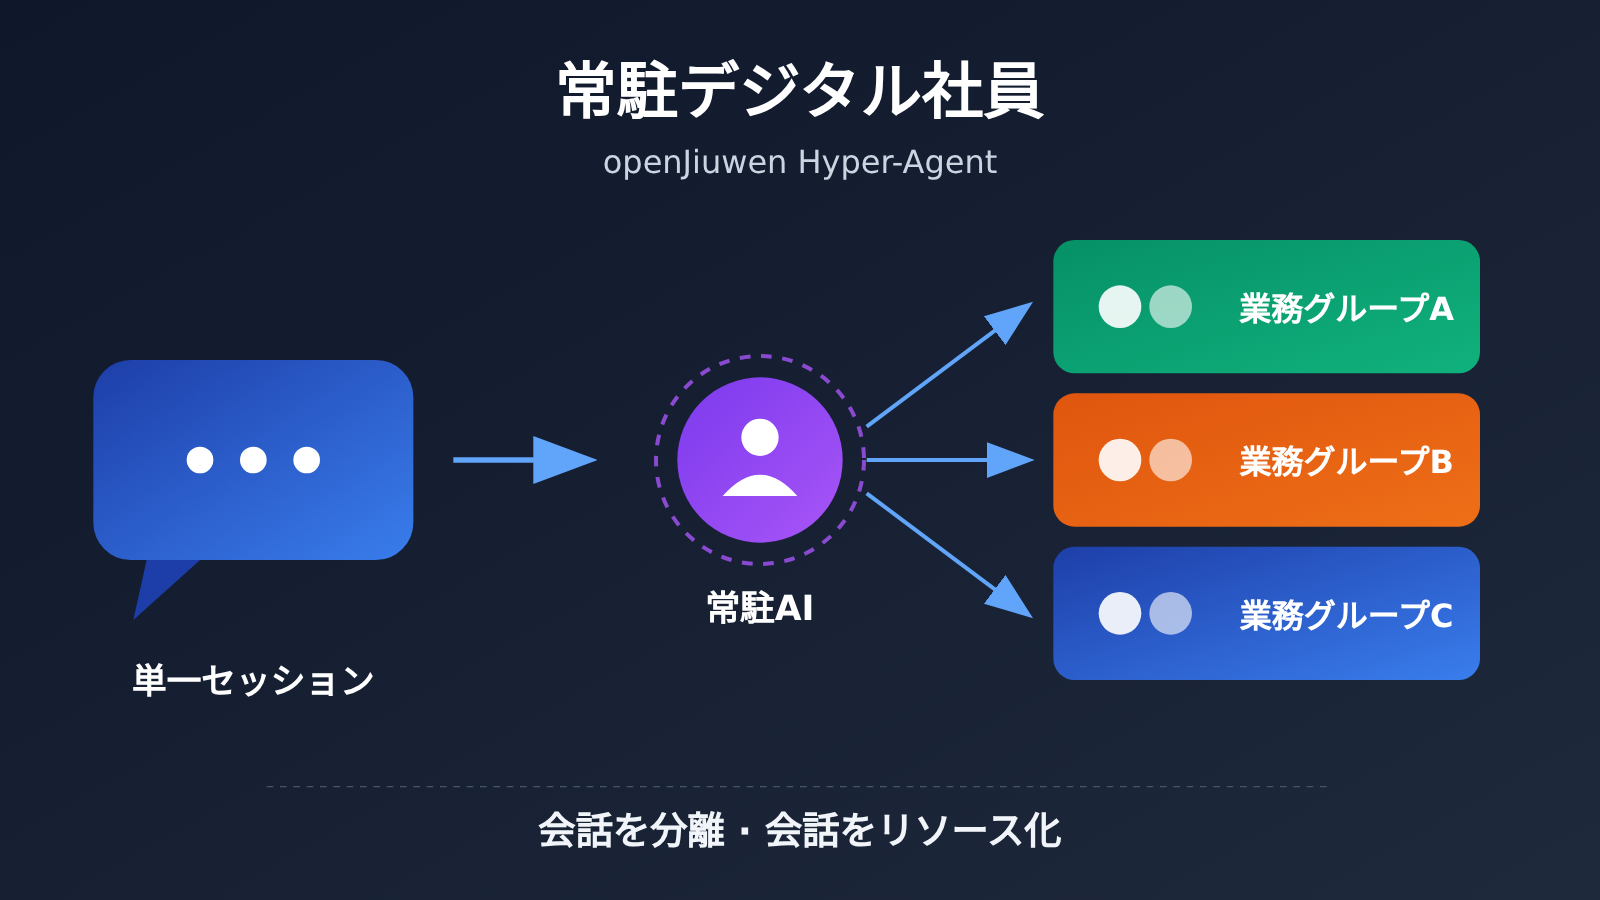
華為が支援するオープンソースのエージェントコミュニティ openJiuwen が、Hyper-Agent スウォームアーキテクチャを公開しました。エージェントが単発のチャットセッションを飛び出し、「常駐するデジタル社員」として実際の業務グループに参加できるようになります。Pandaily は2026年11月5日、IT之家が掲載したコミュニティの記事を引用し、関連機能が openJiuwen WorkSwarm ですでに提供されており、コードは JiuwenSwarm の名前で GitHub に公開されていると報じました。
これは、グループチャットに質疑応答用のボットを追加するだけのものではありません。本当の変化は、エージェントとセッションの主従関係が逆転した点にあります。セッションはもはやエージェントを収める容器ではなく、システムが割り当てられるリソースになります。
この記事のポイント:個別に紹介されている機能をアーキテクチャの視点で整理し、openJiuwen Hyper-Agent が何を変えるのか、またチームで採用する前に何を確認すべきかを解説します。
openJiuwen Hyper-Agent の主な情報
| 項目 | 内容 |
|---|---|
| 公開元 | openJiuwen オープンソースエージェントコミュニティ(華為が支援) |
| 報道日 | 2026年11月5日 |
| 中核アーキテクチャ | Persistent Agent を中核とする Hyper-Agent スウォームアーキテクチャ |
| 提供製品 | openJiuwen WorkSwarm、オープンソースコード名は JiuwenSwarm |
| 協働の窓口 | インスタントメッセージアプリ、Web インターフェース、ネイティブの SwarmEngine グループチャット |
| 言及された業務アプリ | 飛書、DingTalk など |
| 混在させられるサードパーティ製エージェント | Codex、Claude Code など |
なお、この記事の事実関係は、コミュニティの記事をもとにした二次報道に基づいています。報道では、基盤モデルの一覧、デプロイ要件、ライセンス、本番環境での成熟度は明らかにされていません。これらは GitHub リポジトリや公式ドキュメントと照らし合わせて確認する必要があります。
openJiuwen Hyper-Agent はセッションをどうリソース化するのか
一般的なエージェントアプリケーションの多くは、「1つのセッションに1つのエージェント」という方式を採用しています。ユーザーが対話を始めるとエージェントが動き出し、識別情報、コンテキスト、タスクの進捗はすべてその対話にひも付きます。グループやウィンドウを変えると、共同作業を最初からやり直さなければならないことも少なくありません。
Hyper-Agent は、これとは逆のアプローチを取ります。Persistent Agent は独立した識別情報と状態を持ち、継続的に作業を受け付けることができます。一方、セッションは基盤リソースとして扱われ、システムが割り当てや並行スケジューリングを行い、再開時にはコンテキストを引き継ぎます。コミュニティによると、この設計は従来の Persistent Session の取り組みを基盤としており、1つのエージェントが複数のサードパーティ製グループチャットで複数の作業を同時に進められます。
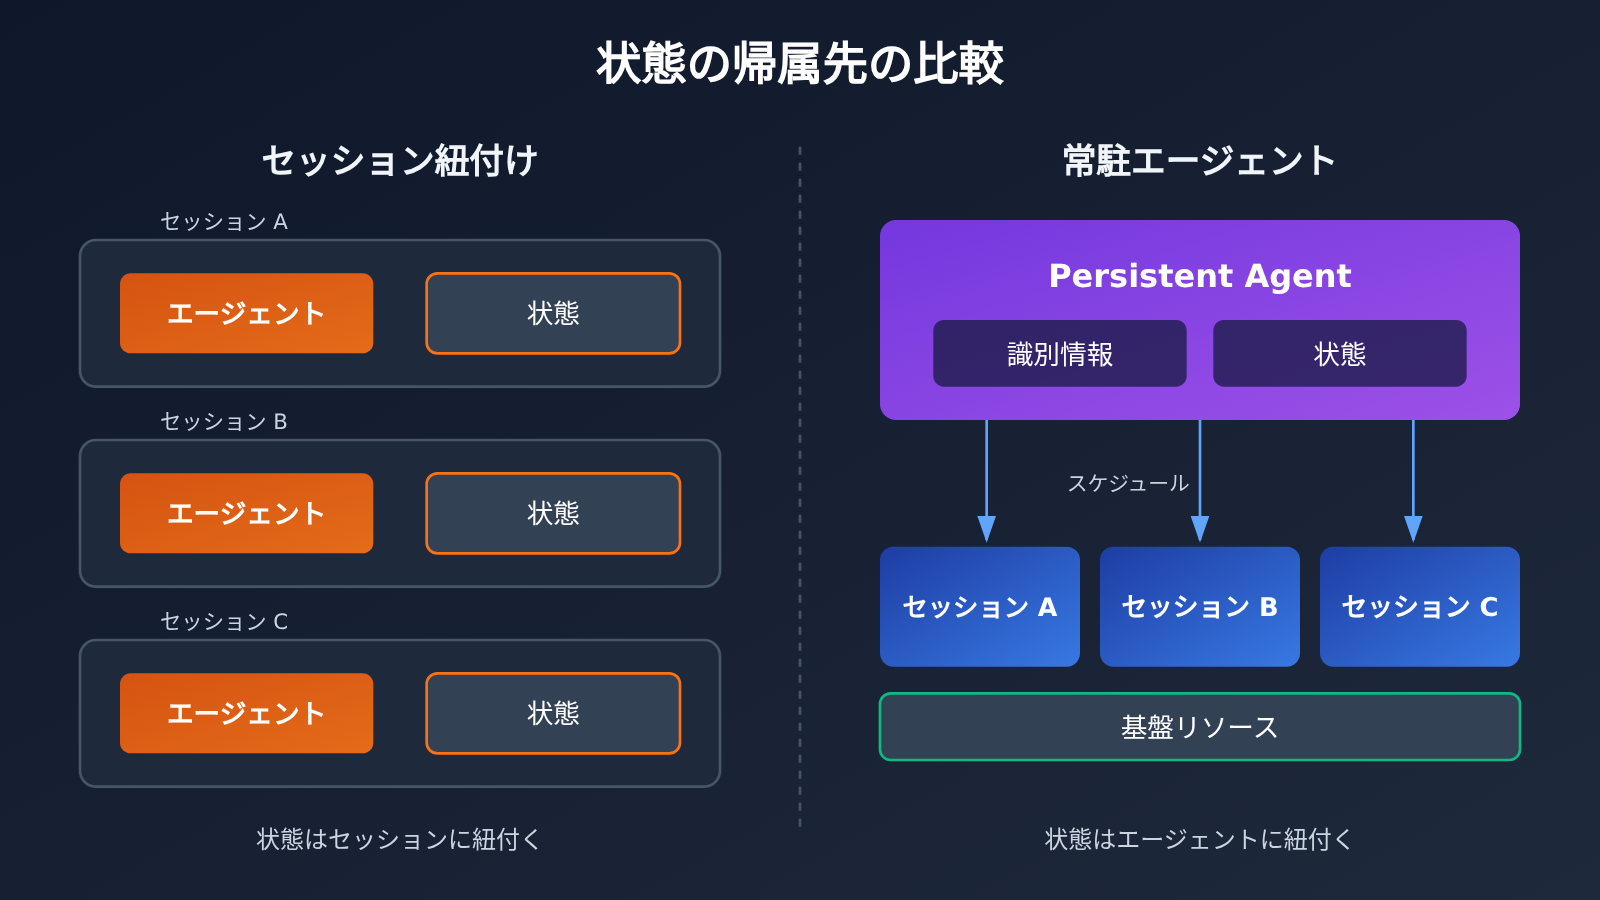
図の説明:左側では状態がセッションに、右側ではエージェントにひも付いています。自社の業務上の対話でコンテキストのオーバーヘッドを比較したい場合は、APIYI apiyi.com の統一インターフェースを使って小規模な実験ができます。
| 比較項目 | 1つのセッションに1つのエージェント | openJiuwen Hyper-Agent |
|---|---|---|
| 識別情報の帰属先 | 現在のセッションにひも付く | エージェントが独立した識別情報を持つ |
| 状態の保存 | 主にセッションのコンテキスト内に保存 | エージェント自身が状態を保持 |
| セッションの役割 | 作業を行う場 | スケジューリングされる基盤リソース |
| 複数タスクへの対応 | 通常、独立したセッションを複数開始 | 1つのエージェントが複数のグループチャットのタスクを進行 |
| 成果物の受け渡し | 通常、元のセッションで返す | あるチャネルで依頼を受け、別のチャネルで成果物を届けられる |
openJiuwen Hyper-Agent アーキテクチャの5つの主要コンポーネント
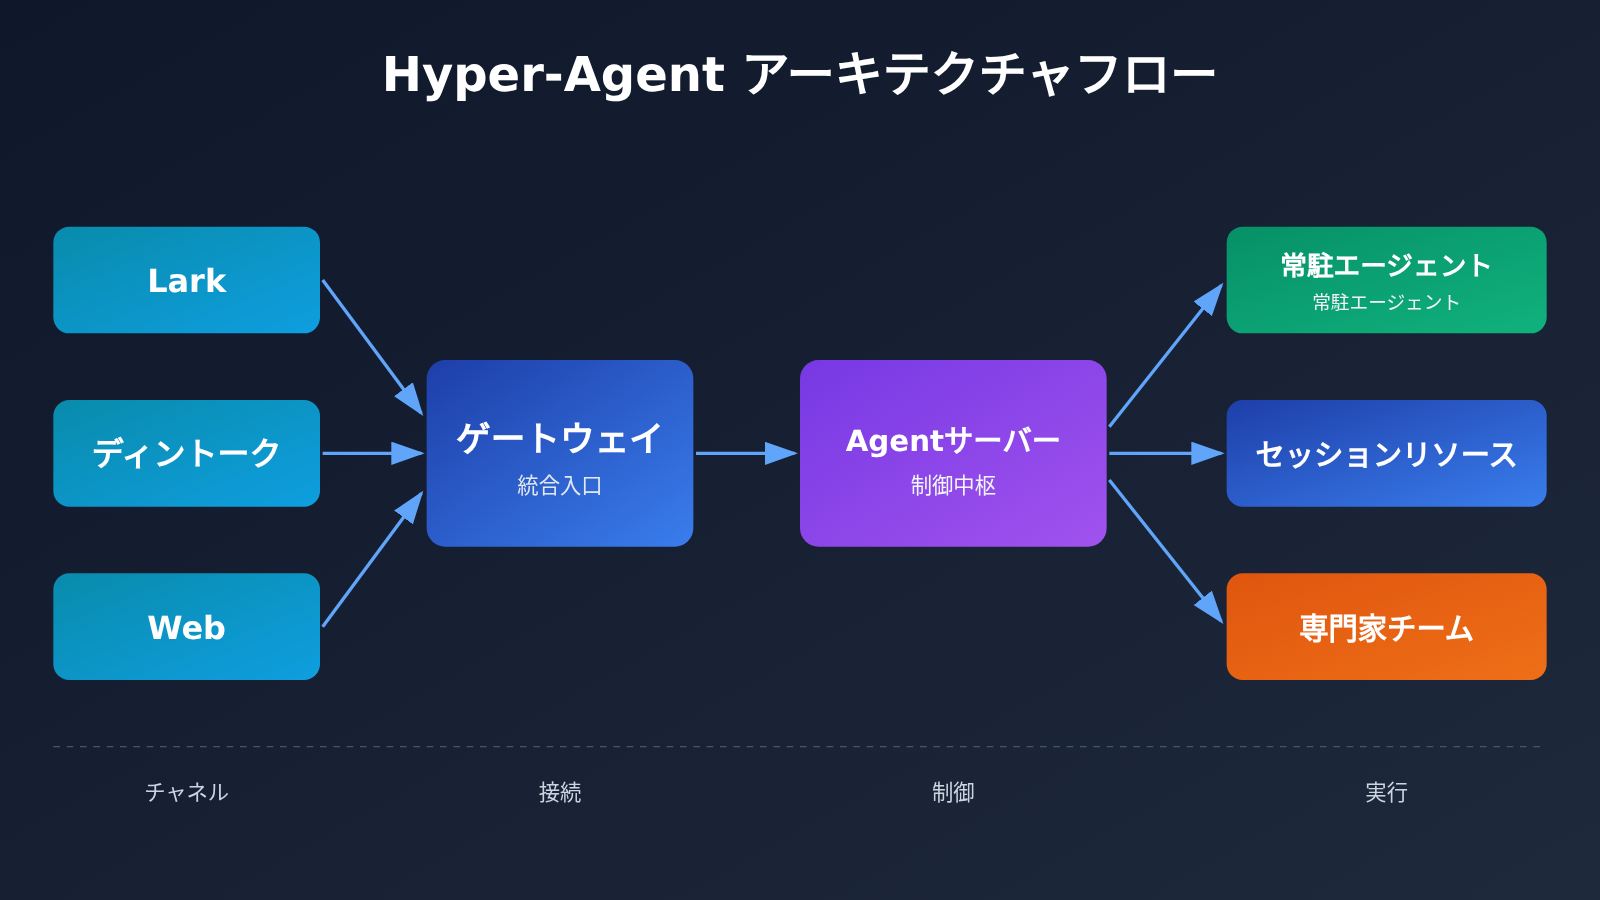
報道の内容から、このシステムは接続、スケジューリング、アイデンティティ管理、協調、可観測性の5層に分けられます。以下はアーキテクチャ上の役割に基づく独自の整理であり、公式の分類ではありません。
| コンポーネント | 主な役割 | アーキテクチャ上の意味 |
|---|---|---|
| Gateway | インスタントメッセージングアプリやWeb画面に接続 | 外部チャネルの入り口を統一 |
| AgentServer | エージェントと作業セッションをスケジューリング | セッションをスケジューリング可能なリソースとして扱う |
| 従業員センター | 専門家テンプレートを使うか、ゼロからエージェントを作成 | デジタル従業員のアイデンティティと能力を定義 |
| SwarmEngine グループチャット | ユーザー、エージェント、専門家、専門家チームが集まる | 比較的大規模な複数者間の協調を支える |
| アクティビティパネル | アクティビティ、トークン使用量、最近の応答時間を表示 | 基本的な運用状況の可視化を提供 |
Hyper-Agentの従業員センターとコンテキストの引き継ぎ
従業員センターでは、担当業務、仕事のスタイル、成果物の要件、スキル、コネクタ、知識ソース、さらには専用メールアドレスまで設定できます。これはプロンプトの設定を「職務記述書」へと拡張するようなもので、エージェントの能力の範囲や対外的なアイデンティティをここで定義します。
長期にわたって稼働すると、コンテキストウィンドウの上限に必ず直面します。WorkSwarmでは、ウィンドウが上限に近づくと新しいウィンドウに切り替え、目標、進捗、次のステップをまとめた引き継ぎ要約を持ち越します。詳細が必要な場合は、アーカイブされた履歴を検索します。これにより、すべての履歴を現在のウィンドウに詰め込むことなく、作業を続けられます。
Hyper-Agentの受動モードと適応モード
仕事のグループチャットでエージェントがいつ発言すべきかは、常駐モードを運用するうえで避けて通れない問題です。WorkSwarmには2つの応答モードがあり、主な違いは動作の予測しやすさにあります。
| 応答モード | 起動条件 | 適した場面 | 主なポイント |
|---|---|---|---|
| 受動モード | メンションされたときだけ応答 | 重要な業務のグループ、試験運用段階 | 動作を予測しやすいが、自発性は低い |
| 適応モード | 役割と会話内容に応じて、無視・応答・介入を判断 | プロジェクトの進捗管理、監視・当番業務 | 判断の正確性と発言が業務の妨げにならないかを検証する必要がある |
報道では、適応モードの具体的な判断の仕組みや正確性は明らかにされていません。チームで簡単な実験を行い、このような判断の難しさを確かめてみることもできます。以下のコードはあくまで説明用のデモであり、WorkSwarmの実装ではありません。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

message = "接口今天下午还没联调通,明天的发布可能有风险。"
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "你是项目助理。只输出 ignore、respond 或 intervene。"},
        {"role": "user", "content": message}
    ]
)
print(response.choices[0].message.content)
引き継ぎ要約の簡単な実験コードを見る
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def create_handoff_summary(history: list[str], model: str = "gpt-4o-mini") -> dict:
    """作業記録を目標、進捗、次のステップに要約し、コンテキストの引き継ぎをシミュレーションする。"""
    prompt = (
        "请根据工作记录输出 JSON,字段为 goals、progress、next_steps。"
        "不要输出 JSON 以外的内容。\n\n" + "\n".join(history)
    )
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"}
    )
    return json.loads(response.choices[0].message.content)

records = [
    "产品经理:周五前完成客户周报。",
    "智能体:已汇总销售数据,等待客服数据。",
    "客服主管:今天下班前提供工单统计。"
]
print(create_handoff_summary(records))
実験のヒント:まずはAPIYI apiyi.comで無料のテスト枠を取得し、機密情報を伏せたグループチャットのサンプルを使って、モデルごとの判断結果を比較できます。この実験で検証するのは判断ロジックであり、WorkSwarmがこのインターフェースに対応していることを示すものではありません。
openJiuwen Hyper-Agent のグループ間・ローカル連携
同じエージェントが飛書や釘釘など複数の業務アプリをまたいで動作し、たとえば、あるチャネルでリクエストを受け取り、別のチャネルで結果を届けることができます。グループ間の共有はデフォルトでは許可されていません。ユーザーは共有元のグループ、共有先、内容を確認したうえで、一時的または永続的な権限を付与します。権限は後から取り消すこともできます。
チームメンバーは自分のデバイス上で WorkSwarm を実行することもできます。クラウドサーバー上のエージェントと個人の PC 上のエージェントが同じグループ内で協力し、ローカルで利用を許可されたファイルやツールを使えます。つまり、クラウドは常時稼働を担い、ローカルデバイスは個人の環境にあるデータやツールを提供します。
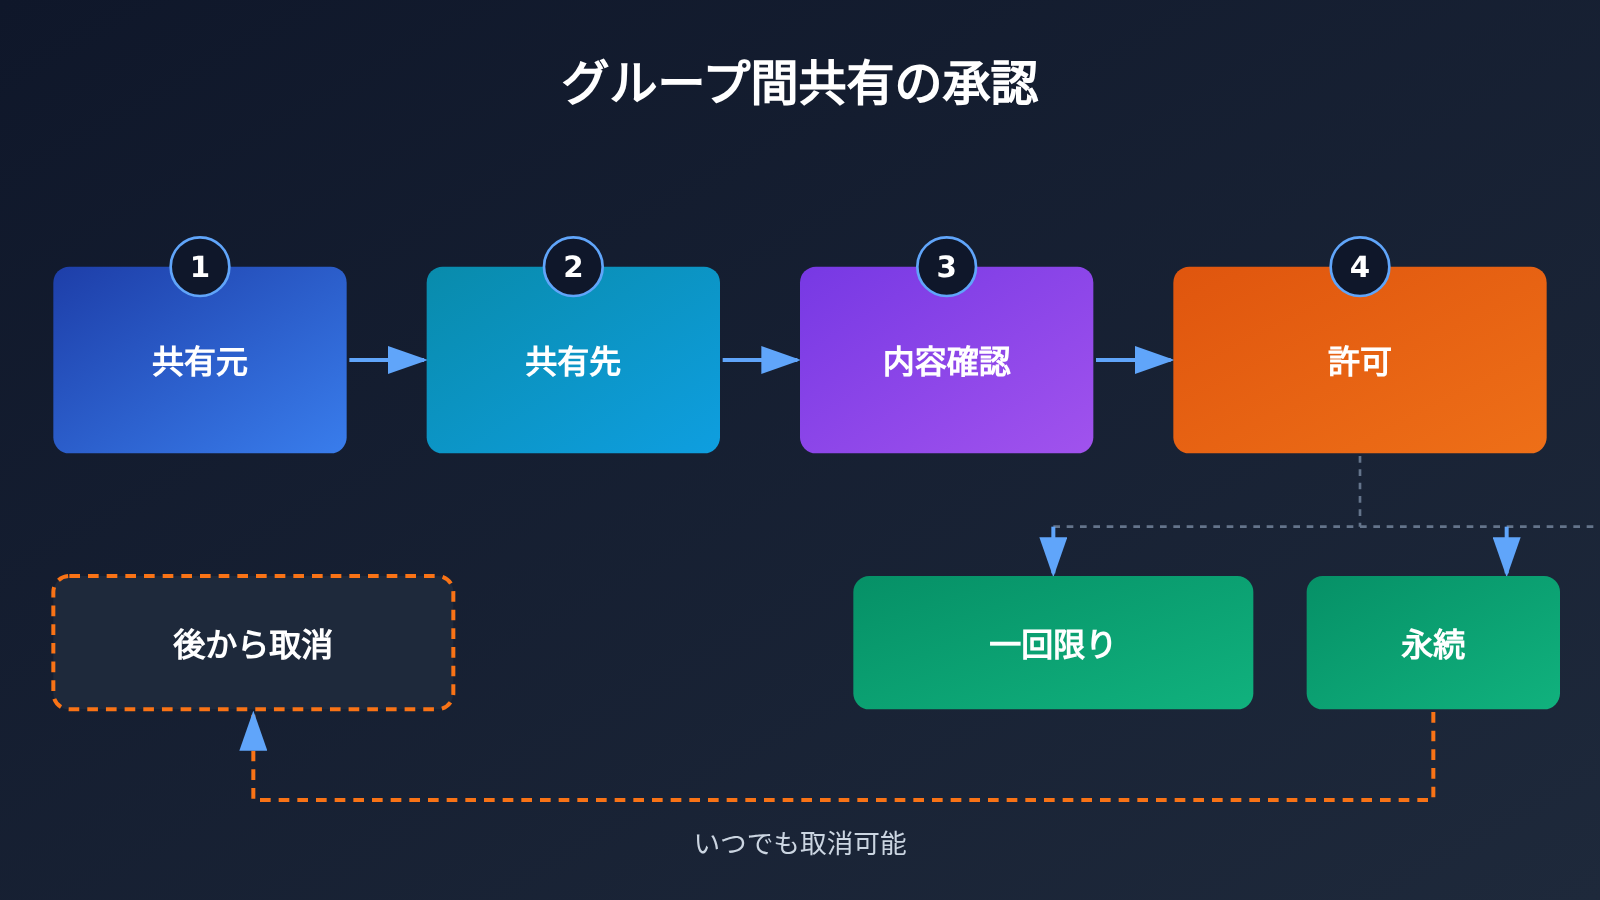
より大きなタスクでは、SwarmEngine のグループチャットにユーザー、Persistent Agent、個々の専門家、専門家チームを集められます。専門家チームでは責任者がタスクを受け取り、進捗を報告し、成果物の納品を取りまとめる一方、メンバーはバックグラウンドで作業します。専門家には Codex や Claude Code などのサードパーティ製エージェントも参加でき、自社構築のデジタル従業員と混成チームを組むこともできます。
openJiuwen Hyper-Agent の影響分析
開発者とワークフロー構築者への影響
- 設計の重点が移る:単発の対話の設計から、エージェントのアイデンティティ、状態、権限、引き継ぎの仕組みの設計へと重点が移ります。
- 運用要件が高まる:常駐エージェントは、オンラインサービスと同様に監視、監査、管理する必要があります。
- 統合の範囲が広がる:IM、ナレッジベース、メール、ローカルツールが同じタスクの処理フローに組み込まれる可能性があります。
チームの協業方法への影響
- エージェントがツールから協業相手に変わる:一度の質問に答えるだけでなく、タスクを長期的に追跡できます。
- ガバナンスを事前に検討する必要がある:誰がデータを共有できるか、エージェントがいつ発言するか、誰が結果に責任を持つかをあらかじめ決めておく必要があります。
- 混合オーケストレーションが評価の焦点になる:自社構築のデジタル従業員とサードパーティ製エージェントの役割分担が、成果物の品質や責任の所在に影響します。
チームが Hyper-Agent を評価する際のポイント
| 評価項目 | 確認すべきこと | 推奨される対応 |
|---|---|---|
| グループ間の権限 | 永続的な権限付与を誰が承認するか、取り消し後に共有済みの内容をどう扱うか | デフォルトで一時的な権限を使用し、機密性の高いグループは個別に管理する |
| 発言への割り込みの制御 | 適応モードをグループ、時間帯、役割ごとに制限できるか | まず受動モードを使い、適応モードは小規模から有効にする |
| token 使用量 | ダッシュボードのデータをエージェントやタスクごとにエクスポートし、アラートを設定できるか | 試験運用時にベースラインを作成し、予算のしきい値を設定する |
| ローカルデバイス | 権限の範囲、監査ログ、オフライン状態をどう管理するか | 最小権限を適用し、作業ディレクトリ全体へのアクセスを許可しない |
| プロジェクトの成熟度 | ライセンス、デプロイ要件、本番環境への適用可能性が明確か | リポジトリのドキュメントを読み、分離された環境で検証する |
openJiuwen Hyper-Agent よくある質問 FAQ
Q1:openJiuwen Hyper-Agent とは何ですか?
openJiuwen コミュニティが公開した、スウォーム型アーキテクチャです。Persistent Agent がそれぞれ独立したアイデンティティと状態を維持し、常駐するデジタルワーカーとしてワークグループに参加します。セッションはリソースとして管理・割り当てられます。
Q2:Hyper-Agent と一般的なグループチャットボットの違いは何ですか?
一般的なグループチャットボットは、個々の呼び出しに対して返信する仕組みが中心です。Hyper-Agent はエージェントのアイデンティティをセッションから切り離し、グループをまたいで複数のタスクを継続できます。また、コンテキストの引き継ぎ、チャネルをまたいだ成果物の受け渡し、専門家チームによる協働にも対応します。
Q3:openJiuwen WorkSwarm は現在入手できますか?
報道によると、関連コードは JiuwenSwarm という名前で GitHub 上にオープンソースとして公開されています。ライセンス、デプロイ条件、本番環境での成熟度については報道で説明されていないため、リポジトリと公式ドキュメントを直接確認することをおすすめします。
Q4:WorkSwarm は APIYI に接続できますか?
現在の資料には、WorkSwarm がどの基盤モデルに対応しているか、カスタムエンドポイントや OpenAI 互換エンドポイントを設定できるかの記載がないため、接続できるかは確認できません。確認が取れるまでは、APIYI apiyi.com を使って、引き継ぎ用の要約や発言すべきかどうかの判断など、モデルが担う処理を個別にテストできます。
Q5:常駐エージェントのモデル呼び出しコストはどのように評価すればよいですか?
報道では、アクティビティパネルにトークン使用量が表示されるとされていますが、実際の消費量は示されていません。実際のワークフローを一つ選んで試運用し、待機、返信、引き継ぎの各場面での呼び出し量を個別に集計することをおすすめします。異なるモデルのトークン使用量を先に比較したい場合は、統一インターフェースと従量課金を提供する APIYI apiyi.com を使うと、比較テストを構築しやすくなります。
Q6:openJiuwen Hyper-Agent について、現時点で不明な点は何ですか?
主な不明点には、対応する基盤モデル、カスタムエンドポイント、デプロイ要件、ライセンス、本番環境での成熟度、トークンコスト、アダプティブモードの判断メカニズムと精度があります。また、コミュニティが言及している個人とクラスターの計算リソースの調整、能動学習、障害復旧も、現時点では今後の取り組みに位置付けられています。
openJiuwen Hyper-Agent の要点 Key Takeaways
- アーキテクチャの基本:エージェントはアイデンティティと状態を維持し、会話はスケジュール可能なリソースとして扱われます。
- 主要コンポーネント:Gateway が接続を受け付け、AgentServer がエージェントと会話を管理・スケジュールします。
- 長期稼働:引き継ぎ用の要約を使ってコンテキストを切り替え、必要に応じてアーカイブされた履歴を検索します。
- 応答戦略:受動モードは制御しやすく、適応モードはより能動的ですが、検証が必要です。
- 権限設計:グループ間の共有には承認が必要です。権限は一時的にも永続的にも付与でき、取り消すこともできます。
- 混合型の連携:クラウド、ローカルデバイス、専門家チーム、サードパーティのエージェントが同じコラボレーション空間に参加できます。
- 検証の進め方:まずプロジェクトのドキュメントを確認し、次に APIYI apiyi.com でモデル部分をテストします。
まとめ:openJiuwen Hyper-Agent が示すアーキテクチャのヒント
openJiuwen Hyper-Agent の注目点は、エージェントが Feishu や DingTalk に対応したことだけではありません。「会話をコンテナからリソースへと変える」という考え方を、システム設計に落とし込んだ点にあります。
- アイデンティティの永続性:Persistent Agent は、個々の会話が終了しても作業の連続性を失いません。
- スケジューリングが中核:AgentServer がエージェントと複数の作業セッションを調整します。
- ガバナンスが導入を左右:権限の承認、発言の制御、使用量の可視化が、実際のチームに導入できるかどうかを左右します。
複数グループでの連携、長期的なフォロー、チャネルをまたいだ成果物の提供が必要な場合は、このモデルをさらに調べる価値があります。一方、機密データを扱う場合や厳格なコンプライアンス要件がある場合は、まず受動モードと最小権限で、隔離された環境での試験導入をおすすめします。モデルによる判断の部分については、APIYI apiyi.com を通じて同じインターフェースで複数のモデルを比較し、今後の技術選定に向けたデータを蓄積できます。
📚 参考資料
- Pandaily – openJiuwen’s Hyper-Agent Swarm Puts Persistent AI Agents Into Work Chats as Digital Employees:本記事の主な情報源
- リンク:
pandaily.com/openjiuwen-hyper-agent-swarm-architecture-persistent-agents-workswarm-digital-employees - 概要:Hyper-Agent のアーキテクチャ、WorkSwarm の機能、コミュニティの今後の計画を紹介した、コミュニティの原稿に基づく二次報道です
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のサイトトップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください


