
Note de l’auteur : Gemini 4 Carbon et GPT-6 Astra se répartissent les tâches, l’un ne remplace pas l’autre. Cet article explique comment choisir selon quatre critères : benchmarks, protocole, prix et cas d’usage.
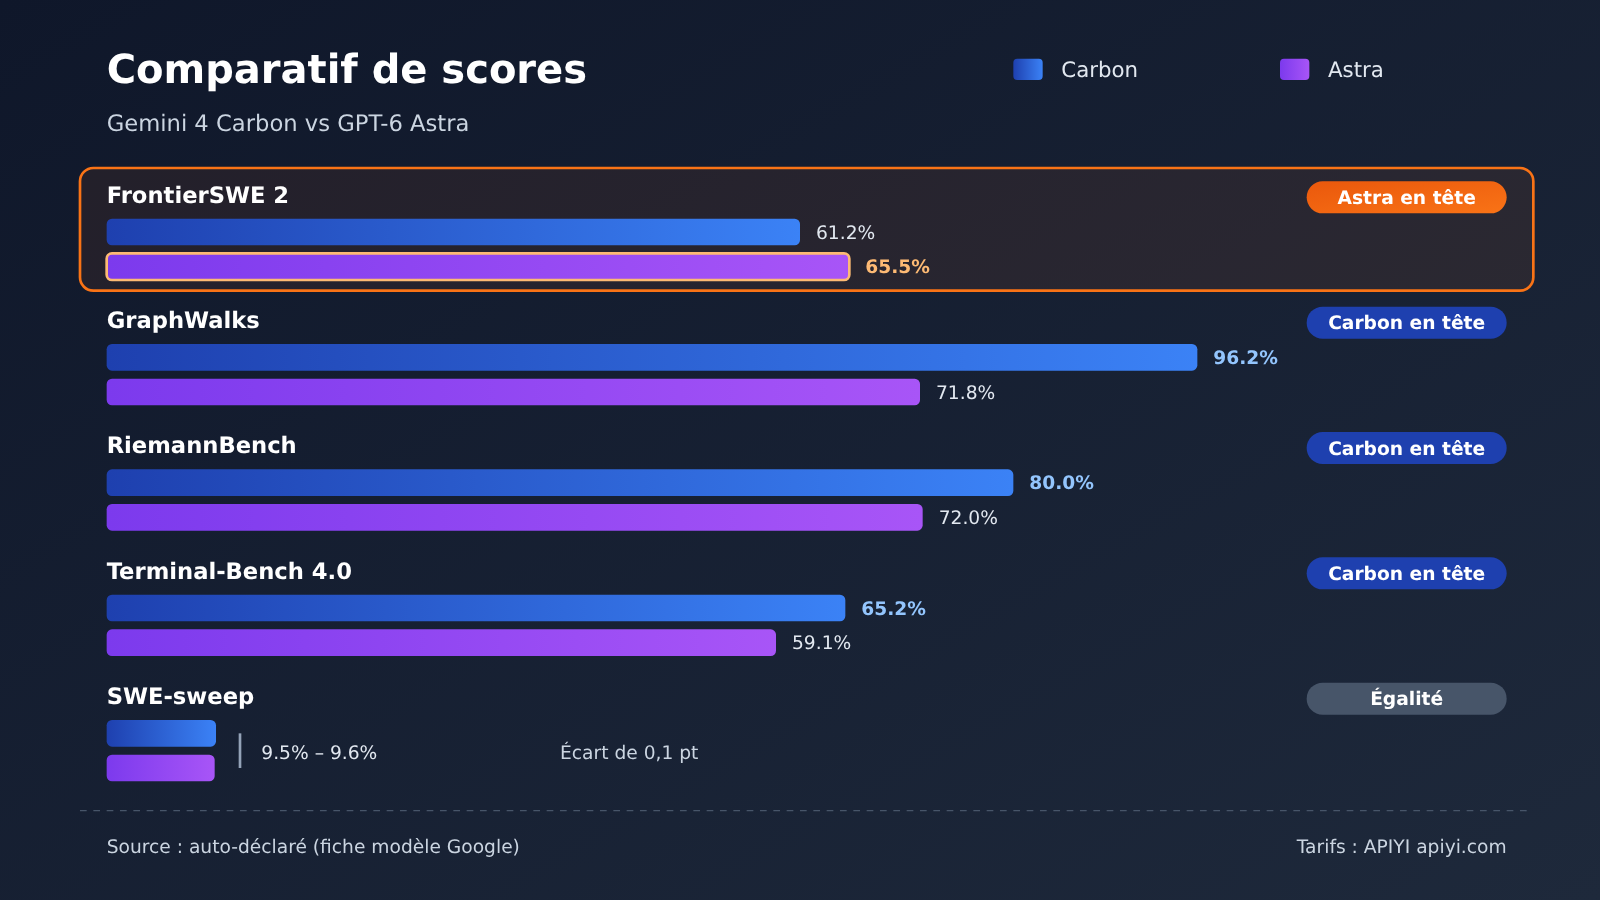
Depuis l’ouverture de Gemini 4 Carbon aux développeurs payants le 10 novembre 2026, beaucoup d’équipes se demandent lequel des deux modèles phares choisir : lui ou GPT-6 Astra. Pour commencer par la conclusion : il ne s’agit pas de savoir lequel remplace l’autre. Sur FrontierSWE 2, le benchmark d’ingénierie sur dépôts publics, GPT-6 Astra devance Carbon avec 65,5 % contre 61,2 %. Sur GraphWalks (contexte long), RiemannBench (mathématiques), le benchmark de sciences en terminal et la plupart des évaluations de travail de connaissance, Gemini 4 Carbon fait mieux. Sur SWE-sweep, 9,6 % contre 9,5 %, on peut parler d’égalité.
Ce n’est pas un article du genre « chacun a ses qualités ». Les prix affichés des deux modèles diffèrent d’un facteur 5 environ, et leurs protocoles ne sont pas les mêmes. Répartir selon les tâches coûte donc moins cher que choisir d’après le classement général. Tous les scores cités viennent des chiffres publiés par les éditeurs ou de leur documentation, et non d’une revérification par un tiers.
Ce que vous y gagnez : vous saurez quelles tâches confier à Carbon, lesquelles à Astra, et quels pièges guettent de chaque côté sur la fenêtre de contexte, la limite de sortie et les paliers de facturation.
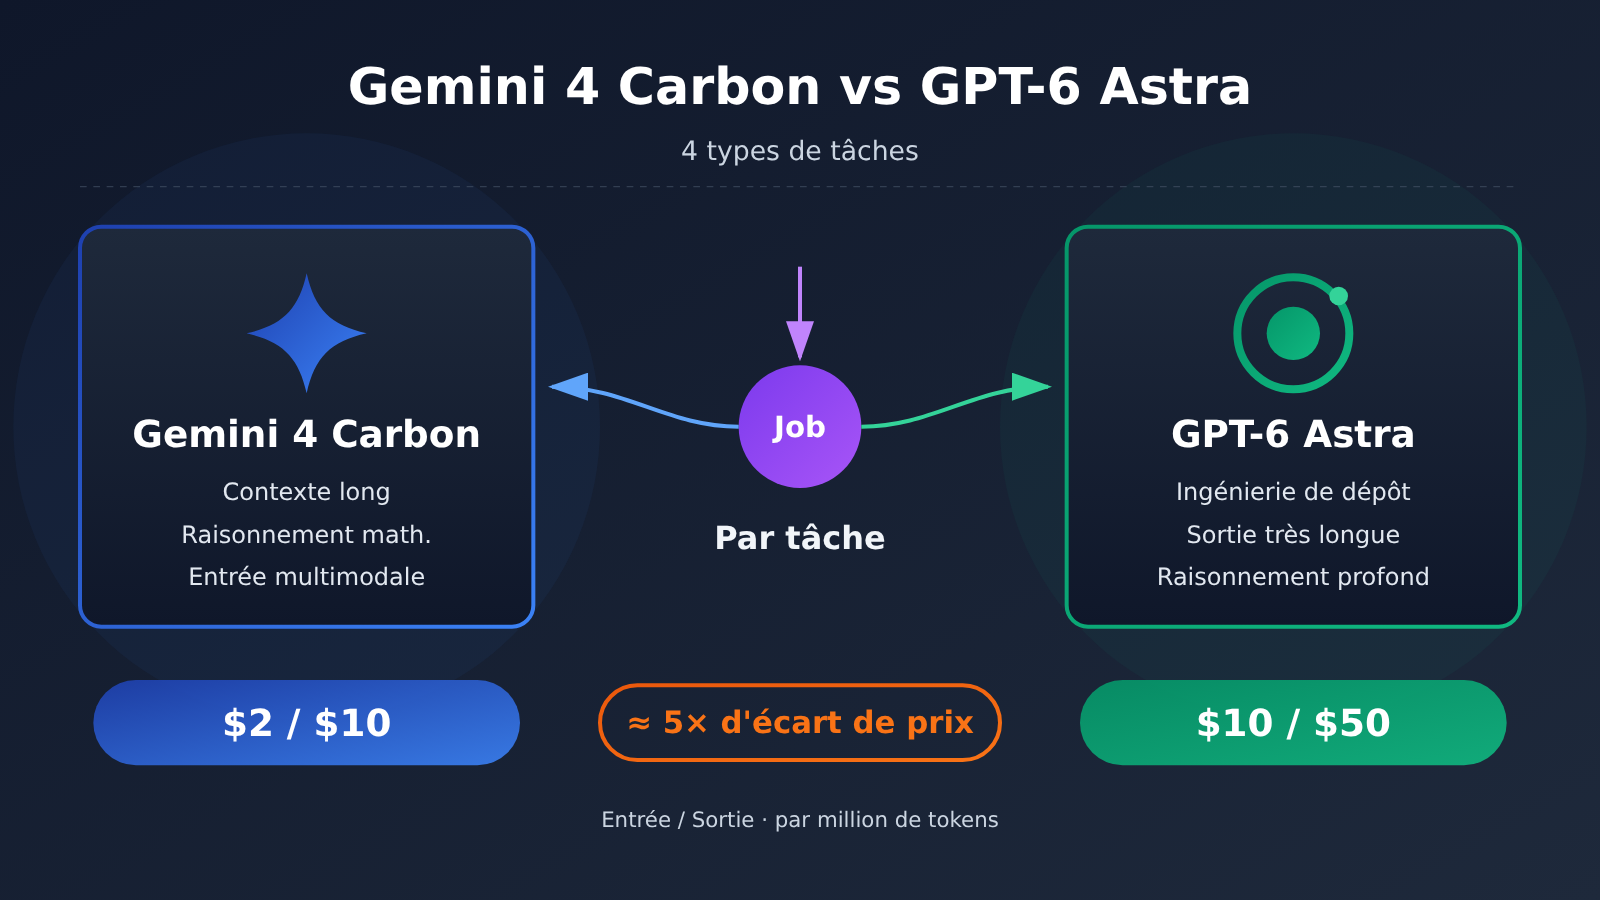
Gemini 4 Carbon vs GPT-6 Astra : les différences clés
Les deux modèles se présentent comme « le modèle pour les tâches les plus difficiles », mais leurs interfaces n’ont pas grand-chose en commun. Astra appartient à la série GPT-6 d’OpenAI : la documentation officielle recommande de passer en priorité par l’API Responses, et l’intensité de raisonnement se règle avec reasoning.effort, avec des niveaux qui montent jusqu’à max. Carbon, lui, repose sur Gemini 4 Argon. Il s’utilise via l’interface native de Gemini ou via l’interface de chat compatible OpenAI, et l’intensité de raisonnement ne se règle que sur trois niveaux, avec thinking_level.
| Critère | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|
| ID du modèle | gemini-4-carbon |
gpt-6-astra |
| Contexte | Fenêtre partagée de 1M (entrée, réflexion et sortie confondues) | 1 050 000 tokens |
| Limite de sortie | 65 536 par défaut en mode synchrone ; au-delà, il faut background=True avec l’API Interactions |
Sortie maximale de 128 000 |
| Niveaux de raisonnement | thinking_level : low / medium / high, medium par défaut |
reasoning.effort : low / medium / high / xhigh / max |
| Modalités d’entrée | Texte, image, audio, vidéo | Texte, image |
| Modalités de sortie | Texte | Texte |
| Date limite des connaissances | mars 2026 (certains domaines peuvent être plus anciens) | 30 avril 2026 |
| Protocole recommandé | Gemini natif ou Chat compatible OpenAI | API Responses en priorité |
Comment comprendre la fenêtre partagée de 1M de Gemini 4 Carbon
Le 1M de Carbon ne veut pas dire « 1M en entrée, plus une sortie en supplément ». L’entrée, les tokens de réflexion et la réponse finale puisent dans la même fenêtre. Les modèles de la génération précédente plafonnaient « réflexion + réponse » à 64K ; Carbon et Argon sont passés à ce mécanisme partagé. Résultat : si vous bourrez la fenêtre de documents longs, pensez à garder de la marge pour la réflexion, sinon la réponse risque d’être tronquée.
Chez Astra, les 1,05M de contexte et le plafond de 128K en sortie sont indépendants, ce qui rend les sorties longues plus faciles à planifier. En contrepartie, il y a un piège côté facturation : dès qu’une requête dépasse 272K tokens en entrée, toute la requête est facturée au tarif supérieur. On fera le calcul plus loin.
Calendrier de sortie de Gemini 4 Carbon et GPT-6 Astra
Carbon a été annoncé pour la première fois le 28 octobre 2026. Il était d’abord réservé aux équipes de défense en cybersécurité vérifiées, puis l’accès s’est élargi progressivement via le Fairwind Program. Le 10 novembre, Google a annoncé son ouverture aux développeurs payants, aux entreprises, aux scientifiques et aux consommateurs, et le changelog de l’API Gemini mentionne le même jour le passage de gemini-4-carbon en disponibilité générale (GA). Pour les utilisateurs gratuits ou des offres grand public d’entrée de gamme, Google n’a pas donné de date cette fois-ci.
Comment lire les scores de Gemini 4 Carbon face à GPT-6 Astra
Le tableau ci-dessous provient de la fiche modèle de Gemini 4 Carbon publiée par Google. Les résultats datent d’octobre 2026 et sont auto-déclarés par l’éditeur. La colonne Astra reprend les chiffres que Google cite dans sa propre fiche : il ne s’agit ni d’un test interne d’OpenAI, ni d’une vérification par un tiers. Les trois benchmarks de cybersécurité mesurent les performances via la voie Fairwind, qui ne reflètent pas les capacités par défaut de l’API payante. Je les ai donc exclus de la comparaison.
| Benchmark (auto-déclaré, au 2026-10) | Gemini 4 Carbon | GPT-6 Astra | Meilleur score | Lecture |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 57 | Carbon | Valeur citée dans la fiche modèle de Google |
| FrontierSWE 2 | 61,2 % | 65,5 % | Astra | Astra en tête sur les tâches d’ingénierie sur dépôts publics |
| SWE-sweep | 9,6 % | 9,5 % | Quasi-égalité | Écart dans la marge d’erreur |
| Terminal-Bench 4.0 (AA) | 65,2 % | 59,1 % | Carbon | Tâches multi-étapes dans le terminal |
| Terminal-Bench-Science 0.1 (AA) | 64,8 % | 63,3 % | Carbon | Légère avance |
| GraphWalks 256k-1M BFS (F1) | 96,2 % | 71,8 % | Carbon | Plus gros écart, sur le contexte long |
| RiemannBench | 80,0 % | 72,0 % | Carbon | Raisonnement mathématique et scientifique |
| Agents’ Last Exam v1.1 | 77,4 % | 73,1 % | Carbon | Évaluation globale des agents |
| Vals Index v2.2 | 70,4 % | 65,0 % | Carbon | Travail de connaissance |
| AutomationBench (Zapier) | 53,9 % | 41,4 % | Carbon | Automatisation de workflows |
| OSWorld-2.1 (sous-ensemble hors ligne) | 81,5 % | 80,9 % | Claude Opus 5.5 (87,2 %) | Aucun des deux n’est premier |
Où Gemini 4 Carbon fait la différence
Le point fort le plus marquant de Carbon, c’est la récupération d’information en contexte long : sur GraphWalks, dans la tranche de 256K à 1M de tokens, son F1 atteint 96,2 %, contre 71,8 % pour Astra, soit plus de 20 points d’écart. Carbon prend aussi une avance nette sur RiemannBench (mathématiques), Agents’ Last Exam et AutomationBench. En revanche, sur le test de science en terminal, il ne devance son concurrent que de 1,5 point : c’est une avance modeste, qu’il vaut mieux ne pas surinterpréter.
Pour l’AA Index, le 59 face au 57 demande une précision sur la méthode de comptage. Lors de la capture du 11 novembre, la page d’Artificial Analysis affichait un score de 60, mais le graphique de cette même page indiquait toujours « pas d’API publique », ce qui contredit le fait que l’API était ouverte depuis le 10 novembre. Dans cet article, nous retenons donc uniquement le 59 figurant dans la fiche du modèle, valable à la date d’octobre 2026.
Où GPT-6 Astra fait la différence
Sur FrontierSWE 2, Astra décroche 65,5 %, le meilleur score du tableau. Claude Opus 5.5 arrive deuxième avec 62,3 % et Carbon troisième avec 61,2 %. Si votre travail consiste surtout à modifier du code dans de vrais dépôts open source, cet indicateur est plus parlant que le classement général. Sur SWE-sweep, les deux modèles sont au coude-à-coude, avec 9,6 % contre 9,5 %, et dépassent largement Argon (4,3 %) et Opus 5.5 (3,6 %). En revanche, l’écart de 0,1 point entre eux ne permet pas de désigner un vainqueur.
Gemini 4 Carbon vs GPT-6 Astra : prix et facturation
C’est sur le prix que l’écart entre les deux modèles est le plus grand. D’après l’interface de tarification d’APIYI (apiyi.com) au 2026-11-11, le palier de base d’Astra est à 10 $ en entrée et 50 $ en sortie par million de tokens, tandis que Carbon, en palier promotionnel, est à 2 $ en entrée et 10 $ en sortie : environ 5 fois moins cher. Tous les tarifs ci-dessous sont les prix affichés par défaut, hors bonus de recharge et remises de groupe.
| Modèle (tarif APIYI au 2026-11-11) | Entrée | Sortie | Lecture du cache | Écriture du cache | Groupes | Endpoints |
|---|---|---|---|---|---|---|
gemini-4-carbon |
2 | 10 | 0.10 | Pas de multiplicateur dédié | default, svip | /v1beta natif, /v1/chat/completions |
gpt-6-astra (≤272K en entrée) |
10 | 50 | 1 | 12.5 | CodexResponses, CodexReverse, default, svip | OpenAI, /v1/responses de préférence |
gpt-6-astra (272 001 à 1 050 000 en entrée) |
20 | 75 | 2 | 25 | Idem | Idem |
Toutes les unités sont en dollars américains par million de tokens. Le multiplicateur de groupe est de 1 pour default, svip et CodexResponses, et de 0,5 pour CodexReverse. Les recharges APIYI sont converties à un taux fixe de 1:7, et peuvent se cumuler avec les bonus de recharge et les remises de groupe ; la facturation réelle est celle indiquée dans la console. Les modèles et les prix sont ceux de la liste des modèles de la plateforme : l’instantané du tableau récapitulatif de docs.apiyi.com/models date d’avant le lancement public de Carbon, donc si vous n’y voyez pas encore cette ligne, fiez-vous à la console et à l’interface de tarification. Carbon est bien déjà disponible dans la liste des modèles.
Prix officiels et hausse tarifaire du 1er décembre
Les prix officiels sont à considérer séparément de ce qui précède. Chez Google Cloud et AI Studio, le tarif de Carbon jusqu’au 30/11/2026 inclus est, en global, de 2 en entrée, 0,10 pour le cache et 10 en sortie ; pour les régions hors global, il passe à 2,20, 0,11 et 11. À partir du 01/12/2026, le tarif officiel passe à 4 en entrée, 0,20 pour le cache et 20 en sortie (global), et la version Cyber Permissive n’a, dès le départ, jamais bénéficié du tarif promotionnel. Quant à savoir si APIYI s’alignera sur cette hausse, tout dépend de la liste des modèles affichée le jour même.
| Référence officielle | Entrée | Sortie | Cache | Remarques |
|---|---|---|---|---|
| Gemini 4 Carbon, jusqu’au 30/11/2026 (global) | 2 | 10 | 0,10 (cache implicite, 95 % de remise) | Le prix de sortie inclut les jetons de raisonnement |
| Gemini 4 Carbon, à partir du 01/12/2026 (global) | 4 | 20 | 0,20 | Cyber Permissive au même tarif |
| GPT-6 Astra standard (≤ 272K) | 10 | 50 | Entrée en cache : 1 | Écriture en cache : 12,50 pour 30 minutes, 25 pour 12 heures |
| GPT-6 Astra au-delà de 272K en entrée | Entrée et cache ×2 | Sortie ×1,5 (soit 75) | — | S’applique à toute la requête ; la sortie n’est pas à 100 |
OpenAI propose aussi un mode Fast, annoncé officiellement comme allant jusqu’à environ 2 fois plus rapide, pour un prix lui aussi multiplié par 2.
Le calcul au tarif catalogue
Ce qui suit est un simple calcul basé sur les tarifs affichés, pas un test réel sur des tâches :
- Requête standard : 100K en entrée, 20K en sortie. Astra revient à 1,0 + 1,0 = 2,0 dollars ; Carbon à 0,2 + 0,2 = 0,4 dollar.
- Requête à long contexte : 400K en entrée, 20K en sortie. Astra dépasse le palier de 272K et coûte 8,0 + 1,5 = 9,5 dollars ; Carbon coûte 0,8 + 0,2 = 1,0 dollar.
Attention : le prix de sortie de Carbon inclut les tokens de réflexion. Google précise que Carbon dépense plus de tokens de réflexion qu’Argon, car il fait tourner plus longtemps ses boucles de vérification. L’écart réel sur la facture d’une tâche sera donc plus faible que l’écart entre les prix unitaires. Le plus sûr reste de lancer un lot de vos propres tâches sur chaque modèle, puis de regarder ce qui est réellement facturé.
Comment appeler Gemini 4 Carbon et GPT-6 Astra
Les deux modèles s’utilisent avec la même clé API et le même base_url https://api.apiyi.com/v1. La différence tient au choix du point de terminaison et au paramètre de raisonnement à transmettre. Voici la comparaison au niveau des paramètres ; il suffit de l’adapter à votre code SDK existant.
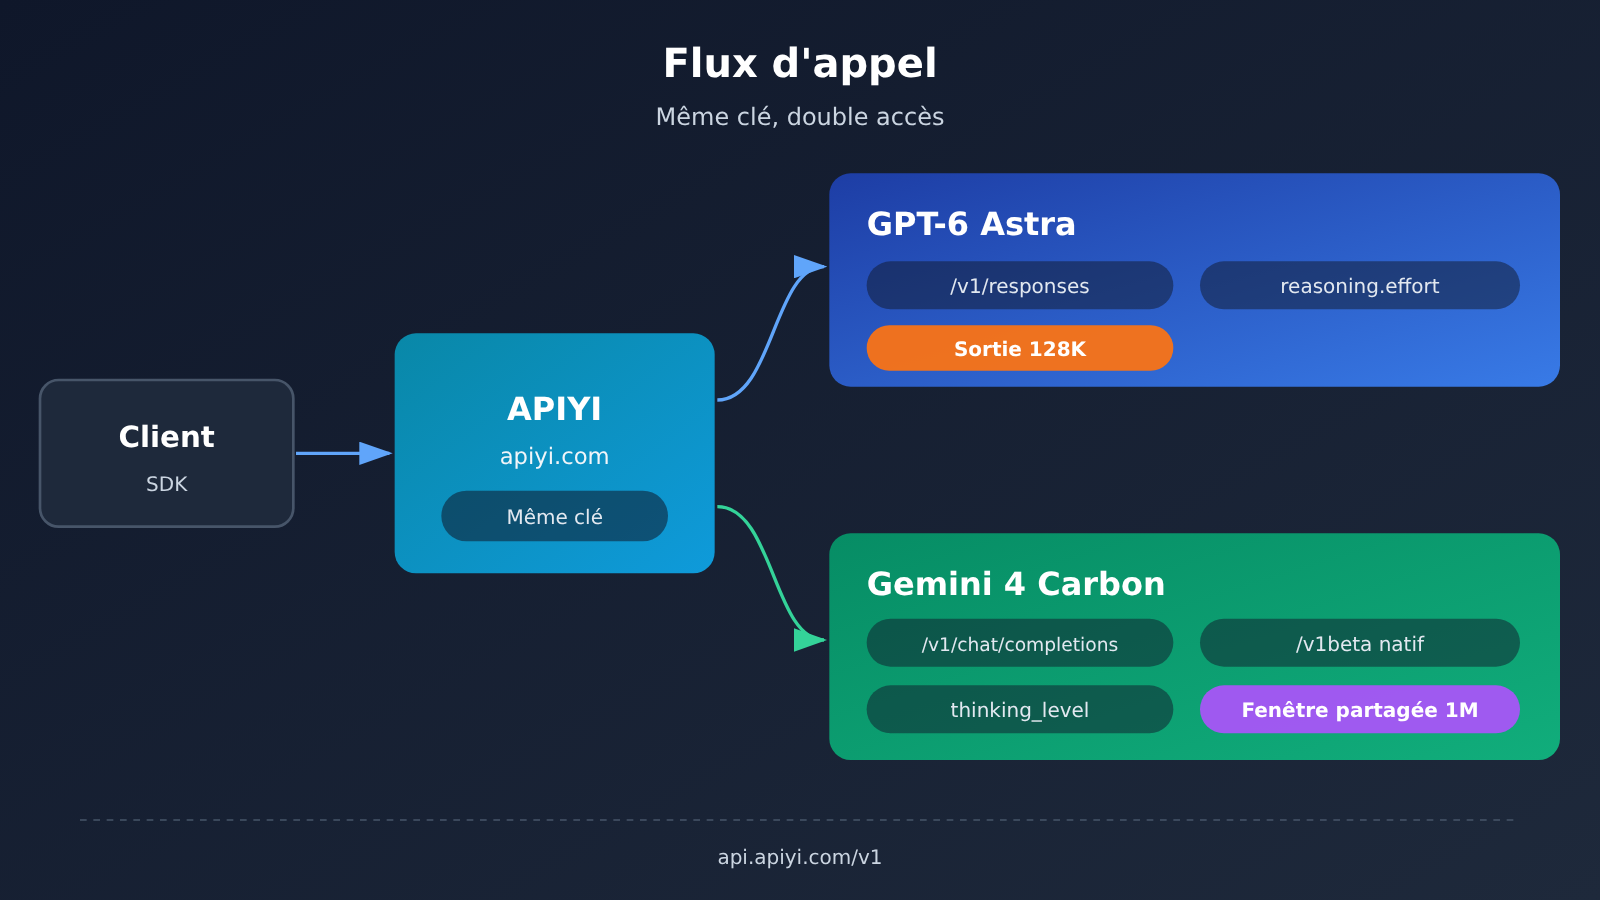
Points clés pour appeler GPT-6 Astra :
- Utilisez le SDK OpenAI, définissez
base_urlsurhttps://api.apiyi.com/v1et indiquezgpt-6-astracomme modèle. - Privilégiez
client.responses.create(...)et transmettez l’intensité de raisonnement viareasoning={"effort": "high"}. Les valeurs possibles sont low, medium, high, xhigh et max. - Gardez chaque entrée sous 272K tokens, sinon toute la requête bascule dans la tranche tarifaire supérieure.
Points clés pour appeler Gemini 4 Carbon :
- Mode compatible OpenAI : même
base_url, appel à/v1/chat/completions, avecgemini-4-carboncomme modèle. - Mode natif Gemini : passez par le point de terminaison
/v1betaet réglezthinking_levelsur low, medium ou high. Pour savoir comment les niveaux de réflexion sont mappés via l’interface compatible, reportez-vous à la documentation d’APIYI. - Pour migrer depuis
gemini-4-argon, il suffit de changer le nom du modèle.thinking_budgetest obsolète, et les valeurs personnalisées de temperature, top_p et top_k sont ignorées avec un avertissement. - Ne créez plus et ne transmettez plus de
cached_contentexplicite : le cache implicite est activé par défaut. Les problèmes difficiles peuvent prendre plusieurs minutes, donc réglez le délai d’expiration côté client entre 15 et 20 minutes.
🚀 Pour démarrer vite : les deux modèles figurent déjà dans la liste des modèles d’APIYI (apiyi.com), et une seule clé suffit pour appeler chacun d’eux. Je vous conseille de lancer le même lot de tâches avec Carbon en niveau medium et Astra en niveau medium, de comparer la qualité des résultats et la facturation réelle, puis de décider seulement ensuite s’il vaut la peine de monter d’un niveau.
Scénarios recommandés : quand choisir Gemini 4 Carbon, quand choisir GPT-6 Astra
Pour répartir le travail par type de tâche, on peut ranger les usages courants dans les catégories suivantes. Toutes les « justifications » du tableau proviennent des benchmarks auto-déclarés par les éditeurs ou des recommandations de leur documentation officielle.
| Type de tâche | Recommandation | Justification |
|---|---|---|
| Corriger des problèmes dans un vrai dépôt, modifier le code de projets publics | GPT-6 Astra | FrontierSWE 2 : 65,5 %, le meilleur score du tableau |
| Recherche et mise en relation d’informations dans des documents de plus de 256K | Gemini 4 Carbon | GraphWalks : 96,2 % contre 71,8 %, et pas de palier de hausse tarifaire à 272K |
| Mathématiques formelles, raisonnement scientifique, tâches scientifiques en terminal | Gemini 4 Carbon | Scores plus élevés sur RiemannBench et Terminal-Bench-Science |
| Automatisation de workflows, évaluations de travail intellectuel | Gemini 4 Carbon | Scores plus élevés sur AutomationBench et Vals Index |
| Besoin d’une très longue sortie en une seule fois (plus de 65K) | GPT-6 Astra | Limite de sortie de 128K, sans passer par le mode en arrière-plan |
| Audio et vidéo en entrée | Gemini 4 Carbon | Astra n’accepte que le texte et les images |
| Agents déjà construits sur l’API Responses | GPT-6 Astra | Compatibilité native avec le protocole, niveaux xhigh et max disponibles |
| Utilisation de l’ordinateur, tâches de bureau | Aucun des deux n’est le meilleur choix | Sur OSWorld-2.1, Claude Opus 5.5 atteint 87,2 % |
| Développement de fonctionnalités au quotidien, programmation interactive | Gemini 4 Argon | Recommandation officielle de Google : même prix unitaire, mais plus économe en tokens |
Les cas typiques où choisir GPT-6 Astra
Si votre équipe a déjà bâti ses agents sur l’API Responses, si vous avez besoin du niveau de raisonnement max pour creuser les problèmes difficiles à fond, ou si vous devez générer en une seule fois de longs fichiers approchant les 128K, le protocole et les spécifications d’Astra seront plus pratiques. Les correctifs d’ingénierie sur des dépôts publics sont aussi l’un de ses points forts. En contrepartie, le prix unitaire est environ 5 fois plus élevé, et au-delà de 272K en entrée, la majoration s’applique à toute la requête.
Les cas typiques où choisir Gemini 4 Carbon
Pour la recherche et la synthèse dans de longs documents ou de grandes bases de code, le raisonnement mathématique et scientifique, ou l’analyse multimodale avec audio et vidéo en entrée, Carbon prend l’avantage, tant sur les benchmarks que sur le prix. La recommandation de Google lui-même est claire : réservez Carbon aux tâches qui poussent les capacités à leur limite, et continuez à utiliser Argon pour la plupart des tâches quotidiennes de génie logiciel et de travail intellectuel. Dans l’aperçu de /swarm d’Antigravity, Google conseille aussi de confier à Carbon les rôles qui exigent le plus de raisonnement approfondi, comme l’architecture, la coordination et l’audit.
Gemini 4 Carbon vs GPT-6 Astra : nos recommandations
Si vous découpez le choix en trois questions, vous arriverez à trancher rapidement dans la plupart des cas :
- Quelle est votre pile de protocoles ? Si vous êtes déjà sur l’API Responses, privilégiez Astra ; si vous utilisez le SDK Gemini ou une interface Chat générique, privilégiez Carbon.
- Vos entrées dépassent-elles 272K en une seule requête ? Si oui, Astra facture toute la requête au tarif 20/75, et l’avantage de coût de Carbon se creuse encore.
- De quel type de tâche s’agit-il ? Pour la correction de code à l’échelle d’un dépôt, regardez FrontierSWE 2, qui penche du côté d’Astra ; pour le long contexte, la science et l’automatisation, regardez Carbon.
Deux limites à préciser. Pour les capacités spécialisées en cybersécurité, il faut passer par le Fairwind Program : remplacer le nom du modèle par gemini-4-carbon ne suffit pas pour obtenir Cyber Permissive, et le site officiel ne propose pas non plus de tarif promotionnel pour Cyber Permissive. Par ailleurs, le tarif promotionnel de 2 dollars de Carbon prend fin le 2026-11-30 : si vous budgétez au mois, pensez à intégrer la hausse de tarif de décembre.
💡 Notre conseil : la solution la plus fiable consiste à faire travailler les deux modèles ensemble plutôt qu’à choisir l’un ou l’autre. Avec APIYI (apiyi.com), vous accédez aux deux avec la même clé : vous routez les requêtes de correction de code vers Astra, et celles de documents longs et de raisonnement scientifique vers Carbon. Pour basculer, il suffit de changer le nom du modèle et le point de terminaison.
FAQ – Questions fréquentes
Q1 : Qu’est-ce que Gemini 4 Carbon, et quel est son lien avec Argon ?
Gemini 4 Carbon est le modèle phare lancé par Google à partir de Gemini 4 Argon. Son identifiant est `gemini-4-carbon`, et Google le présente comme son modèle le plus puissant à ce jour. Les deux modèles partagent le même thinking_level, la même fenêtre partagée de 1M et le même tarif d’entrée de base. En revanche, Carbon consomme davantage de tokens de réflexion, ce qui le rend plus adapté aux tâches multi-étapes les plus difficiles.
Q2 : Entre Gemini 4 Carbon et GPT-6 Astra, lequel est le plus fort ?
Ça dépend de la tâche. D’après les données auto-déclarées dans la fiche modèle de Google, Astra est devant sur FrontierSWE 2, Carbon l’emporte sur plusieurs benchmarks comme GraphWalks, RiemannBench ou Terminal-Bench 4.0, et les deux sont quasiment à égalité sur SWE-sweep. L’AA Index v5.0 donne 59 contre 57, mais il s’agit d’un chiffre cité par Google, arrêté à octobre 2026, et non d’un nouveau test réalisé par un tiers.
Q3 : Quand Gemini 4 Carbon est-il disponible via l’API ?
Lors de sa première annonce le 28 octobre 2026, il n’était ouvert qu’à certains acteurs de la défense en cybersécurité. Depuis le 10 novembre, il est accessible aux développeurs payants, et le changelog de l’API Gemini l’indique en GA (disponibilité générale) à la même date.
Q4 : Le prix de sortie de GPT-6 Astra en contexte long est-il de 100 dollars ?
Non. Au-delà de 272K tokens en entrée, la requête entière est facturée avec un coefficient de 2 pour l’entrée et le cache, et de 1,5 pour la sortie. Cela donne 75 dollars par million de tokens en sortie, et 20 dollars en entrée.
Q5 : Comment appeler Gemini 4 Carbon et GPT-6 Astra en même temps ?
1. Créez un compte sur APIYI (apiyi.com) et récupérez votre clé API. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit ;
2. Définissez le base_url de votre SDK sur `https://api.apiyi.com/v1` ;
3. Pour Astra, utilisez `gpt-6-astra` via `/v1/responses`. Pour Carbon, utilisez `gemini-4-carbon` via `/v1/chat/completions` ou via le point d’accès natif `/v1beta`.
Q6 : Après le 1er décembre, Carbon coûtera-t-il toujours cinq fois moins cher qu’Astra ?
Sur le site officiel, Carbon passera à 4 dollars en entrée et 20 dollars en sortie à partir du 1er décembre. L’écart avec le palier de base d’Astra sera alors d’environ 2,5 fois. Pour savoir si APIYI s’aligne sur ce changement, référez-vous aux tarifs affichés ce jour-là dans la liste des modèles sur apiyi.com.
Q7 : Quelles sont les limites connues des deux modèles ?
La fiche modèle de Carbon mentionne les hallucinations, une résistance au jailbreak encore en cours de renforcement, des ralentissements ou timeouts occasionnels, et une consommation de tokens plus élevée sur les niveaux supérieurs. La sortie synchrone par défaut est limitée à 65 536 tokens, et la date limite des connaissances est mars 2026. Astra n’accepte ni audio ni vidéo en entrée, son tarif unitaire est plus élevé, et au-delà de 272K tokens en entrée, le surcoût s’applique à toute la requête.
Gemini 4 Carbon vs GPT-6 Astra : les points clés
- Pas de remplacement, mais une répartition des rôles : chacun domine sur certains terrains, et mieux vaut répartir les tâches que de se fier au classement général.
- Correction de code : Astra en tête : sur FrontierSWE 2, 65,5 % contre 61,2 %, le meilleur score d’Astra du tableau.
- Contexte long et science : Carbon devant : GraphWalks 96,2 % contre 71,8 %, RiemannBench 80 % contre 72 %.
- SWE-sweep : égalité : 9,6 % contre 9,5 %, un écart qui reste dans la marge d’erreur.
- Écart de prix d’environ 5× : Carbon en tarif promotionnel à 2/10, Astra en palier de base à 10/50, et 20/75 au-delà de 272K tokens d’entrée.
- Protocoles différents : Astra privilégie l’API Responses, Carbon passe par l’API native Gemini ou par un Chat compatible OpenAI.
- Une seule clé pour les deux : les deux modèles sont disponibles sur APIYI (apiyi.com), ce qui facilite la répartition du trafic et la comparaison.
Conclusion
Ce qu’il faut retenir de la comparaison entre Gemini 4 Carbon et GPT-6 Astra :
- Chacun a ses points forts dans les benchmarks : Astra l’emporte sur les problèmes d’ingénierie sur dépôts publics, Carbon sur le contexte long, le raisonnement scientifique et la plupart des tableaux de travail sur les connaissances. Tous les chiffres sont auto-déclarés par les éditeurs.
- Chacun a ses limites techniques : Astra offre 128K de sortie indépendante et une tarification par paliers à partir de 272K ; Carbon propose une fenêtre partagée de 1M, avec une sortie synchrone de 65 536 tokens par défaut.
- Les prix dépendent de la date : le tarif promotionnel de Carbon sur le site officiel court jusqu’au 30/11/2026, puis double à partir du 1er décembre.
Concrètement, le plus simple est d’intégrer les deux modèles dans la même logique de routage : les tâches de correction de code vont vers Astra, les longs documents et les tâches scientifiques vers Carbon. Avec APIYI (apiyi.com), vous pouvez lancer un lot de tâches réelles avec une seule clé, comparer les résultats et la facturation, puis fixer la répartition qui vous convient.
📚 Références
- Annonce d’ouverture de Gemini 4 Carbon : blog officiel de Google, 2026-11-10
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Description : périmètre d’ouverture et canaux de distribution
-
Fiche modèle de Gemini 4 Carbon : Google DeepMind
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon/ -
Description : résultats de benchmarks à octobre 2026 et limites connues
-
Guide développeur de Gemini 4 Carbon : Google AI Studio
- Lien :
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Description : thinking_level, fenêtre partagée de 1M et points d’attention pour la migration
-
Tarifs des modèles Google Cloud : page de tarification de Model Garden
- Lien :
cloud.google.com/model-garden/pricing -
Description : période promotionnelle et tarifs officiels à partir du 1er décembre
-
Page du modèle GPT-6 Astra : documentation développeur OpenAI
- Lien :
developers.openai.com/api/docs/models/gpt-6-astra -
Description : contexte, limite de sortie, niveaux de reasoning.effort
-
Tarification de l’API OpenAI : documentation développeur OpenAI
- Lien :
developers.openai.com/api/docs/pricing -
Description : tarification par paliers à 272K et prix d’écriture du cache
-
Tableau des modèles et interface de tarification APIYI
- Lien :
docs.apiyi.com/models,api.apiyi.com/api/pricing - Description : modèles, groupes et prix affichés ; la console fait foi
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus d’informations sur l’intégration des modèles, rendez-vous sur le centre de documentation docs.apiyi.com


