
Note de l’auteur : vous utilisez déjà gemini-4-argon et vous hésitez à passer à gemini-4-carbon ? En m’appuyant sur le guide développeur de Google et sur les fiches de modèle, cet article explique ce que les deux modèles ont en commun, ce qui les distingue, les 4 anciens paramètres à nettoyer lors de la migration, et les cas où il vaut mieux ne pas changer.
Commençons par la conclusion : Gemini 4 Carbon et Gemini 4 Argon ont le même tarif d’entrée, mais il ne faut pas remplacer Argon partout pour le développement de fonctionnalités au quotidien. Le guide développeur de Google recommande de garder Argon pour la plupart des tâches d’ingénierie logicielle et de travail sur la connaissance, et de ne passer à Carbon que lorsque la difficulté de la tâche atteint le plafond. Un prix unitaire identique ne veut pas dire une facture identique : Carbon dépense davantage de tokens de réflexion, et il est aussi plus lent.
Ce n’est pas un article du genre « le nouveau modèle est plus fort, donc on change tout ». Le 2026-11-10, le blog officiel de Google a annoncé l’ouverture de Gemini 4 Carbon aux développeurs payants, et le changelog de l’API Gemini a enregistré le même jour le passage de gemini-4-carbon en GA. Pour Argon, la GA est consignée au 2026-11-05. Tous les scores de benchmark cités ici proviennent de chiffres déclarés par Google ou de sa documentation, pas d’expériences comparatives menées par des tiers.
Ce que vous allez en retirer : après cette lecture, vous saurez quand passer de Gemini 4 Argon à Gemini 4 Carbon, quels 4 anciens paramètres supprimer en changeant de nom de modèle, et dans quels cas rester sur Argon est plus avantageux.
Gemini 4 Carbon vs Gemini 4 Argon : commençons par les points communs
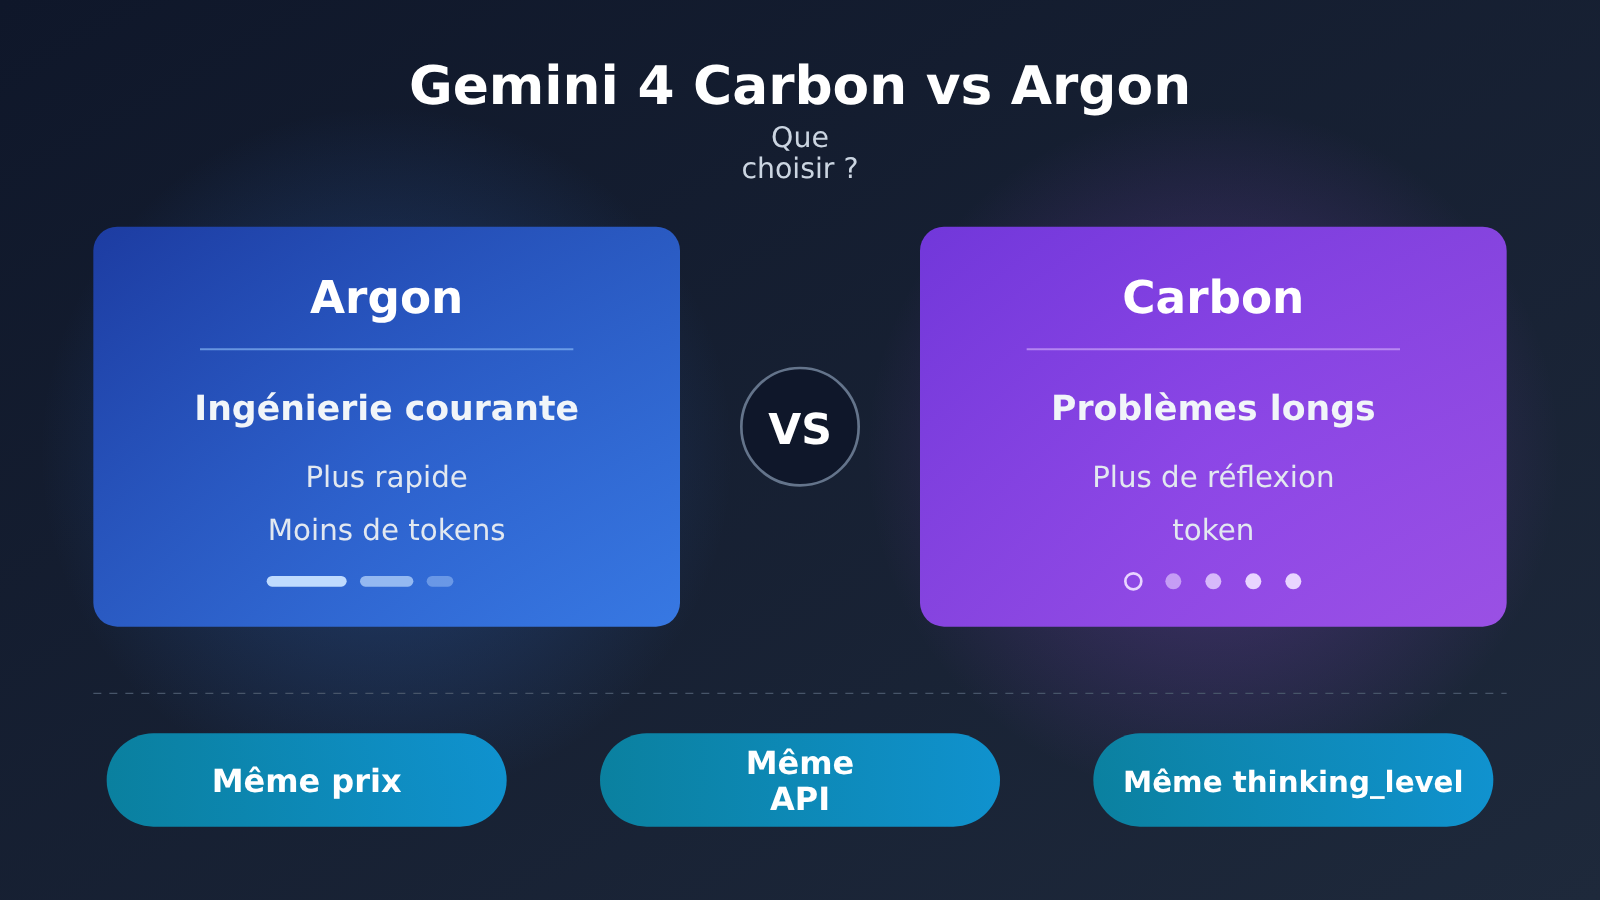
Gemini 4 Carbon est construit sur Gemini 4 Argon. D’après le guide du développeur, pour passer de gemini-4-argon à gemini-4-carbon, il suffit de changer le nom du modèle. Les deux utilisent le même paramètre thinking_level et la même fenêtre partagée de 1M, donc les limites de migration sont strictement identiques. La vraie question à se poser, c’est « est-ce que ça vaut le coup de dépenser plus de tokens de réflexion ? ». L’adaptation de l’interface, elle, n’est pas un sujet.
| Critère | Gemini 4 Argon | Gemini 4 Carbon | Identique ? |
|---|---|---|---|
| ID du modèle | gemini-4-argon |
gemini-4-carbon |
Seul le nom change |
thinking_level |
low / medium / high, medium par défaut | low / medium / high, medium par défaut | Identique |
| Fenêtre de contexte | 1M partagé entre entrée, réflexion et sortie | 1M partagé entre entrée, réflexion et sortie | Identique |
| Limite de sortie synchrone par défaut | 65 536 tokens | 65 536 tokens | Identique |
| Mise en cache | Cache implicite, 95 % de réduction sur les entrées en cache | Cache implicite, 95 % de réduction sur les entrées en cache | Identique |
temperature / top_p / top_k |
Ignorés avec avertissement | Ignorés avec avertissement | Identique |
thinking_budget |
Obsolète | Obsolète | Identique |
| Modalités d’entrée | Texte, image, audio, vidéo | Texte, image, audio, vidéo | Identique |
Fenêtre et niveaux de réflexion de Gemini 4 Carbon et Argon
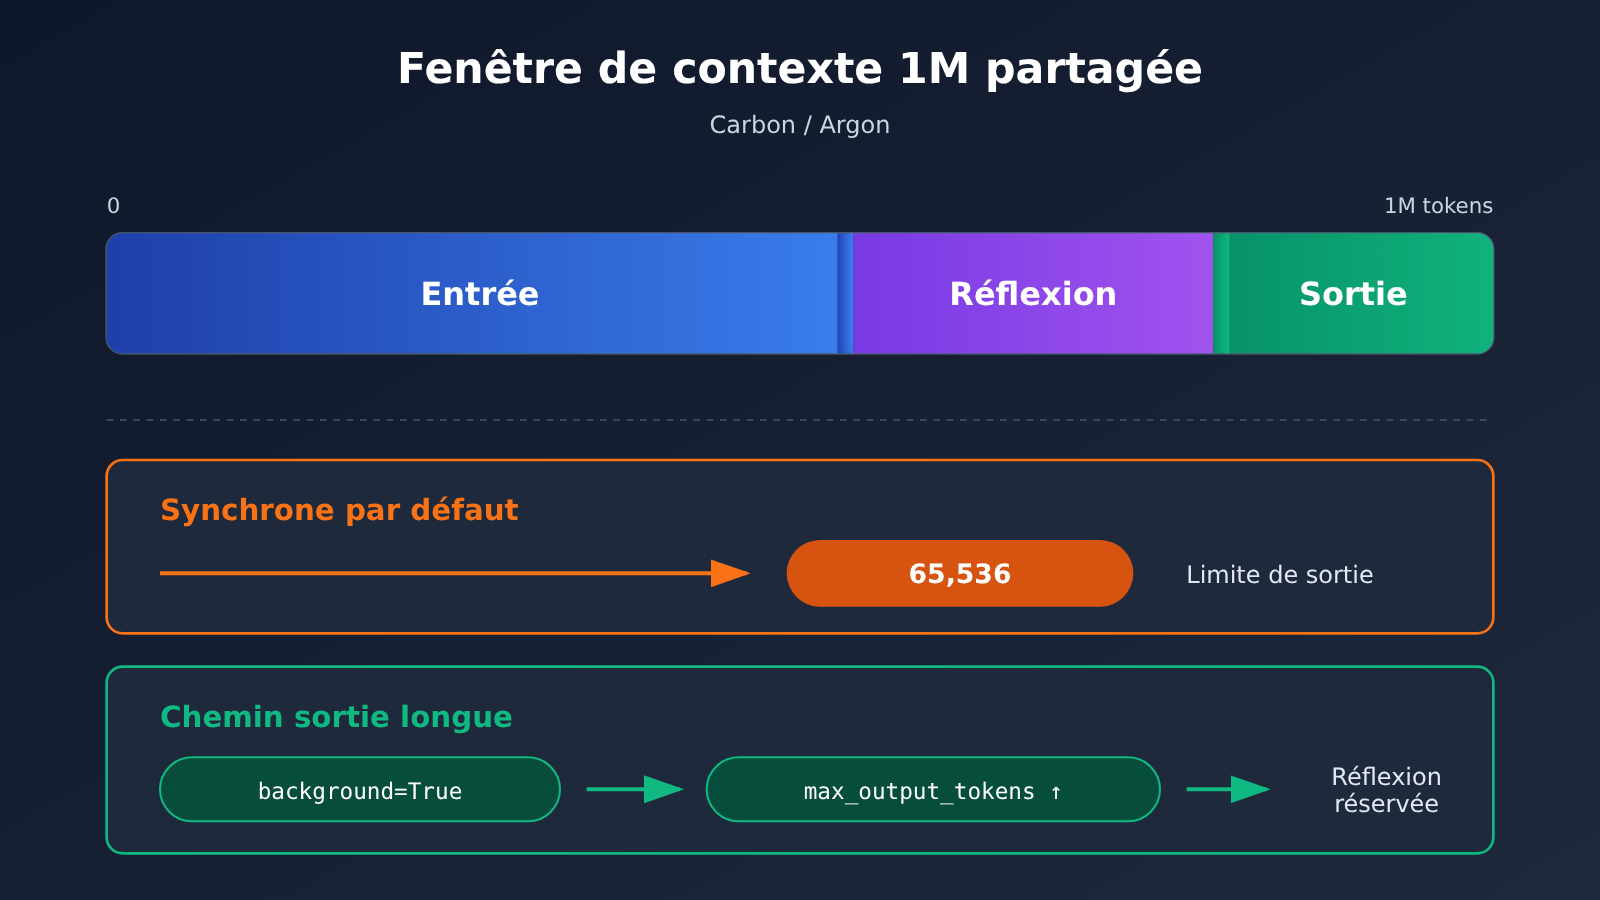
Sur la génération précédente, « réflexion + réponse » plafonnait à 64K. Carbon comme Argon passent à une fenêtre de 1M tokens partagée entre l’entrée, la réflexion et la sortie. Attention toutefois : la limite de sortie synchrone par défaut reste de 65 536 tokens. Pour obtenir une sortie plus longue, il faut utiliser background=True sur l’Interactions API, puis définir max_output_tokens au-delà de 65536, tout en laissant de la marge pour la réflexion afin que la réponse ne soit pas tronquée.
L’usage de thinking_level est le même des deux côtés. La documentation recommande high pour l’analyse de causes racines sur plusieurs fichiers, les correctifs de sécurité, les mathématiques formelles et la conception d’architecture en amont. medium est l’équilibre par défaut entre vitesse, coût et réussite du premier coup. low convient à la classification, au routage et à l’extraction ciblée. Carbon ne produit que du texte : on ne peut pas l’utiliser comme modèle de génération d’images ou de vidéos.
Différences clés entre Gemini 4 Carbon et Gemini 4 Argon
La vraie différence entre les deux tient à la « profondeur de réflexion ». Dans son guide pour développeurs, Google précise que Carbon consomme davantage de tokens de réflexion que Argon : il explore les hypothèses jusqu’au bout et fait tourner plus longtemps ses boucles de vérification. Argon, lui, est positionné sur des tokens plus économes et des interactions plus rapides. Résultat : avec la même invite, Carbon peut coûter plus cher et prendre plus de temps par tâche.
| Critère de comparaison | Gemini 4 Argon | Gemini 4 Carbon | Avantage |
|---|---|---|---|
| Positionnement officiel | La plupart des tâches d’ingénierie logicielle et de travail sur la connaissance | Les problèmes difficiles qui poussent l’intelligence dans ses retranchements | Selon la difficulté de la tâche |
| Consommation de tokens de réflexion | Plus restreinte | Plus importante | Argon plus économe |
| Vitesse de réponse | Plus rapide, adapté à l’interaction | Peut prendre plusieurs minutes sur les invites difficiles | Argon plus rapide |
| Scores des fiches de modèle | Référence | Généralement plus élevés sur les points comparables | Carbon |
| Coût par tâche | Plus maîtrisable | Potentiellement plus élevé à tarif unitaire identique | Argon |
| Spécialisation cybersécurité | Non incluse | Les scores élevés viennent de la voie Fairwind | Un simple changement de nom ne les donne pas |
Scores de la fiche de modèle Gemini 4 Carbon face à Argon
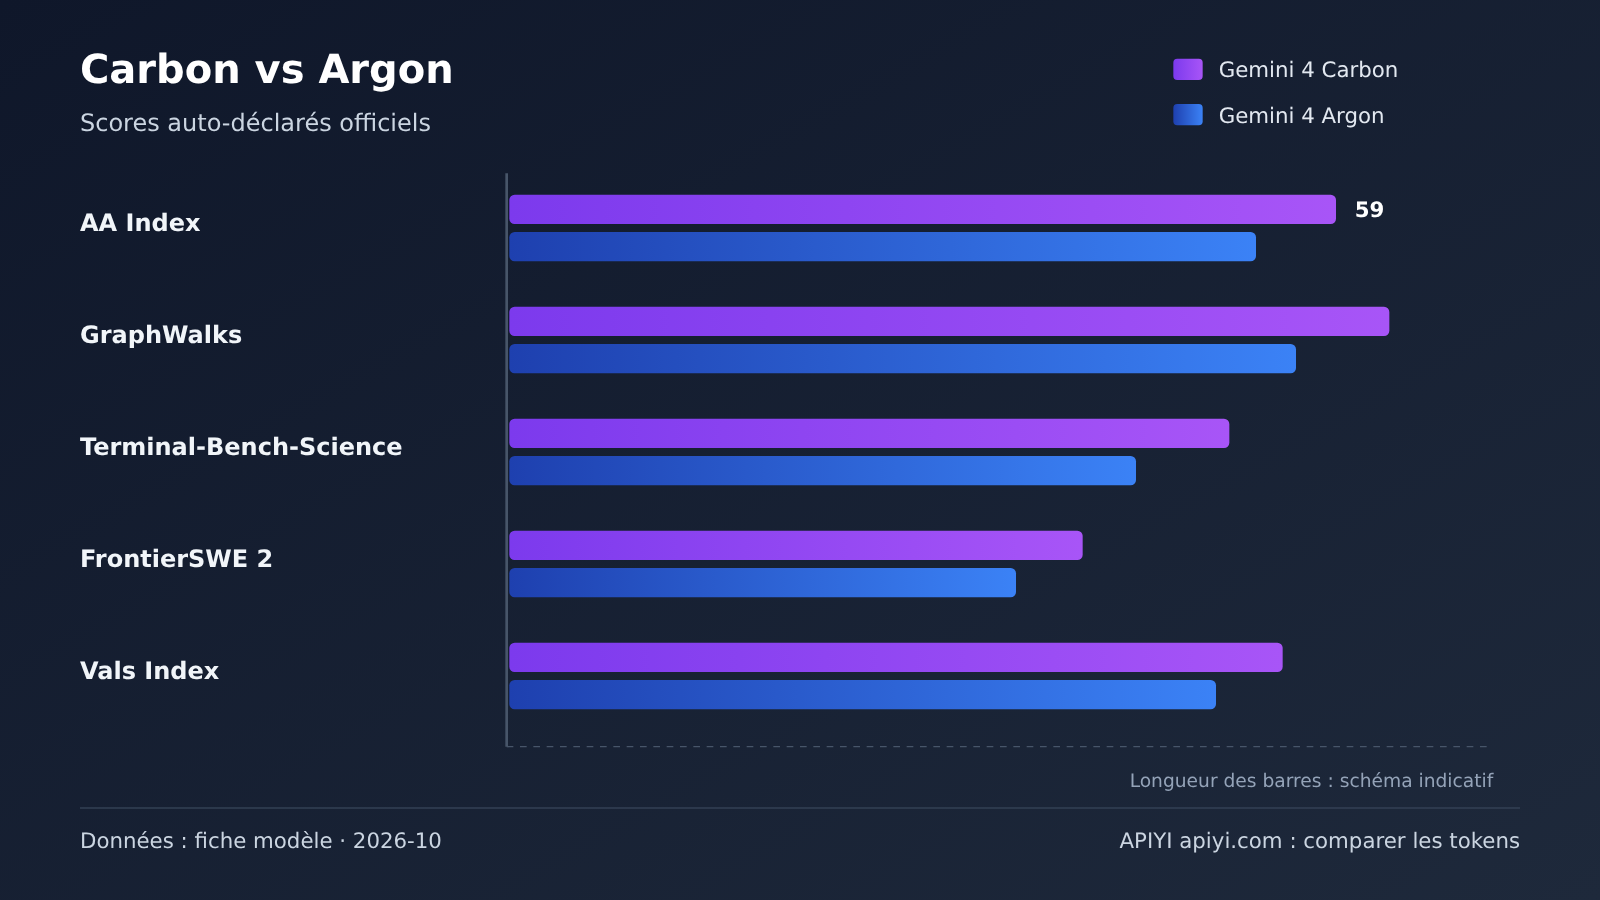
Les données ci-dessous proviennent de la fiche de modèle de Gemini 4 Carbon, publiée en novembre 2026, avec des résultats arrêtés à octobre 2026. Il s’agit de chiffres auto-déclarés par l’éditeur. Sur Terminal-Bench 4.0, la case d’Argon est imprimée « 571 % » dans la fiche, ce qui n’est pas un pourcentage plausible ; cet article laisse donc ce test de côté et note seulement que Carbon obtient 65,2 % dessus.
| Benchmark (auto-déclaré, arrêté à 2026-10) | Gemini 4 Carbon | Gemini 4 Argon | Lecture de l’écart |
|---|---|---|---|
| AA Index v5.0 | 59 | 50 | Avance nette en intelligence globale |
| GraphWalks 256k–1M BFS (F1) | 96,2 % | 84,2 % | Gros écart en recherche sur contexte long |
| Terminal-Bench-Science 0.1 | 64,8 % | 52,9 % | Avance sur les tâches de terminal scientifiques |
| RiemannBench | 80,0 % | 76,0 % | Légère avance en raisonnement mathématique |
| FrontierSWE 2 | 61,2 % | 55,0 % | Avance en programmation |
| SWE-sweep | 9,6 % | 4,3 % | Valeurs absolues faibles dans les deux cas |
| Agents’ Last Exam v1.1 | 77,4 % | 69,0 % | Avance sur les tâches d’agent |
| OSWorld-2.1 (sous-ensemble hors ligne) | 81,5 % | 74,7 % | Avance sur Argon en utilisation d’ordinateur |
| Vals Index v2.2 | 70,4 % | 69,2 % | Écart très faible |
| Chartography | 72,5 % | 71,6 % | Écart très faible |
Ce tableau se lit à plusieurs niveaux. Sur GraphWalks (contexte long), les tests scientifiques et la plupart des tests de programmation, l’avance de Carbon sur Argon est assez nette. Sur Vals Index et Chartography, l’écart n’est que d’environ 1 point : dans le travail quotidien sur la connaissance, vous ne le sentirez pas forcément. Par ailleurs, Carbon ne gagne pas partout dans ce même tableau : sur FrontierSWE 2, le meilleur score est celui de GPT-6 Astra (65,5 %), et sur OSWorld-2.1, c’est Claude Opus 5.5 (87,2 %).
Pour l’AA Index, cet article retient uniformément le 59 cité dans la fiche de modèle, soit l’AA Index v5.0 d’octobre 2026. Une page tierce a affiché un autre chiffre le 2026-11-11, mais les informations de cette page se contredisent ; nous ne le considérons donc pas comme une valeur confirmée.
Comment interpréter les scores de cybersécurité de Gemini 4 Carbon
Dans la fiche du modèle, les trois benchmarks CWE-bench, ExploitGym et SEC-bench Pro indiquent les performances obtenues via le Fairwind Program. Le communiqué du 28 octobre précise aussi que ces benchmarks ont été évalués sans garde-fous. Les capacités spécialisées en cybersécurité sont réservées aux défenseurs dont l’identité a été vérifiée, via le Fairwind Program : l’API payante n’y donne pas accès par défaut.
Autrement dit, remplacer le nom du modèle par gemini-4-carbon ne vous donne pas automatiquement ces scores de sécurité, et cela ne signifie pas non plus que vous utilisez la version Cyber Permissive. Dans la grille tarifaire du site officiel, Cyber Permissive n’est d’ailleurs pas éligible au tarif promotionnel, un point que nous reverrons dans la partie consacrée aux prix.
Gemini 4 Carbon vs Argon : même tarif unitaire, facture différente
Commençons par les prix affichés sur le site officiel de Google. D’après les pages de tarification de Google Cloud et d’AI Studio, vérifiées le 2026-11-11, Carbon et Argon ont exactement la même grille tarifaire. Jusqu’au 2026-11-30 inclus, le prix mondial est de 2 $ en entrée, 0,10 $ pour l’entrée en cache et 10 $ en sortie par million de tokens. À partir du 2026-12-01, les prix passent à 4 $ en entrée, 0,20 $ en cache et 20 $ en sortie. Le prix de sortie couvre à la fois la réponse et la partie raisonnement : plus le modèle « réfléchit » (plus il génère de tokens de réflexion), plus la facture grimpe.
| Poste de facturation (USD / 1M tokens) | Gemini 4 Argon | Gemini 4 Carbon | Plateforme disponible |
|---|---|---|---|
| APIYI entrée | 2 | 2 | APIYI apiyi.com |
| APIYI sortie | 10 | 10 | APIYI |
| APIYI lecture du cache | 0,10 | 0,10 | APIYI |
| APIYI groupes | default, svip | default, svip | APIYI |
| APIYI points d’accès | gemini, openai | gemini, openai | APIYI |
| Prix mondial officiel (jusqu’au 11-30) | 2 / 0,10 / 10 | 2 / 0,10 / 10 | Google officiel |
| Prix mondial officiel (à partir du 12-01) | 4 / 0,20 / 20 | 4 / 0,20 / 20 | Google officiel |
Côté APIYI, les données proviennent de l’interface de tarification au 2026-11-11 : gemini-4-carbon est déjà disponible, avec un prix affiché identique à celui de gemini-4-argon. Les groupes default et svip ont tous deux un multiplicateur de 1, et le modèle prend en charge le point d’accès natif gemini (/v1beta) ainsi que le point d’accès compatible OpenAI (/v1/chat/completions). Si le tableau récapitulatif de la documentation que vous consultez n’affiche pas encore la ligne Carbon, fiez-vous à la console et à l’interface de tarification : les références de modèles et les prix font foi dans la liste des modèles de la plateforme. Les tarifs du tableau sont les prix affichés par défaut ; la facturation réelle dépend de ce qu’indique la console.
À tarif unitaire égal, c’est le nombre de tokens qui détermine la facture. Sur le niveau high, Carbon explore davantage d’hypothèses et enchaîne des boucles de vérification plus longues : côté sortie, ses tokens de réflexion sont nettement plus nombreux que ceux d’Argon. Pour évaluer le coût, comparez donc le « coût total par tâche » plutôt que le prix par million de tokens.
💰 Conseil coût : si vous appelez déjà
gemini-4-argonsur APIYI apiyi.com, avant de changer de modèle, vérifiez dans la liste des modèles que ces deux identifiants affichent bien toujours le même tarif. Prenez ensuite quelques invites difficiles et représentatives, passez-les dans les deux modèles et comparez le nombre de tokens de sortie par requête : vous aurez une bonne estimation de l’évolution réelle de votre facture après le changement.
Comment passer de Gemini 4 Argon à Gemini 4 Carbon
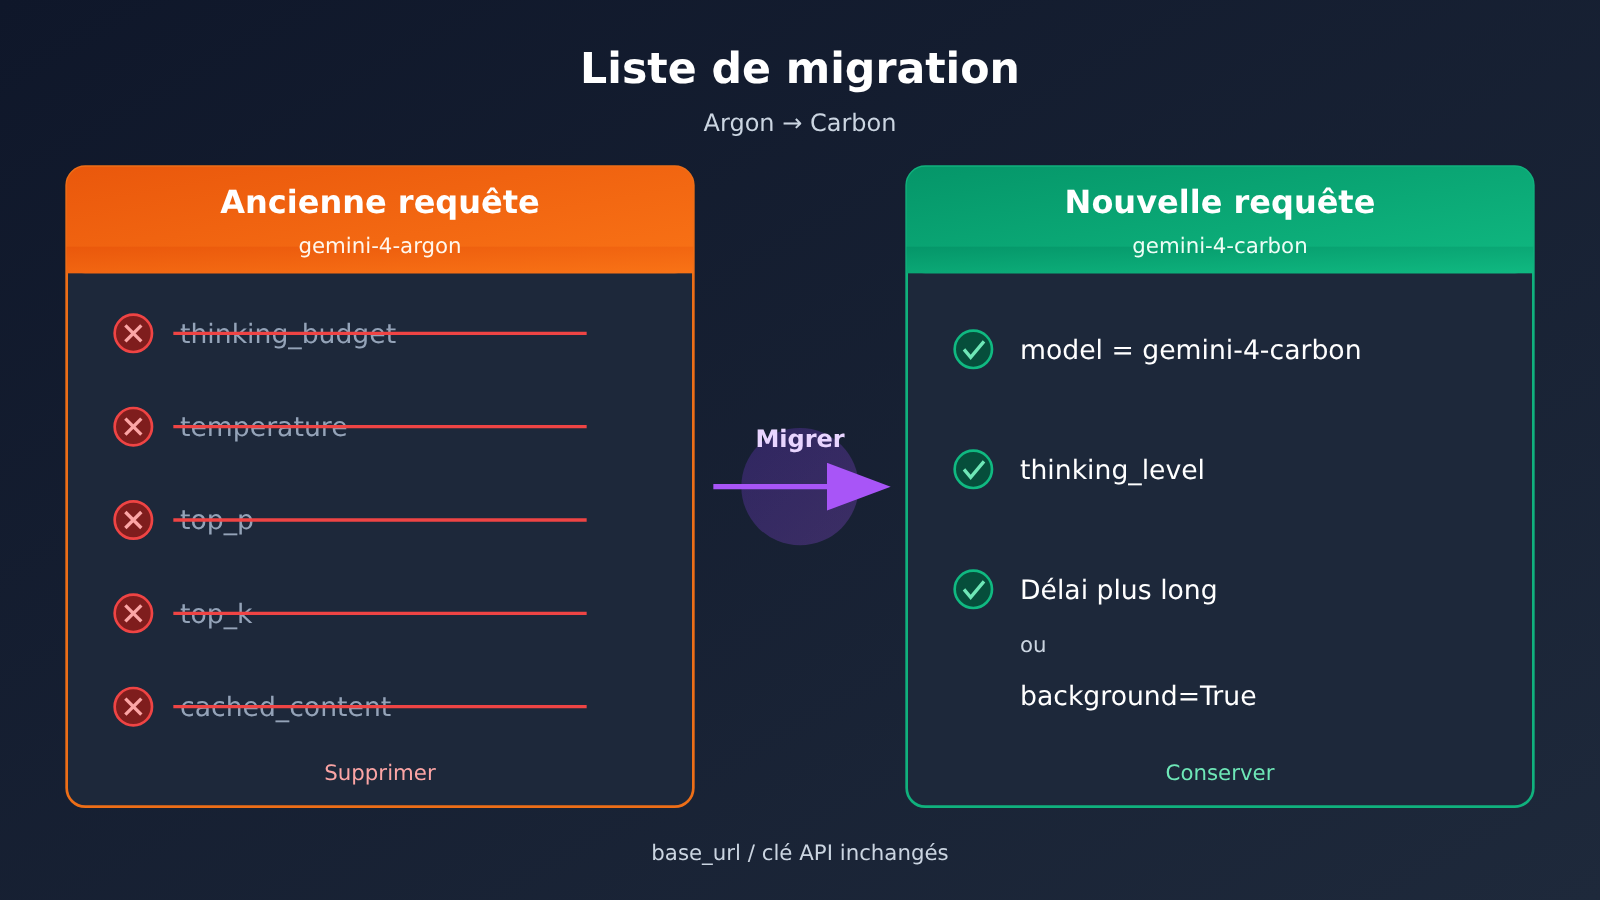
La migration se résume à remplacer le nom du modèle, mais il faut aussi nettoyer les paramètres hérités de l’ancien code. Sinon, vos logs se rempliront d’avertissements et le comportement de génération ne sera pas celui que vous attendez. Voici les 4 anciens paramètres à retirer lors du changement :
thinking_budget: déprécié, il déclenche un avertissement s’il est transmis. Utilisez plutôtthinking_level, avec trois niveaux au choix (low, medium, high). Le niveau par défaut est medium.temperature: toute valeur personnalisée est ignorée et génère un avertissement. Supprimez-la, et ne comptez plus sur elle pour contrôler l’aléatoire.top_p: même traitement, il est ignoré avec avertissement. Supprimez-le aussi.top_k: idem, ignoré avec avertissement. Supprimez-le également.
Deux autres ajustements liés ne concernent pas à proprement parler les paramètres d’échantillonnage, mais ils piègent tout aussi facilement :
- Ne créez plus et ne transmettez plus de
cached_contentexplicite : le cache implicite est activé automatiquement et les entrées en cache bénéficient d’une remise de 95 %. Vous pouvez donc retirer le code de gestion manuelle du cache. - Augmentez le délai d’expiration côté client : une invite difficile peut mettre plusieurs minutes à répondre. Le guide du développeur recommande un délai d’au moins 15 à 20 minutes, ou l’exécution asynchrone avec
background=True. Carbon réfléchit plus longtemps, ce point est donc encore plus important qu’avec Argon.
Les étapes pour appeler Gemini 4 Carbon via APIYI
Si vous appelez déjà Argon via l’interface compatible OpenAI, le basculement est très court :
- Gardez
base_urlàhttps://api.apiyi.com/v1et conservez la même clé API. - Remplacez la valeur du champ
model:gemini-4-argondevientgemini-4-carbon. - Supprimez les 4 anciens paramètres
temperature,top_p,top_ketthinking_budget, puis conservez ou ajoutezthinking_level. - Supprimez toute la logique liée à
cached_contentexplicite et portez le délai d’expiration client à plus de 15 minutes. - Faites un déploiement progressif sur un lot de vrais problèmes difficiles, en notant le nombre de tokens en sortie et la durée de réponse, puis élargissez une fois les gains confirmés.
Pour les projets qui utilisent le protocole natif, sur le point d’accès gemini (/v1beta), on ne change là aussi que le nom du modèle, et les étapes de nettoyage restent identiques. Les deux modèles partagent la même clé API, sans activation séparée.
🚀 Démarrage rapide : nous vous conseillons de lancer d’abord un test progressif sur APIYI (apiyi.com) avec le crédit gratuit offert aux nouveaux utilisateurs. Avec une seule clé, vous appelez Argon et Carbon en même temps, ce qui permet de répartir les requêtes selon le type de tâche plutôt que de basculer brutalement d’un modèle à l’autre.
Gemini 4 Carbon vs Argon : quel modèle pour quel scénario ?
Google le dit sans détour dans son billet officiel : si Argon convient aux tâches complexes, Carbon est le modèle à sortir pour les problèmes les plus difficiles. Concrètement, on peut départager les cas d’usage comme suit :
Quand choisir Gemini 4 Carbon
- Ingénierie multi-étapes sur la durée : débogage complexe sur plusieurs fichiers, conception d’architecture et audit, des tâches où le modèle doit faire tourner longtemps ses boucles de vérification.
- Recherche dans de très longs contextes : lorsque vos documents approchent la fenêtre de 1M de tokens et qu’il faut y faire du parcours de graphe ou du raisonnement entre paragraphes. L’écart sur GraphWalks est le plus parlant.
- Sciences et mathématiques formelles : recherche scientifique ouverte, preuves formelles. Terminal-Bench-Science et RiemannBench penchent tous deux en faveur de Carbon.
- Synthèse de haute précision : analyse de documents financiers ou juridiques, quand on préfère attendre un peu plutôt que de risquer des erreurs.
- Le « cerveau » de l’orchestration d’agents : pour la fonction
/swarmde la préversion d’Antigravity, Google recommande de confier à Carbon les rôles d’architecture, de coordination et d’audit, et de laisser les tranches d’implémentation parallèles àgemini-4-argonougemini-3.8-flash.
Quand rester sur Gemini 4 Argon
- Développement de fonctionnalités au quotidien : écrire des API, modifier des pages, ajouter des tests. La qualité d’Argon suffit largement, et il est plus rapide.
- Codage interactif : complétion dans l’IDE, modification de code en mode conversation. Les quelques minutes d’attente de Carbon casseraient votre rythme.
- Travail de connaissance et traitement de documents : résumé, réécriture, questions-réponses. Sur le Vals Index, les deux modèles ne sont séparés que d’environ 1 point de pourcentage.
- Classification, routage, extraction : ces tâches relèvent naturellement du niveau « low », passer à Carbon n’a guère d’intérêt.
- Traitements par lots sensibles au coût par tâche : à tarif unitaire égal, Argon consomme moins de tokens, donc la facture reste plus facile à maîtriser.
Ne regardez pas que Gemini 4 Carbon pour ces scénarios
D’après la fiche du modèle, sur le sous-ensemble hors ligne d’OSWorld-2.1 (utilisation de l’ordinateur), Claude Opus 5.5 arrive en tête avec 87,2 %. Sur FrontierSWE 2 (dépôts publics), GPT-6 Astra obtient le meilleur score avec 65,5 %. Sur SWE-sweep, Carbon (9,6 %) et Astra (9,5 %) sont quasiment à égalité, l’écart restant dans la marge d’erreur. Quant à la défense en cybersécurité, il faut passer par une demande Fairwind, plutôt que d’espérer l’obtenir en changeant simplement de nom de modèle.
Gemini 4 Carbon ou Argon : comment choisir
Résumons tout ça en un petit processus de décision. Première question : est-ce qu’Argon « n’arrive déjà plus à faire le travail » sur votre tâche ? S’il livre de façon stable, gardez-le. Ce n’est que lorsqu’Argon échoue à répétition sur du raisonnement en plusieurs étapes, oublie des informations dans un long contexte ou vérifie trop peu ses résultats qu’il vaut la peine d’envoyer ces requêtes-là, et seulement celles-là, vers Carbon.
Concrètement, mieux vaut répartir les requêtes par type de tâche que tout remplacer d’un coup. Par exemple, dans votre code, choisissez le nom du modèle selon le type de tâche : gemini-4-argon par défaut pour les requêtes courantes, et gemini-4-carbon en mode high uniquement pour celles marquées « revue d’architecture », « recherche de cause racine » ou « synthèse de documents longs ». Vous profitez ainsi du plafond de performance de Carbon sans que les tokens de réflexion fassent gonfler votre facture quotidienne.
Surveillez aussi le calendrier : le tarif promotionnel du site officiel court jusqu’au 2026-11-30, et à partir du 12-01 les prix officiels des deux modèles doublent en même temps. Comme les deux restent toujours au même prix, cette hausse ne change rien au choix du modèle à utiliser. Elle ne fait qu’amplifier l’écart de facture causé par les tokens de réflexion supplémentaires de Carbon.
💡 Notre conseil : le choix du modèle dépend de la difficulté de la tâche, pas du principe que « le plus récent est forcément meilleur ». Nous vous recommandons de passer par APIYI (apiyi.com) pour appeler les deux modèles avec le même lot d’invites, puis de comparer taux de réussite, durée et tokens de sortie, avant de décider quelles tâches méritent de passer à Carbon.
FAQ – Questions fréquentes
Q1 : Qu’est-ce que Gemini 4 Carbon ? Quel rapport avec Argon ?
Gemini 4 Carbon est, selon la communication actuelle de Google, le modèle Gemini le plus puissant. Son identifiant est `gemini-4-carbon` et il est construit sur Gemini 4 Argon. Il partage avec Argon la même interface, le même paramètre `thinking_level` et la même fenêtre de contexte partagée de 1M. La différence : il dépense davantage de tokens de réflexion pour venir à bout de tâches plus difficiles, à plus long terme.
Q2 : Gemini 4 Carbon et Gemini 4 Argon ont le même prix unitaire, alors pourquoi la facture est-elle plus élevée ?
Parce que le prix de sortie inclut la partie raisonnement, et que Google indique clairement que Carbon utilise plus de tokens de réflexion qu’Argon. Pour une même tâche, Carbon produit donc plus de tokens, et le coût total par tâche grimpe mécaniquement. Pour comparer les coûts, il faut regarder la dépense totale par tâche, et pas seulement le prix par million de tokens.
Q3 : Quand Gemini 4 Carbon a-t-il été ouvert ?
Google a présenté Carbon pour la première fois le 28/10/2026, mais uniquement à certains acteurs de la défense en cybersécurité. Le 10/11/2026, Google a annoncé l’ouverture aux développeurs payants, aux entreprises, aux scientifiques et aux consommateurs, et le changelog de l’API Gemini a enregistré la disponibilité générale (GA) le même jour. Côté grand public, il faut un abonnement Google AI Ultra ; pour les utilisateurs gratuits ou des offres inférieures, aucune date n’a été communiquée officiellement.
Q4 : Quelles modifications de code faut-il faire pour passer d’Argon à Carbon ?
Remplacez le nom du modèle par `gemini-4-carbon`, puis supprimez les 4 anciens paramètres `thinking_budget`, `temperature`, `top_p` et `top_k`. Ne passez plus non plus de `cached_content` explicite, et portez le délai d’expiration (timeout) côté client à 15-20 minutes, ou utilisez plutôt `background=True`.
Q5 : Comment appeler rapidement Gemini 4 Carbon via l’API ?
Avec une seule clé, vous pouvez tester les deux modèles :
1. Inscrivez-vous sur APIYI (apiyi.com) et récupérez votre clé API ; les nouveaux utilisateurs bénéficient d’un crédit de test gratuit.
2. Définissez `base_url` sur le point d’accès compatible OpenAI et renseignez `gemini-4-carbon` dans `model`.
3. Relancez les mêmes invites avec `gemini-4-argon`, puis comparez la qualité des résultats et la consommation de tokens.
Les deux modèles prennent en charge à la fois le point d’accès natif Gemini et le point d’accès compatible OpenAI.
Q6 : Quelles sont les limites connues de Gemini 4 Carbon ?
Voici les limites listées dans la fiche du modèle : des hallucinations, courantes sur les modèles de base, restent possibles ; la résistance au jailbreak est encore en cours de renforcement ; des ralentissements ou des délais d’expiration surviennent de façon occasionnelle ; et les niveaux de réflexion plus élevés consomment davantage de tokens. La date limite des connaissances est mars 2026, et elle peut être plus ancienne dans certains domaines. En cas de timeout, passez à `background=True` ; pour les tâches courantes, revenez à Argon.
Q7 : Passer à Gemini 4 Carbon donne-t-il accès aux capacités spécialisées en cybersécurité ?
Non. Les scores élevés en cybersécurité indiqués dans la fiche du modèle proviennent du parcours Fairwind Program, réservé aux acteurs de la défense dont l’identité a été vérifiée. L’API payante n’équivaut pas par défaut à Cyber Permissive, et le tarif de ce dernier n’est pas non plus soumis au prix promotionnel du site officiel.
Gemini 4 Carbon vs Argon : les points clés à retenir
- Même interface, même prix unitaire : il suffit de changer le nom du modèle pour migrer.
thinking_levelet la fenêtre partagée de 1M de tokens sont strictement identiques. - Même prix unitaire, facture différente : Carbon génère plus de tokens de réflexion et répond plus lentement, donc le coût par tâche peut être plus élevé.
- Restez sur Argon par défaut : pour le développement au quotidien, le codage interactif et le travail de connaissance, Argon est plus rapide et moins cher.
- Carbon uniquement pour les cas difficiles : l’ingénierie de longue haleine, les contextes très longs, le raisonnement scientifique et les synthèses de haute précision justifient la montée en gamme.
- Nettoyez 4 anciens paramètres : supprimez
thinking_budget,temperature,top_pettop_k, et augmentez le délai d’expiration. - Le score de sécurité ne suit pas le changement de nom : les usages spécialisés en cybersécurité passent par Fairwind, ce qui diffère de l’API payante par défaut.
- Répartissez d’abord, montez en gamme ensuite : comparez les deux modèles avec la même clé API et routez les requêtes selon le type de tâche.
En résumé
Voici ce qu’il faut retenir de la comparaison entre Gemini 4 Carbon et Gemini 4 Argon :
- Les points communs l’emportent largement sur les différences : il suffit de remplacer l’ID du modèle. Les niveaux de réflexion, la fenêtre de contexte, la remise sur le cache et les paramètres ignorés sont les mêmes.
- La différence tient à la profondeur de réflexion : sur la plupart des critères comparables de la fiche du modèle, Carbon fait mieux qu’Argon. En contrepartie, il consomme plus de tokens de réflexion et demande plus de temps d’attente.
- Répartir selon les tâches, c’est le plus rentable : gardez Argon pour les tâches courantes et réservez Carbon aux problèmes de longue haleine qui poussent le modèle dans ses retranchements.
Si vous utilisez déjà gemini-4-argon, inutile de tout migrer : isolez les requêtes les plus difficiles et déployez Carbon progressivement dessus. Nous vous conseillons de passer par APIYI (apiyi.com) pour comparer les deux modèles avec une seule clé, en mesurant le taux de réussite et la consommation de tokens, afin de décider sur des données réelles quelles tâches méritent la montée en gamme.
📚 Références
- Blog officiel de Google – Annonce d’ouverture de Gemini 4 Carbon : ouvert aux développeurs payants le 10/11/2026
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Description : source primaire pour le périmètre et les canaux d’ouverture
-
Google AI Studio – Guide du développeur Gemini 4 Carbon : points d’attention pour la migration et conseils de choix de modèle
- Lien :
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Description :
thinking_level, la fenêtre de 1M, les paramètres obsolètes et les recommandations de timeout viennent de là -
Google DeepMind – Fiche modèle Gemini 4 Carbon : benchmarks auto-déclarés par Google et limites connues
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon/ -
Description : source des données du tableau de benchmarks de cet article, résultats arrêtés à octobre 2026
-
Google Cloud – Page des tarifs des modèles : grille tarifaire officielle de Carbon et d’Argon
- Lien :
cloud.google.com/model-garden/pricing -
Description : tarif promotionnel valable jusqu’au 30/11 et nouveaux tarifs à partir du 01/12
-
Gemini API Changelog : historique des dates de disponibilité générale (GA)
- Lien :
aistudio.google.com/docs/changelog - Description : Carbon est en GA depuis le 10/11/2026, Argon depuis le 05/11/2026
Auteur : l’équipe technique d’APIYI
Échanges techniques : pour toute question sur le choix d’un modèle ou la migration, contactez-nous depuis la page d’accueil du site officiel d’APIYI. Les instructions d’intégration d’Argon sont disponibles surdocs.apiyi.com/models/gemini-4-argon


