
摘要:本文说明 AI 产品免费试用额度应该如何确定,并给出一套按真实调用成本推算预算、按数据复盘调整的方法。
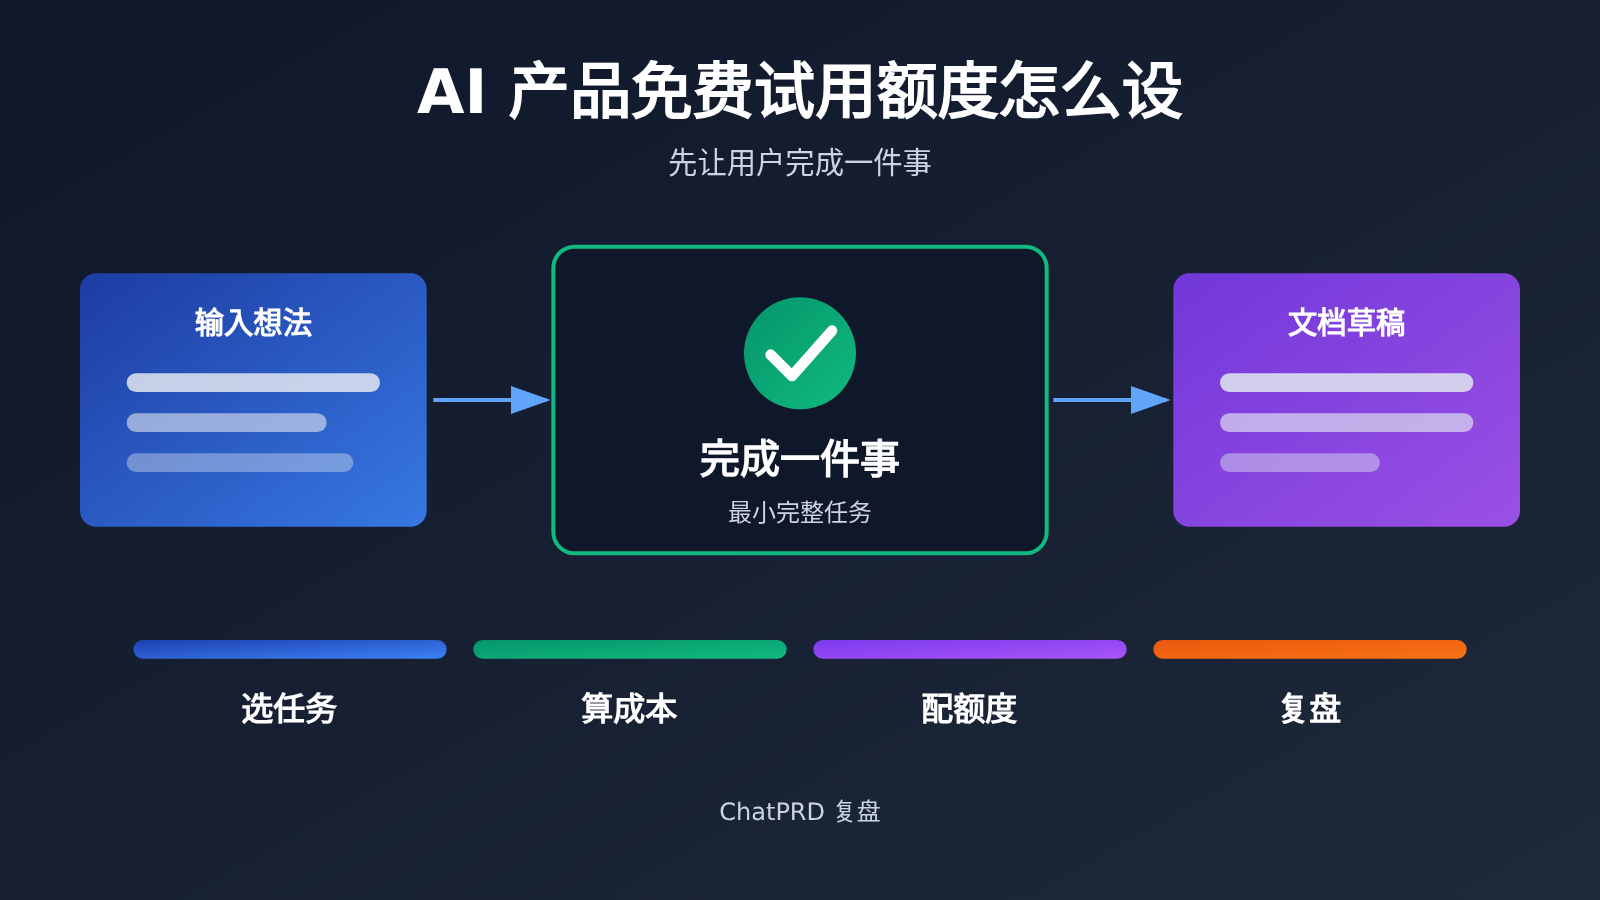
结论先行:AI 产品免费试用额度应该围绕一件事来设
AI 产品的免费试用额度不能从 token 数量或“给多少积分”开始定,应该先定下用户在试用期内要完成的那一件事。产品方需要先确定一个用户能直接感到价值的最小完整任务,再用真实样本测出完成它要花多少调用成本,最后乘以合理的试用任务次数,得到单账号额度和总预算。
这个答案受三个条件影响。第一个是任务能否在试用范围内真正完成,做不完的任务给多少额度都难以转化。第二个是成本是否来自真实样本,包括输入、输出、重试以及适用的缓存或工具费用。第三个是额度用完时用户是否清楚自己得到了什么、下一步能做什么。
ChatPRD 的复盘提供了一个现实参照:试用额度设得不好会造成成本损失,而一刀切关掉试用同样会伤害获客。所以要做的是把试用设计成可计算、可复盘的东西,而不是在“全开”和“全关”之间二选一。
免费试用额度设计的知识地图与索引
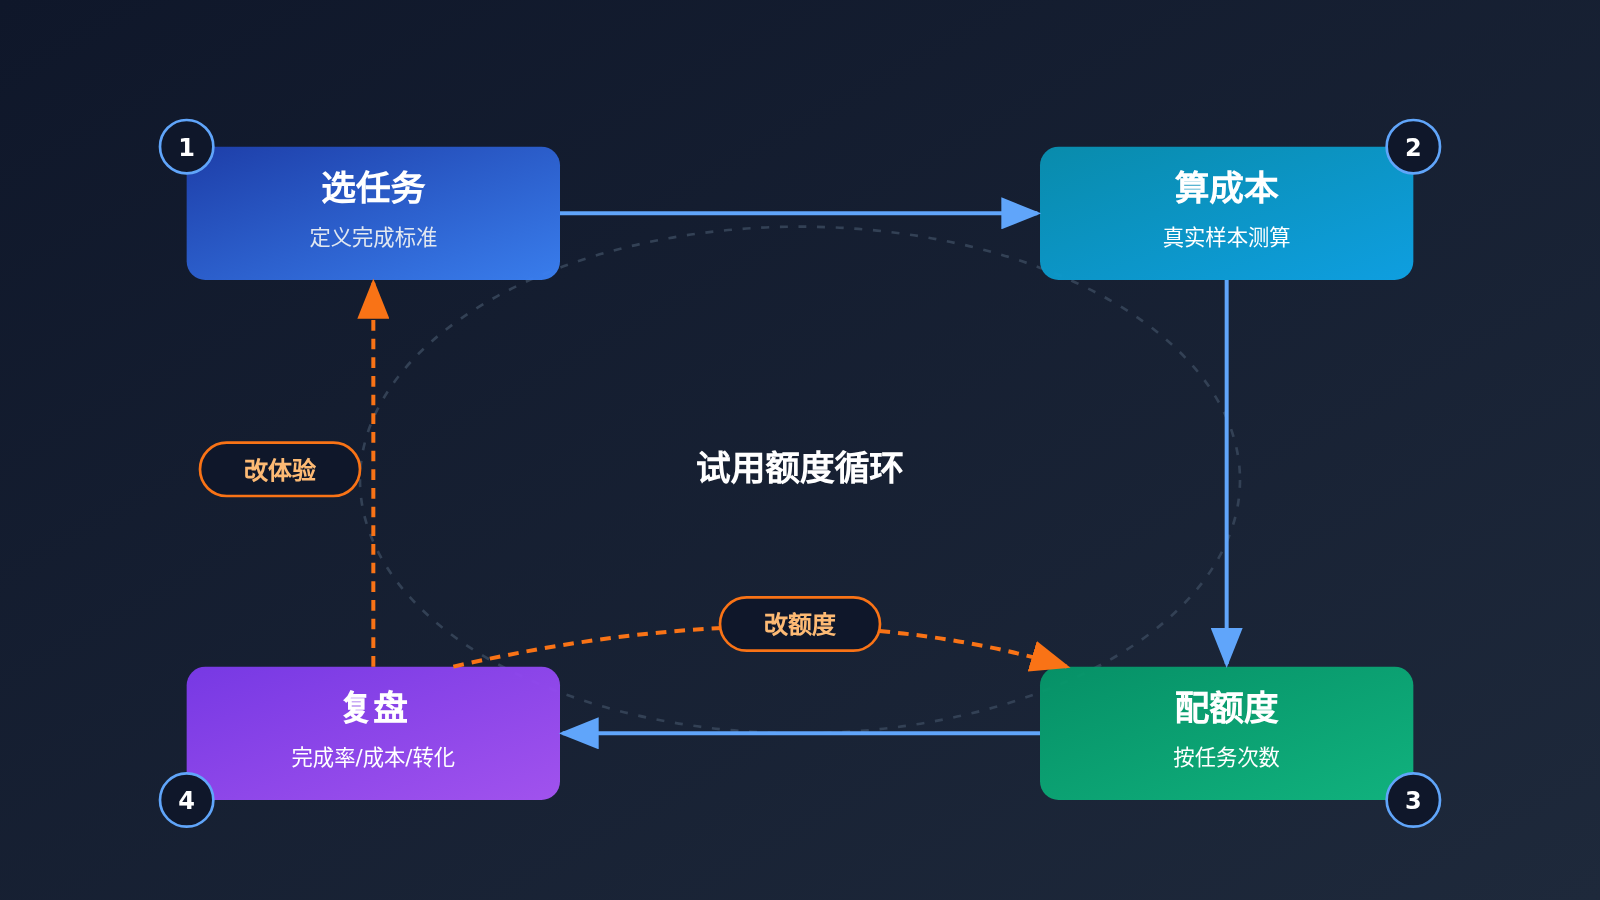
下面这张表同时充当知识地图和阅读索引。四个环节按执行先后排列,前一步的输出就是后一步的输入。
| 环节 | 对应正文 | 为什么要做 | 需要什么 | 得到什么 |
|---|---|---|---|---|
| 选任务 | 2、2.1、2.2 | 额度只有用于完成一件有价值的事才有意义 | 产品核心价值、典型用户的首个需求 | 一个有明确完成标准的最小任务,以及试用可用的功能边界 |
| 算成本 | 3、3.1、3.2 | 没有单次成本,额度和预算都只能拍脑袋 | 真实调用样本、模型单价、重试与附加费用 | 一次完成成本、单账号成本、总预算上限 |
| 配额度 | 3.3、4 | 用户需要看懂额度能做几次事,而不是看懂 token | 单账号成本、任务次数、用完时的提示文案 | 以“任务次数”表达的额度,以及清晰的用完提示 |
| 复盘 | 4.1 | 额度效果要靠数据验证,才能判断改体验还是改额度 | 完成率、每名完成者成本、付费转化数据 | 下一轮调整方向 |
推荐的阅读顺序是从第 1 节读到第 4 节。第 1 节交代问题背景,帮你避免对 ChatPRD 案例的误读。第 2 节给出示范任务,第 3 节的计算全部建立在这个任务上。第 4 节的复盘指标又会反过来修正第 2、3 节的设定,构成一个循环。如果你已经有明确的核心任务,可以直接从第 3 节开始。
To Know:理解免费试用额度测算的必要术语
| 术语 | 简明解释 |
|---|---|
| Token | 大模型计量输入和输出文本长度的单位,多数模型 API 按输入、输出 token 分别计价 |
| 最小完整任务 | 用户在试用中能独立完成、并能直接感受到产品价值的一件事,是额度设计的基本单位 |
| 重试 | 用户对结果不满意而重新生成,或请求失败后再次调用,都会产生额外成本 |
| 一次完成成本 | 完成一次最小完整任务的平均调用成本,包含重试和适用的附加费用 |
| 首次有效任务完成率 | 试用用户中,至少完整完成一次核心任务的人所占比例 |
1. ChatPRD 复盘:免费试用额度出问题时发生了什么
1.1 复盘中的关键事实
ChatPRD 创始人 Claire Vo 在 2026-11-16 发布了一篇复盘,主题是 token 欺诈正在侵蚀 AI 产品的利润。她自述,此前近一年里为此花掉了数万美元,还曾经关闭免费试用,结果损害了获客和企业销售线索的获取。
复盘里还有一个容易被误读的数字:近 20 万美元。这是失败的支付尝试金额,并不是实际损失的金额。转述这个案例时,要把“已花掉的数万美元”和“近 20 万美元失败支付尝试”分开说,否则会严重夸大问题规模。
1.2 不要从这个案例得出“取消试用”的结论
ChatPRD 现行公开定价页仍然列有免费计划,Pro 和 Teams 方案也提供 14 天试用。所以不能把这次复盘理解为 ChatPRD 已经取消所有免费试用,更不能把单个产品的经历外推成整个行业的做法。
这个案例真正值得借鉴的是两面教训。试用额度被滥用会直接吃掉利润,而关掉试用又会让真实的潜在用户和企业客户流失。产品方需要的是一种既能让真实用户感到价值、又能把补贴成本算清楚的额度设计方法,下面几节就围绕这个目标展开。
2. 用“生成一份可编辑的 PRD 草稿”设计免费试用额度
为了让后面的计算有具体对象,这里用一个示范任务:用户输入一个产品想法,最终得到一份可以继续编辑的 PRD 草稿。之所以选它,是因为它离产品经理的真实工作最近,用户拿到结果后能马上判断“这东西有没有用”。
需要说明的是,这只是一个示范任务,用来演示方法,不代表 ChatPRD 实际的试用设计。你的产品可以把它替换成“生成一份竞品分析”“改写一段营销文案”或“完成一次代码审查”,方法不变。
2.1 定义免费试用任务的完成标准
完成标准要能被检查,最好能在产品数据里埋点判断。对“生成一份可编辑的 PRD 草稿”来说,可以这样定义:
- 用户提交了一个产品想法,并回答了必要的澄清问题。
- 系统生成了一份结构完整的草稿,至少包含背景、目标用户、核心需求和验收条件这几个部分。
- 用户对草稿进行过至少一次编辑或要求修改,说明内容进入了他的实际工作流。
- 用户导出、复制或保存了这份草稿。
第 3 条和第 4 条是区分“看过”和“用上”的关键。只生成不编辑、不保存,往往说明结果没有打动用户,这类试用计入完成会让后面的复盘数据失真。
2.2 选择免费试用可用的功能和边界
功能边界决定了完成任务需要调用哪些能力,也直接决定成本结构。试用期间开放的功能,应当刚好覆盖完成标准所需,不必把全部高级能力一起开放。
- 应该开放:澄清对话、草稿生成、基于对话的修改、导出或复制。这些是完成任务的必经步骤,缺一个用户就做不完。
- 可以限制:长文档上传、联网检索、多文档对比等高成本或非必需的能力。它们可以留到付费方案中作为升级理由。
- 需要设上限:单次输入长度、单份草稿的修改轮数。上限的作用是让成本可预测,而不是为难用户。
边界定好之后,就能列出完成一次任务的典型调用路径,第 3 节的成本测算就是沿着这条路径逐步累加的。
3. 按真实用量推算免费试用额度的补贴预算
这一节的核心公式只有一个:试用预算等于完成目标任务所需的调用成本乘以合理的试用任务数,其中调用成本要从实际样本中统计输入、输出、适用的缓存或工具费用以及重试。总体预算上限和额度用完时的提示,则由产品方另行设定。
3.1 从真实样本统计一次完成成本
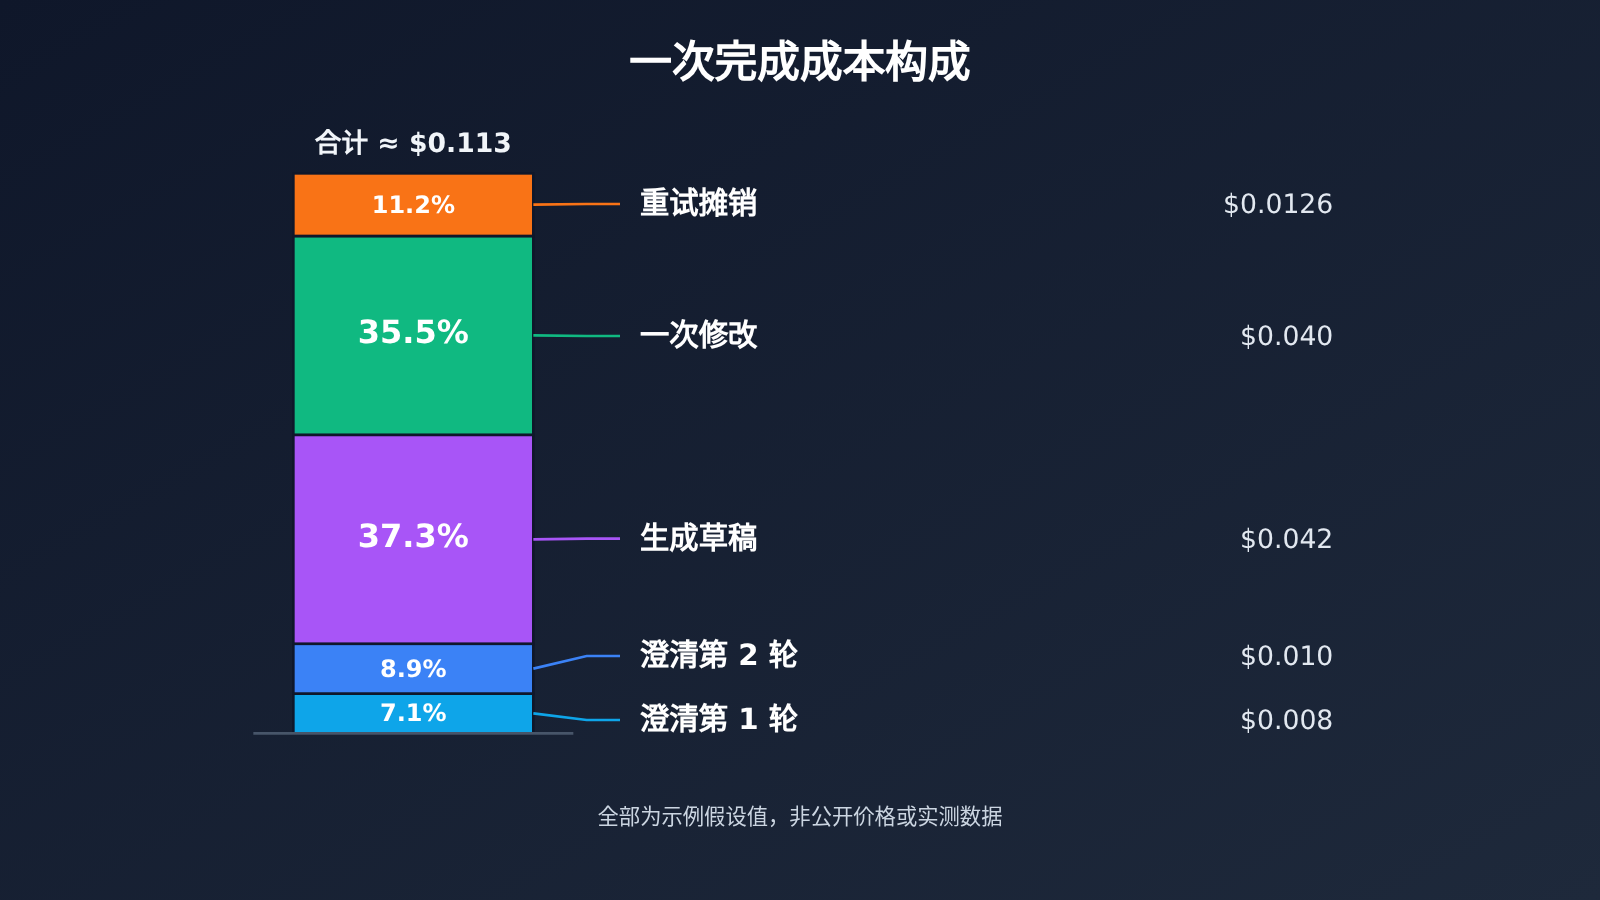
先强调口径:下表中的 token 数、重试率和单价全部是为演示计算而设的假设值,不是任何模型的公开价格,也不是实测数据。实际操作时,你应该用内部测试或灰度用户的真实调用日志替换这些数字。
如果你的模型调用经由聚合平台,可以对照平台公开的模型价格页和调用日志查询功能取数,例如 API易 的模型价格文档和日志查询文档。需要注意,这类平台只提供成本数据,试用政策本身仍由应用方设计。
示例假设:输入单价按每百万 token 2 美元计,输出单价按每百万 token 8 美元计,不使用联网等工具,缓存折扣按 0 计。
| 步骤 | 输入 token(假设) | 输出 token(假设) | 单次成本(美元) |
|---|---|---|---|
| 澄清对话第 1 轮 | 2,000 | 500 | 0.008 |
| 澄清对话第 2 轮 | 3,000 | 500 | 0.010 |
| 生成草稿 | 5,000 | 4,000 | 0.042 |
| 一次修改 | 10,000 | 2,500 | 0.040 |
| 小计 | 20,000 | 7,500 | 0.100 |
| 重试(假设 30% 的用户重新生成一次草稿) | — | — | 0.0126 |
| 一次完成成本 | — | — | 约 0.113 |
计算过程很直接:每一步的成本等于输入 token 乘输入单价,加上输出 token 乘输出单价。修改这一步的输入明显更大,是因为它要把之前的对话和整份草稿一起带上,这是多轮任务成本的常见特点。重试只计入最常发生的草稿生成步骤,按 0.042 美元乘以 30% 摊入。
3.2 从一次完成成本推到单账号和总预算
有了一次完成成本,再决定每个试用账号允许完成几次任务。示范中设为 3 次:第一次用来体验,后两次让用户在自己的真实项目上再用一用。这个次数同样是假设值,取决于你的用户通常需要几次才能形成判断。
| 预算项 | 计算方式 | 示例结果(假设) |
|---|---|---|
| 一次完成成本 | 来自 3.1 的样本统计 | 约 0.113 美元 |
| 单账号试用任务数 | 产品方根据用户决策习惯设定 | 3 次 |
| 单账号成本上限 | 一次完成成本 × 任务数 | 约 0.34 美元 |
| 预计月度新试用账号 | 来自获客计划 | 5,000 个 |
| 月度预算上限 | 单账号成本上限 × 账号数 | 约 1,690 美元 |
这里算出的是所有用户都用满额度时的上限。实际支出通常低于它,因为不少用户只用一两次就离开或直接付费。产品方可以在这个上限基础上设定总体预算,一旦实际支出明显超出预期,就说明出现了异常用量或者样本口径有问题,需要回到 3.1 重新核对。
3.3 可照填的免费试用额度预算表
把上面的步骤合并成一张空白模板,团队可以直接填入自己的数据:
| 填写项 | 你的数据 | 数据来源 |
|---|---|---|
| 最小完整任务名称 | 第 2 节的任务定义 | |
| 每步平均输入 token | 真实调用日志 | |
| 每步平均输出 token | 真实调用日志 | |
| 输入、输出单价 | 所用模型的公开价格页 | |
| 适用的缓存或工具费用 | 账单或价格文档 | |
| 常用重试比例及涉及步骤 | 埋点数据 | |
| 一次完成成本 | 以上各项汇总 | |
| 单账号试用任务数 | 产品决策 | |
| 预计试用账号数 | 获客计划 | |
| 总预算上限与超限处理方式 | 产品与财务共同决定 |
填完之后,对外展示的额度应当用“任务次数”而不是 token 或积分来表达,例如“试用期内可生成 3 份 PRD 草稿”。用户能直接理解额度能帮他做多少事,产品方内部再按成本上限做核算。
4. 免费试用额度用完时的清晰提示
额度用完的那一刻,是用户判断要不要付费的关键节点。提示做得模糊,用户会误以为产品出了故障;提示做得生硬,用户会觉得前面的体验只是诱饵。一个合格的提示应该包含三类信息:
- 已经得到什么:例如“你已完成 3 份 PRD 草稿,均已保存在项目中”,让用户确认试用成果仍然可用。
- 现在不能做什么:明确说明哪项操作需要额度,避免用户在操作中途才被拦下。
- 下一步有哪些选择:如继续使用免费计划中的基础功能、开通付费方案,或联系团队了解企业方案。
还有一个细节值得提前设计:尽量不要在任务做到一半时耗尽额度。可以在开始一次新任务前检查剩余额度是否足够完成它,不够就在开始前提示。这样用户感受到的是“我已经做完了几件事”,而不是“做到一半被打断”。
4.1 复盘免费试用额度:改体验还是改额度
试用上线后,用三个指标判断问题出在哪里:
- 首次有效任务完成率:按 2.1 的标准完整完成至少一次任务的试用用户占比,反映试用体验是否通畅。
- 每名完成者成本:试用总成本除以完成者人数,反映为每一个“感受到价值”的用户付出了多少补贴。
- 付费转化:完成者中最终付费的比例,反映价值是否足以支撑购买决策。
三个指标组合起来看,才能判断该调整什么:
| 数据表现 | 可能原因 | 调整方向 |
|---|---|---|
| 完成率低,每名完成者成本高 | 用户卡在任务中途,补贴花在没完成的人身上 | 改体验:简化步骤、优化引导、检查功能边界是否漏掉必需能力 |
| 完成率低,且大量用户在任务中途耗尽额度 | 单次任务成本被低估,额度不够完成一件事 | 改额度:用新样本重算一次完成成本,或缩小任务范围 |
| 完成率高,付费转化低 | 任务能完成,但价值不足以付费,或额度过多让用户无需升级 | 先检查任务价值,再考虑减少任务次数 |
| 完成率高,转化正常,每名完成者成本持续上升 | 重试变多或输入变长 | 回到 3.1 排查重试原因和上下文长度 |
判断的顺序建议先看完成率,再看成本,最后看转化。完成率不达标时调整额度通常没有意义,因为用户连一件事都没做完,多给额度只是放大浪费。等完成率稳定后,再用成本和转化去微调任务次数和总预算,然后回到第 2 节检查任务定义是否需要更新。
整套方法落地后,你应当能回答一个具体问题:每多一个真正感受到价值的试用用户,产品要花多少钱,这笔钱又带来了多少付费。能算清这笔账,免费试用额度就从一项难以控制的开支,变成了一个可以持续优化的获客环节。
千里之行,始于足下。——《老子》
参考资料
-
ChatPRD 创始人 Claire Vo 的复盘文章:关于 token 欺诈侵蚀 AI 利润及应对方式
- 链接:
chatprd.ai/how-i-ai/token-fraud-is-eating-ai-margins-here-s-how-claire-vo-is-fighting-it - 说明: 本文第 1 节案例事实的来源
- 链接:
-
ChatPRD 定价页:现行免费计划与 Pro、Teams 14 天试用信息
- 链接:
chatprd.ai/pricing - 说明: 用于确认该产品现行试用政策
- 链接:
-
API易 模型价格文档:各模型公开计价
- 链接:
docs.apiyi.com/models - 说明: 可用于查询单价,填写 3.3 预算表
- 链接:
-
API易 调用日志查询文档:调用记录与用量查询
- 链接:
docs.apiyi.com/api-capabilities/log-query - 说明: 可用于统计真实样本中的输入、输出 token 与重试情况
- 链接:


