
Примечание автора: Microsoft-Decision-1.1 официально доступен с 2026-11-17. Он только выбирает из заданных вами вариантов, ставит оценки или отвечает «да/нет» — длинные тексты он не пишет. В этой статье разберём, на каком шаге цепочки его имеет смысл поставить вместо прежней модели, по какому документу смотреть цену и почему цифры из поста нельзя просто так вписать в таблицу затрат.
Во время Microsoft Ignite TestingCatalog опубликовал пост — 2026-11-17. В тексте написано «MAI Decision 1», а на картинке — рейтинг Decision 1.1 от Artificial Analysis. Многие уже используют большие языковые модели для маршрутизации запросов, классификации тикетов, расстановки приоритетов и проверки результатов, и после этого поста у них возникло три вопроса: какую модель подключать, какой шаг она заменяет и можно ли опираться на «в 10 раз быстрее, в 200 раз дешевле» из поста.
Вывод: решения с фиксированным набором вариантов отдаём Microsoft-Decision-1.1, а генерацию длинных текстов оставляем большой языковой модели. В GA-документе Microsoft от 2026-11-17 объявлено, что модель официально доступна, а способ вызова описан в документации Microsoft Foundry. За основу берём GA-документ и официальную документацию, пост — только как зацепку.
Это не пересказ поста. В посте не сказано, с чем сравниваются эти кратные показатели; на картинке и во внутреннем кейсе Microsoft встречается «в 2,2 раза», но сравнивают там с разными вещами — разберём это отдельно. Мы 2026-11-18 проверили таблицу моделей и интерфейс ценообразования на APIYI apiyi.com, результат проверки — в разделе про цены.
Главное: после этой статьи вы сможете понять, какой шаг цепочки можно передать Microsoft-Decision-1.1, будете знать, по какому документу смотреть цену, и не станете тестировать ещё не существующий ID модели через неправильный эндпоинт.
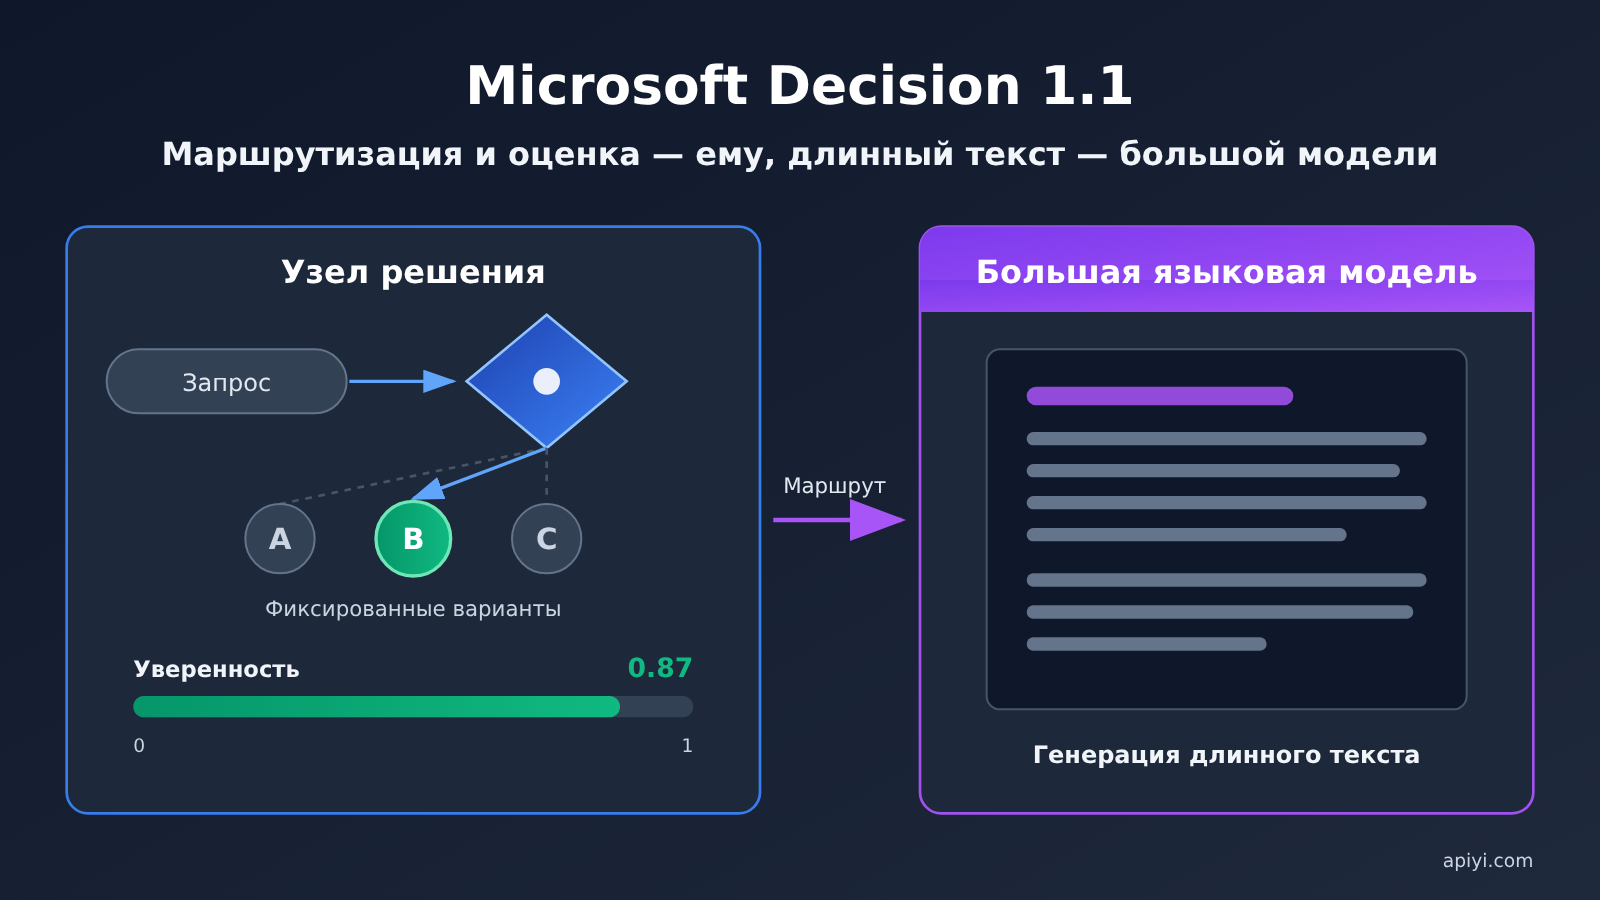
Ключевая информация о Microsoft Decision 1.1
Сначала отделим официальную информацию от пересказа публикаций. В таблице ниже — только то, что можно проверить по GA-статье Microsoft, Ignite Book of News и документации Foundry.
| Пункт | Детали |
|---|---|
| Дата официального релиза | 2026-11-17, объявлено в GA-статье Microsoft |
| Название модели | Microsoft-Decision-1.1 |
| Базовая модель | Gemma 4 26B A4B (формулировки в GA-статье и Ignite Book of News совпадают) |
| Назначение | маршрутизация, классификация, приоритизация, валидация, управление процессами |
| Принцип работы | выбирает из вариантов, заданных разработчиком, выдаёт калибруемую уверенность, при неопределённости может не принимать решение |
| По сравнению с первой версией | более чем двукратное ускорение, низкая цена сохраняется, добавлен ввод изображений |
| Официальные каналы | Microsoft Foundry, OpenRouter, Vercel AI Gateway |
| Статус в APIYI apiyi.com | при проверке 2026-11-18 модели нет ни в таблице моделей, ни в интерфейсе цен |
«Выбор из заданных вариантов» — это ключ к пониманию модели. Она не пишет абзацы и не объясняет причины, а только отвечает на вопросы, которые вы продумали заранее. Раньше такую работу часто выполняли большие языковые модели, теперь её можно поручить специализированной небольшой модели.
Microsoft-Decision-1.1 и Microsoft-Decision-1 — это не одна и та же модель
В тексте поста указана Decision 1, а на иллюстрации — Decision 1.1, поэтому легко принять обе версии за одну модель. На самом деле у них разные базовые модели и разное время выхода. Перед подключением убедитесь, какую именно версию вы собираетесь развернуть.
| Параметр сравнения | Microsoft-Decision-1 | Microsoft-Decision-1.1 |
|---|---|---|
| Дата выхода | 2026-10 | 2026-11-17, официально доступна |
| Базовая модель | Qwen3.5-9B | Gemma 4 26B A4B |
| Цена ввода (Foundry) | 0,042 USD / миллион токенов | Зонированная тарификация, см. таблицу цен ниже |
| Цена вывода | бесплатно | бесплатно |
| Ввод изображений | в материалах не упоминается | в описании GA указано, что добавлен |
| Каналы доступа | Foundry, OpenRouter | Foundry, OpenRouter, Vercel AI Gateway |
| Прочее | на странице OpenRouter указано контекстное окно около 33K | Microsoft утверждает, что модель более чем вдвое быстрее первой версии |
Если в октябре вы уже написали скрипт оценки под Microsoft-Decision-1, то при переходе на 1.1 придётся развернуть модель заново и изменить имя развёртывания. Базовые модели у версий разные, поэтому ранее настроенные пороги уверенности тоже нужно проверить заново.
Как вызывать Microsoft Decision 1.1: это не Chat Completions API
Именно здесь проще всего ошибиться. Согласно документации Microsoft Foundry, тип API у Microsoft-Decision-1.1 — Decision, а не привычный chat completions. Запрос отправляется по пути /providers/microsoft/v1/systemone на ресурсе Foundry, а в поле model в теле запроса указывается имя вашего собственного развёртывания, а не имя модели. При развёртывании выбирайте версию 1; тип развёртывания может быть GlobalStandard, а в некоторых регионах доступен и DataZoneStandard.
Он поддерживает всего три типа вопросов, возвращает ответ и вероятность, а свободный текст и обоснование не возвращает:
| Тип вопроса | Назначение | Что возвращается | Типичный сценарий |
|---|---|---|---|
noul |
Определить «да» или «нет» | Вероятность от 0 до 1 | Соответствует ли этот вывод требованиям, нужно ли отправлять этот документ на ручную проверку |
choice |
Выбрать один из фиксированных вариантов | Выбранный вариант | Какой нижестоящей модели отправить запрос, к какой категории отнести тикет |
score |
Оценить по шкале от низкого к высокому | Значение на шкале | Классификация по уровню срочности, оценка качества ответа |
Поэтому промпт вроде «Выбери один из трёх вариантов ниже и объясни почему», который вы раньше писали для большой языковой модели, при миграции нужно превратить в тип choice со списком вариантов, а часть с обоснованием просто выбросить. Если нижестоящему компоненту действительно нужен пояснительный текст для пользователя, поручите его генерацию большой языковой модели.
Цена Microsoft Decision 1.1: берём региональные цены из GA-документа Microsoft
Ниже — расценки из GA-документа Microsoft от 2026-11-17. Это цены Microsoft Foundry, а не APIYI.
| Регион развёртывания | Цена ввода (за миллион токенов) | Цена вывода |
|---|---|---|
| Global Standard | 0.042 долл. США | Бесплатно |
| US Data Zone | 0.046 долл. США | Бесплатно |
| EU Data Zone | 0.05 долл. США | Бесплатно |
| APAC Data Zone | 0.05 долл. США | Бесплатно |
В Ignite Book of News написано: «цена столь же конкурентная, как и у первой версии». Но только Global Standard совпадает с 0.042 доллара из первой версии, а цены всех трёх дата-зон выше. Поэтому при составлении таблицы затрат ориентируйтесь на региональные цены из GA-документа. Кроме того, вывод бесплатный, потому что модель возвращает только ответ и вероятность — сам вывод совсем короткий, и стоимость в основном зависит от того, насколько длинный контекст вы каждый раз подаёте.
Теперь о том, можно ли сейчас вызвать модель через APIYI. APIYI (apiyi.com) предоставляет единый OpenAI-совместимый интерфейс по адресу https://api.apiyi.com/v1 — это интерфейс chat completions. Модель Decision использует другой интерфейс, который возвращает только ответ и вероятность, поэтому даже если её добавят в каталог, нельзя будет подставить ID модели в обычный запрос чата для проверки. Мы проверили список моделей и интерфейс цен APIYI 2026-11-18: тогда в нём было 283 модели, и среди них не было Microsoft-Decision-1, Microsoft-Decision-1.1 и вообще ни одного ID, связанного с decision. Из моделей с пометкой MAI в списке были только модели изображений MAI-Image-2.6 и MAI-Image-2.6-Flash — это не тот же продукт, что эта decision-модель. Пока модель не добавлена — мы как можно скорее её добавим; актуальные модели и цены смотрите в списке моделей платформы.
Как читать числа в этом посте: три группы множителей и три разных объекта сравнения
В посте TestingCatalog упоминаются «в 10 раз быстрее, в 200 раз дешевле», плюс ещё два «в 2.2 раза». Один множитель 2.2 — из графика рейтинга, второй — из внутреннего кейса Microsoft. Объекты сравнения у них разные, складывать всё в одну фразу нельзя.
| Число | Откуда | Объект сравнения | Можно ли внести в таблицу затрат |
|---|---|---|---|
| в 10 раз быстрее, в 200 раз дешевле | текст поста TestingCatalog | обобщённая модель без названия, в GA-статье соответствующего сравнения нет | нельзя |
| оценка 68, на 6 баллов выше Decision 1, в 2.2 раза быстрее | иллюстрация к посту, то есть график рейтинга Artificial Analysis | Microsoft-Decision-1 | только как справка по рейтингу |
| в 2.2 раза быстрее, стоимость примерно 1/4.4 от стоимости конкурента | GA-статья Microsoft, внутренний кейс Copilot | одна большая языковая модель | только как утверждение самой Microsoft |
Часть про рейтинг — это пересказ Microsoft рейтинга Artificial Analysis Decision Index v2.1. По этому пересказу Microsoft-Decision-1.1 получает 68 баллов: на 6 баллов больше, чем первая версия, и больше, чем у Jev 1.14, Google Gemini Decision 1 и OpenAI GPT-6 Luna (Decisions). В GA-статье при этом написано «более чем в два раза быстрее первой версии при той же стоимости». Это официально пересказанные результаты рейтинга, а не наши тестовые данные. Место в рейтинге тоже не равно сумме, которую вы в итоге заплатите.
Пример с Copilot — совсем другая история. В Copilot Microsoft использует эту модель, чтобы решить, передать запрос в Copilot или в Cowork: точность сопоставима с одной большой языковой моделью, скорость в 2.2 раза выше, а стоимость составляет примерно 1/4.4 от стоимости той большой языковой модели. Здесь множитель 2.2 относится к «одной большой языковой модели», а на иллюстрации 2.2 раза — это сравнение с Decision 1. Просто числа случайно совпали.
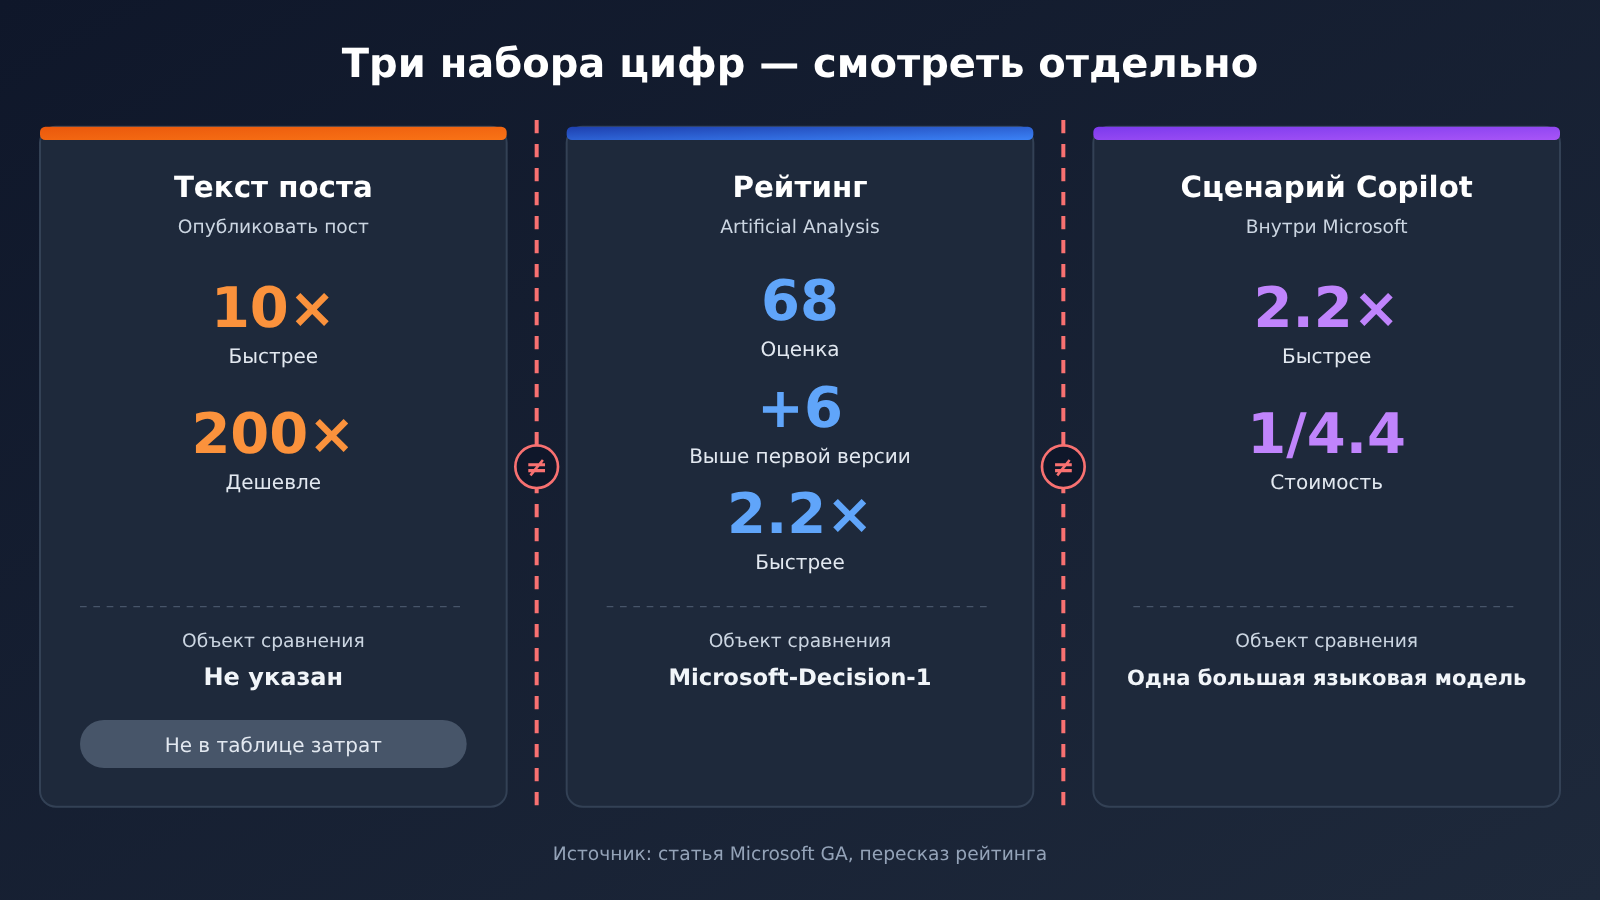
На схеме выше три группы чисел разнесены по отдельным блокам. Источники данных — GA-статья Microsoft и пересказ графика рейтинга; материал подготовила техническая команда APIYI apiyi.com, результатов собственных тестов здесь нет.
Анализ влияния Microsoft Decision 1.1
Для разработчиков: маршрутизацию и скоринг — ему, длинные тексты — большой языковой модели
Если вы уже используете большую языковую модель для маршрутизации, классификации, расстановки приоритетов и валидации, то теперь можно заменить именно шаг «принятия решения», а шаг генерации контента остаётся прежним. Microsoft-Decision-1.1 даёт ответ и уверенность только в рамках фиксированного набора вариантов — это и определяет, куда его лучше встроить. При интеграции можно разбить процесс в таком порядке:
- Составьте список допустимых вариантов: замените в исходном промпте формулировку «определи…» на явный перечень вариантов, например названия моделей ниже по цепочке, категории тикетов, уровни риска. Если варианты не получается перечислить, значит, этот шаг пока рано передавать ему.
- Выберите тип задачи: для вопросов «да/нет» используйте
noul, для выбора одного варианта из нескольких —choice, для оценки по шкале —score. Не пытайтесь заставить его выдать связный текст. - Задайте порог уверенности: модель возвращает калибруемую уверенность и может вообще не принимать решение. Результаты выше порога выполняются сразу, ниже порога — уходят в резервный сценарий.
- При неуверенности возвращайте человеку или большой языковой модели: запросы с низкой уверенностью отправляйте на ручную проверку либо на повторное решение большой языковой модели. Этот шаг нужно прописать в процессе, его нельзя опускать.
- Пояснения и тексты — большой языковой модели: ответы пользователям, длинные тексты, код и объяснения генерирует большая языковая модель. Decision-модель отвечает только за то, кто будет это писать и по какому пути пойдёт запрос.
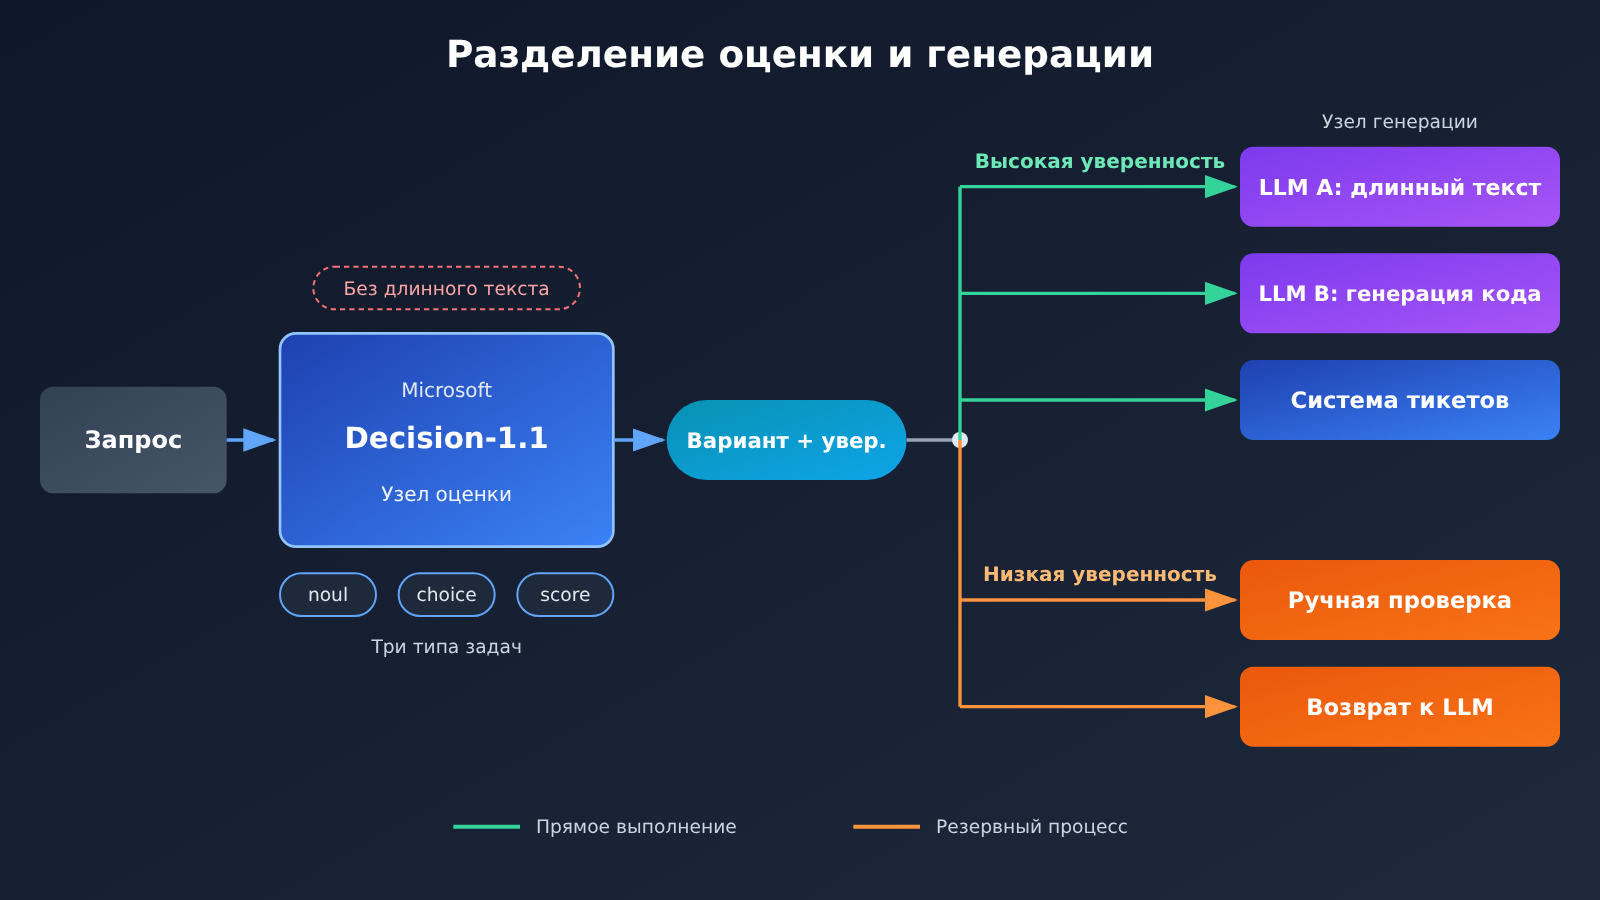
Если разбить процесс в таком порядке, зона ответственности узла решения и узла генерации разделяется, и искать проблемы становится проще: ошиблась маршрутизация — проверяйте узел решения; плохо написан текст — проверяйте большую языковую модель. Сторону большой языковой модели менять не нужно: диалоговая модель, которую вы раньше вызывали через APIYI apiyi.com, по-прежнему может генерировать длинные тексты.
Влияние на существующий пайплайн: какие шаги можно заменить
Не все «решения» подходят для переноса. Ниже кратко по типичным сценариям:
- Подходят для переноса: маршрутизация запросов между разными моделями, классификация обращений в поддержку, определение, нужна ли ручная проверка контента, приоритизация по срочности, проверка соответствия формата вывода. Везде фиксированный набор вариантов, и результат можно напрямую использовать в коде.
- Переносить с осторожностью: классификация с большим числом часто меняющихся вариантов, решения, требующие учёта большого контекста. В первой версии OpenRouter указывает контекст около 33K; точную длину контекста в 1.1 смотрите в документации Foundry — слишком длинный ввод нужно сначала обрезать или сжать в краткое резюме.
- Не подходят для переноса: заключения проверок, где нужно обоснование, тексты, которые нужно переписать или дописать, открытые вопросы и ответы. Это по-прежнему работа для большой языковой модели.
Ещё один момент: модель возвращает только ответ и вероятность, поэтому в логах и записях аудита, где раньше большую модель «заодно» просили дать обоснование, этой части не будет. Если по требованиям соответствия обоснование нужно хранить, можно вызвать большую модель ещё раз только для выборок с низкой уверенностью или для отклонённых — так не придётся каждый раз оплачивать длинные пояснения.
Влияние на отрасль: специализированные малые модели берут на себя часть решений
Из этого релиза видно направление: запросы на принятие решений выделяют из универсальных больших моделей и передают специализированным малым моделям. Названия конкурентов из поста, а также Google Gemini Decision 1 и OpenAI GPT-6 Luna (Decisions) в таблице лидеров говорят о том, что это уже отдельная категория.
Для разработчиков это означает два изменения:
- Структура затрат: запросы на принятие решений тарифицируются по входу, выход бесплатный, а стоимость в основном определяется длиной промпта. Экономия на сокращении контекста теперь заметнее, чем раньше.
- Оценка: узлы принятия решений нужно оценивать отдельно — по точности и калибровке уверенности, а не только по тому, насколько хорош итоговый ответ. Баллы из таблицы лидеров подходят для первичного отбора, но в конце всё равно нужно проверять на собственных бизнес-примерах.
Команды, которые хотят сначала сравнить эффект на стороне больших моделей, могут использовать единый интерфейс APIYI apiyi.com и переключаться между разными диалоговыми моделями. Когда узел принятия решений заработает в Foundry, можно будет объединить обе части.
Microsoft Decision 1.1: ключевые тезисы (Key Takeaways)
- Не смешивайте версии: в основе 1.1 лежит Gemma 4 26B A4B, а в основе октябрьской Decision 1 — Qwen3.5-9B.
- Только решения с вариантами: маршрутизацию, классификацию, приоритизацию и проверку можно поручить ей, а длинные тексты по-прежнему генерирует большая модель.
- Три типа заданий:
noul,choice,score— возвращают только ответ и вероятность, без обоснования. - Вызов идёт по другому пути: запросы отправляются на
/providers/microsoft/v1/systemone, в полеmodelуказывается имя развёртывания. - Цены — в статье о GA: входная цена в Foundry — от 0.042 до 0.05 доллара за миллион токенов, выход бесплатный.
- Множители из поста не попадают в таблицу затрат: у 10× и 200× не указан объект сравнения, а два множителя 2.2× тоже стоит рассматривать по отдельности.
- Статус APIYI: на 2026-11-18 в таблице моделей APIYI apiyi.com нет этого ID — не тестируйте через чат-интерфейс.
Итог
Позиционирование Microsoft-Decision-1.1 вполне однозначное: это узел принятия решений в цепочке, а не инструмент для написания текстов.
- Назначение: маршрутизация, классификация, оценка и проверка среди вариантов, заданных разработчиком, с выдачей уровня уверенности; при неуверенности модель может не принимать решение.
- Границы: не пишет свободный текст, не пишет обоснования. Длинные тексты, код и объяснения по-прежнему остаются за большой языковой моделью, а результаты с низкой уверенностью передаются человеку или большой модели для подстраховки.
- Основание для расчёта стоимости: региональные цены Foundry от 2026-11-17 из GA-публикации Microsoft. Множители и места в рейтингах из постов нельзя считать котировкой.
Советую для начала выбрать один шаг принятия решения с фиксированными вариантами и полными логами, проверить на Foundry на собственных образцах точность и пороги, а потом решать, расширять ли охват. На стороне генерации контента можно продолжать вызывать разные диалоговые модели через APIYI apiyi.com. Наличие модели Decision в каталоге платформы уточняйте в списке моделей.
📚 Справочные материалы
-
Официальное объявление о доступности Microsoft-Decision-1.1: GA-публикация, включающая назначение, региональные цены, пересказ рейтингов и внутренние кейсы Copilot
- Ссылка:
aka.ms/decision-model-ga - Пояснение: цены и официальные заявления о производительности в этой статье основаны именно на этом источнике
- Ссылка:
-
Microsoft Ignite 2026 Book of News: базовая модель и формулировки о ценах
- Ссылка:
news.microsoft.com/events/ignite/2026/book-of-news/ - Пояснение: базовая модель — Gemma 4 26B A4B, детальные цены по-прежнему берутся из GA-публикации
- Ссылка:
-
Документация Microsoft Foundry: использование модели Microsoft Decision: развёртывание и способы вызова
- Ссылка:
learn.microsoft.com/en-us/azure/foundry/foundry-models/how-to/use-foundry-models-microsoft-decision - Пояснение: официальное описание типов Decision API, путей запросов и трёх типов задач
- Ссылка:
-
Статья о выпуске Microsoft-Decision-1 (2026-10): информация о предыдущей версии
- Ссылка:
commandline.microsoft.com/microsoft-decision-1-model-foundry - Пояснение: помогает отличать Decision 1 от 1.1
- Ссылка:
-
Страница модели на OpenRouter: страницы сторонней интеграции обеих версий
- Ссылка:
openrouter.ai/microsoft/microsoft-decision-1.1 - Пояснение: на первой версии страницы указан контекст около 33K
- Ссылка:
-
Пост TestingCatalog: отправная точка этого обсуждения
- Ссылка:
x.com/testingcatalog/status/2122759893174178173 - Пояснение: это пересказ, множители из него не являются основанием для расчёта цены
- Ссылка:
Автор: техническая команда APIYI
Техническое обсуждение: добро пожаловать, свяжитесь с нами на главной странице сайта APIYI, больше материалов — в центре документации docs.apiyi.com


